Titre original : HarnessMM: Recursive Self-Improvement for Harness Token Efficiency
Auteurs : Yuhua Jiang, Chang Xu, Feifei Gao et Li Zhao (université Tsinghua et Microsoft Research Asia)
Publication : prépublication arXiv 2610.32813v1 (cs.AI), déposée le 23 octobre 2026, 8 pages de texte principal et 37 pages avec les annexes.
Liens : page arXiv, PDF.
L’idée en bref
Un harnais d’agent, c’est la boucle qui relie le modèle aux outils : il appelle le modèle, exécute l’action choisie, renvoie le résultat au modèle, et recommence. Les auteurs partent d’un constat simple : très souvent, le modèle a déjà décidé la suite avant même de voir le résultat. Quand un agent de code écrit un programme, il sait déjà qu’il faudra le compiler, puis lancer les tests si la compilation passe. Rappeler le modèle à chaque étape pour qu’il redise la même chose coûte des jetons pour rien.
HarnessMM (pour « Harness Minus Minus ») se glisse entre le modèle et les outils sans toucher aux poids du modèle ni aux outils. Quand le modèle raisonne, il écrit aussi un petit graphe de décisions futures : l’action exacte, ses arguments littéraux, l’étape dont elle dépend et une condition vérifiable sur le résultat (par exemple « la compilation a réussi »). Les auteurs appellent ce graphe un Executable Decision Graph. À chaque résultat d’outil, un contrôleur regarde si une décision stockée remplit sa condition. Si oui, il l’exécute directement et enregistre un certificat qui prouve qu’un appel au modèle a été évité. Si la situation est nouvelle, si la preuve manque ou si le petit sélecteur s’abstient, la main revient au modèle (sections 1 et 4, p. 1 à 4).
Autour de ce mécanisme, une boucle d’« auto-amélioration récursive » ajuste la configuration du harnais (consignes, gestion du contexte, règles de fin) à partir des résultats d’entraînement, puis la fige avant le test.
Ce que montre le papier
Un piège de comptabilité bien identifié
Les auteurs nomment « paradoxe de substitution » une erreur fréquente : ajouter un petit modèle rapide qui choisit l’action ne fait rien gagner s’il n’empêche pas l’appel au gros modèle qui suit. Le coût devient alors celui du gros modèle plus celui du petit. Le papier compte donc tout, tâche par tâche : rédaction du graphe, appels de sélection, appels restants, reprises après échec et exécutions ratées, y compris l’entrée mise en cache (sections 3.3 et 4.4, p. 3 et 4).
Des gains nets sur deux harnais du marché
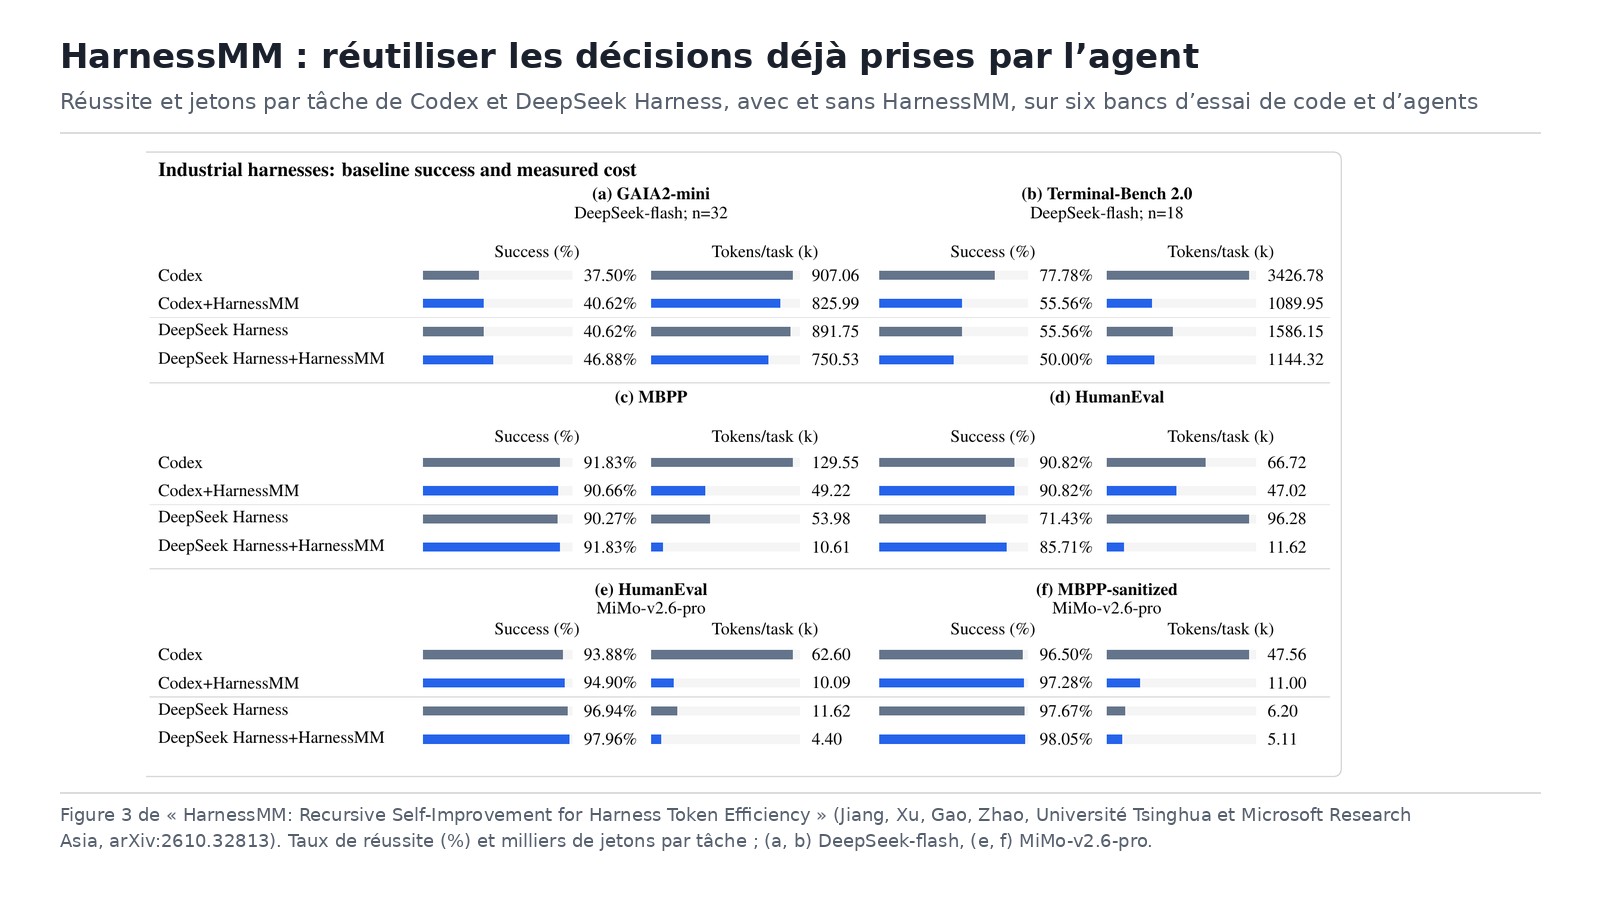
Sur les mêmes 98 tâches de test HumanEval, avec le même modèle pour chaque paire, Codex garde 90,82 % de réussite et passe de 66,72 à 47,02 milliers de jetons par tâche, soit 29,54 % d’économie. DeepSeek Harness monte de 71,43 % à 85,71 % de réussite et descend de 96,28 à 11,62 milliers de jetons, soit 87,93 % d’économie. Ses appels au modèle tombent de 954 à 415, avec 147 appels remplacés par une exécution certifiée. Sur 257 tâches MBPP, DeepSeek Harness passe de 90,27 % à 91,83 % et de 53,98 à 10,61 milliers de jetons (tableau 1 et section 5.3, p. 5).
Le mécanisme lui-même, isolé
Pour séparer la réutilisation des autres réglages, les auteurs comparent quatre variantes sur 257 tâches MBPP. HarnessMM complet atteint 93,77 % pour 13,17 milliers de jetons par tâche. Jeter le graphe après une seule utilisation coûte 18,03 milliers de jetons pour 93,00 % : garder les décisions économise 26,91 % (intervalle de 4,01 % à 45,57 %). Garder l’appel au modèle tout en exécutant le graphe coûte 16,37 milliers de jetons, soit 19,52 % de plus. Sans exécution de graphe du tout, la réussite est un peu meilleure (95,33 %) pour 16,19 milliers de jetons (section 5.5 et figure 4, p. 7 et 8).
Des études annexes plus contrastées
Sur six autres bancs d’essai, avec des modèles Qwen de 9 et 27 milliards de paramètres, la configuration HarnessMM obtient la meilleure réussite sur ALFWorld (66,20 % pour 31,12 milliers de jetons, contre 63,29 % pour 101,33 avec SkillOpt), SearchQA et LiveMath. Sur AIME, elle coûte 28,34 % de jetons de plus que l’agent de base pour une précision presque identique (87,14 % contre 86,96 %). Sur GAIA2, elle consomme moins mais reste à 43,96 % de réussite, 2,92 points sous SkillOpt (section 5.4 et figure 2, p. 6 et 7).
Une boucle d’amélioration qui converge vite
Sur 32 tâches de navigation web MiniWoB++, huit itérations font passer la réussite de 34,38 % à 90,63 % et le coût de 3,26 à 1,06 millier de jetons par tâche (section 5.6, p. 8).
Les limites
Les auteurs reconnaissent que (section 6, p. 8) :
- les économies dépendent de la façon dont chaque fournisseur compte l’entrée, le cache et le contexte, et de l’existence d’actions déjà décidées ;
- toute décision nouvelle exige encore le modèle, et la rédaction du graphe, la sélection et les reprises peuvent coûter plus que les appels évités ;
- les adaptateurs qui lisent l’état public sont propres à chaque tâche, et les petits jeux de développement laissent une incertitude sur la qualité ;
- une économie de jetons ne prouve ni une baisse de latence ni une économie d’énergie, qu’il faudrait mesurer à part (section 4.4, p. 5).
Réserves de notre lecture, tirées du papier :
- Les meilleurs chiffres mélangent plusieurs leviers. Le papier précise lui-même que les résultats sur Codex et DeepSeek Harness combinent réutilisation des décisions, gestion du contexte et règles de fin (section 5.3). Le bond de DeepSeek Harness part d’ailleurs d’un point bas : avec le même modèle, il ne réussissait que 71,43 % des tâches contre 90,82 % pour Codex, et l’essentiel de la baisse vient des jetons d’entrée (92,45 à 7,09 milliers par tâche, annexe F.1).
- Pour Codex sur HumanEval, la réussite stable cache cinq tâches gagnées et cinq perdues.
- Sur les mesures de développement Terminal-Bench 2.0 (18 tâches, DeepSeek-flash), Codex avec HarnessMM tombe de 77,78 % à 55,56 % de réussite, même s’il divise son coût par trois (figure 3, p. 7).
- Les bancs d’essai de code (HumanEval, MBPP) sont des fonctions courtes, où la suite « écrire, compiler, tester » se prévoit bien. Rien ne garantit des gains aussi forts sur des tâches longues et ouvertes, comme le suggèrent les résultats GAIA2.
- Le papier ne donne pas de lien vers son code, et la page arXiv n’en mentionne pas.
Lecture Neurone21
Ce papier parle aux équipes qui paient des agents de code à l’usage. Le message est très concret : avant de changer de modèle, comptez combien d’appels de votre harnais servent seulement à confirmer une décision déjà prise. Dans une chaîne « écrire le fichier, lancer la compilation, lancer les tests », la deuxième et la troisième étape n’ont souvent besoin que d’une vérification mécanique du résultat précédent, pas d’un nouveau raisonnement. Une règle écrite en dur, du type « si le code de retour vaut 0, lancer pytest », remplace alors un appel complet au modèle, avec tout le contexte qu’il faut lui renvoyer.
La partie la plus utile est peut-être la discipline de mesure. Ajouter un petit modèle rapide pour décider, sans supprimer l’appel au gros, augmente la facture : le papier le montre et compte tout, échecs compris. Pour une PME qui industrialise des agents, c’est une bonne grille d’audit : un tableau de bord des appels par tâche, des appels évités et des reprises vaut mieux qu’une impression de vitesse. Ce travail prolonge nos fiches sur le harnais appris de CMU, sur la compression du contexte des agents de code et sur le harnais auto-amélioré sur ARC-AGI-3. Il faut toutefois garder en tête qu’un même réglage peut faire baisser la réussite sur des tâches plus longues, comme sur Terminal-Bench.
Elvis Saravia cite fidèlement les chiffres principaux : 96,28 à 11,62 milliers de jetons et 71,43 % à 85,71 % pour DeepSeek Harness, 90,82 % et 29,54 % d’économie pour Codex. Son post attribue ces gains au seul fait de mettre en cache les décisions, alors que le papier précise qu’ils combinent aussi la gestion du contexte et les règles de fin ; l’effet propre de la réutilisation, mesuré sur MBPP, est de 19,52 % à 26,91 % d’économie. Le post ne mentionne pas non plus les cinq régressions de Codex sur HumanEval, la baisse de réussite sur Terminal-Bench 2.0 ni le surcoût sur AIME.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.32813
- Le PDF : https://arxiv.org/pdf/2610.32813v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2114732037827662278
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/harnessmm-recursive-self-improvement-for-harness-token-efficiency-2610.32813