Titre original : Towards Foundation Decision Models: Drex
Auteurs : Nischay Dhankhar, Alisher Amantay, Zhanibek Datbayev, Darkhan Akhmetov, Yash Shah, Nurmukhamed Ubaidullayev, Raman Saparkhan, Dos Baha et Abulhair Saparov.
Affiliations : équipe de recherche Nace.AI.
Publication : rapport technique, prépublication arXiv 2611.07854v1 (cs.CL), déposée le 5 novembre 2026, 51 pages avec annexes.
Liens : page arXiv, PDF, poids et code, Drex Max sur Hugging Face. Max, v2.0 et v1.5 sont sous licence Nace.AI Open RAIL-M, DLM sous CC BY-NC 4.0, le code sous Apache-2.0.
L’idée en bref
Beaucoup de tâches en production sont des choix : classer un dossier, dire oui ou non, noter sur une échelle. Demander à un grand modèle de rédiger sa réponse puis l’analyser coûte cher, prend du temps et donne des réponses qui changent d’une fois à l’autre. Un « modèle de décision » reçoit un état (un document, un dossier, le contexte d’un agent, éventuellement une image), une ou plusieurs questions et la liste des options fournie par l’utilisateur. Il renvoie directement une probabilité par option, sans générer de texte.
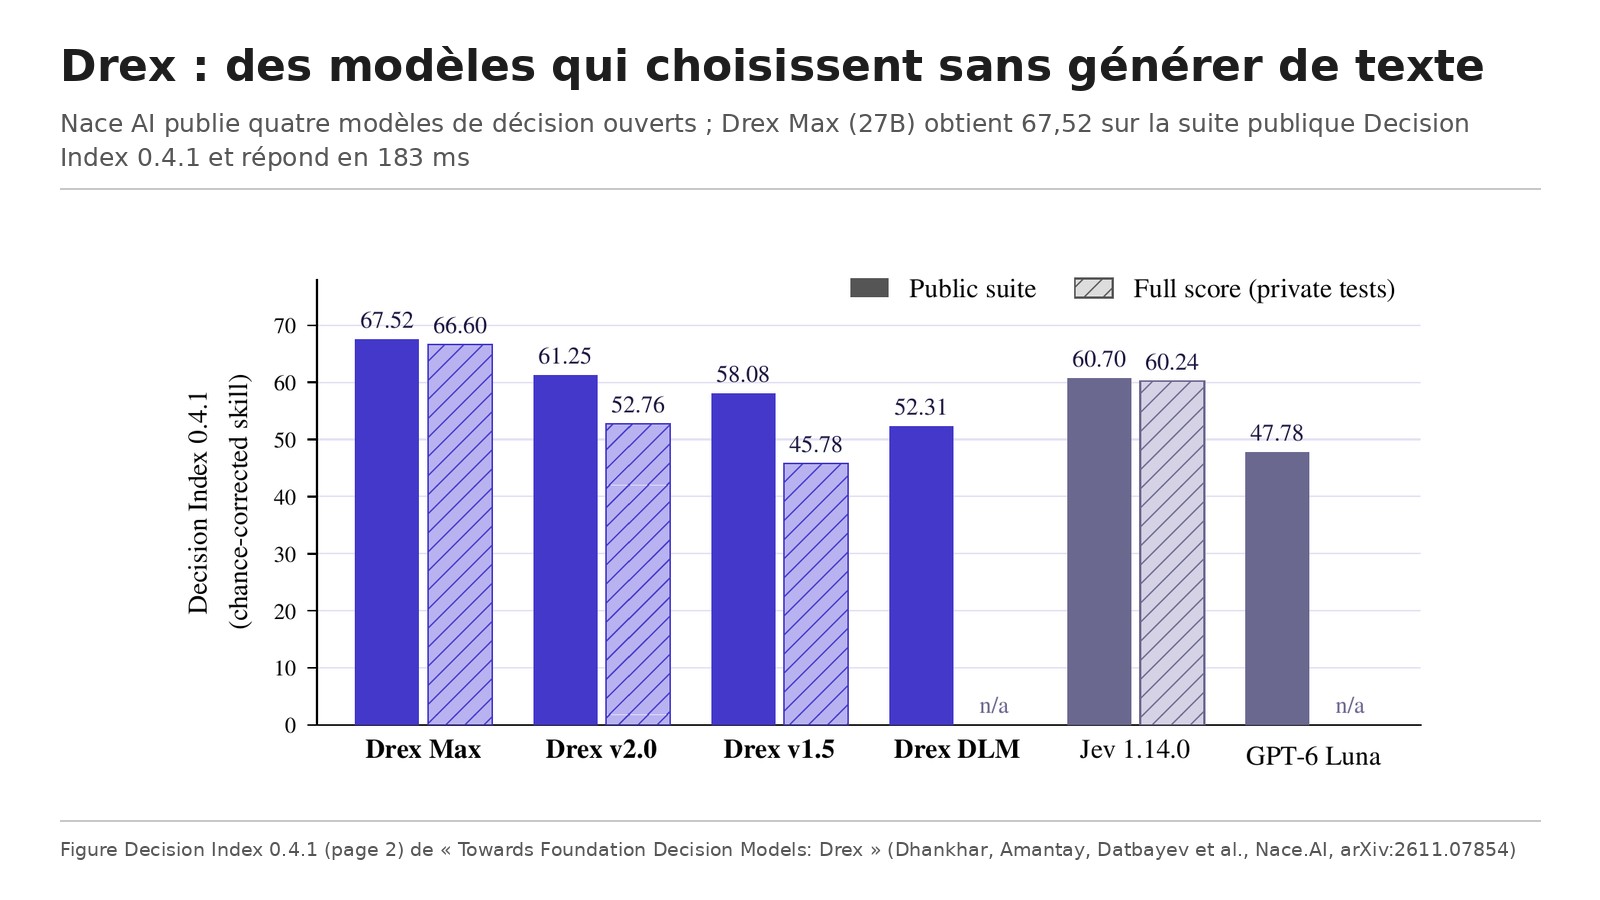
Drex compte quatre modèles : DLM (8B), v1.5 (9B), v2.0 (35B dont 3B actifs) et Max (27B). Les trois premiers sont des modèles « à pointeur » qui encodent le contexte une seule fois pour plusieurs questions. Max est un modèle multimodal dense à attention complète, qui relit le contexte pour chaque question et lit la réponse sur une tête dédiée, jusqu’à 255 options.
Ce que montre le papier
Des scores proches des grands modèles généralistes
Sur la suite publique Decision Index 0.4.1, Drex Max obtient 67,52, contre 60,70 pour Jev 1.14.0, le meilleur modèle de décision concurrent du classement. Sur l’Artificial Analysis Decision Index, mené indépendamment, il est deuxième parmi les modèles de décision (64 contre 65). Sur Decision Bench v4 (1 071 décisions issues de 36 jeux de données publics), Max fait 94,0 % de précision avec son encodeur d’image, contre 95,6 % pour Claude Opus 5.5, 94,7 % pour GPT-6 Sol et 93,7 % pour d3-turbo : statistiquement à égalité avec ces deux derniers, à 1,6 point d’Opus.
Beaucoup plus rapide et moins cher
Mesurée depuis une machine de test dans l’Oregon, la latence médiane d’une requête est de 183 ms pour Max, contre environ 2,0 s pour GPT-6 Sol et 3,5 s pour Claude Opus 5.5. Le coût annoncé pour 1 000 décisions est de 0,06 dollar pour Max, contre 3,33 dollars pour GPT-6 Sol et 10,17 dollars pour Opus 5.5.
Un entraînement qui vise la calibration et la stabilité
Après le fine-tuning supervisé, l’entraînement ajoute le RLAF : des récompenses vérifiables, ajustées par les probabilités qu’un modèle juge attribue à chaque option, sous une pénalité qui empêche de trop s’éloigner du modèle de départ. Le modèle apprend ainsi sur des cibles calibrées plutôt que sur une seule bonne réponse. Dans l’ablation sur Max, le RLAF ajoute 2,0 points au Decision Index et 1,5 point de précision. Les termes de cohérence de la perte font passer de 6,3 % à 4,2 % la part de décisions qui changent quand on réordonne les options.
Les limites
- Pas de connaissance encyclopédique : tous les modèles Drex restent derrière les grands modèles conversationnels sur les questions de connaissance sans document ;
- comparaisons mêlées : les systèmes du classement diffèrent à la fois par la base, les données, l’objectif et l’inférence, ce que les auteurs signalent eux-mêmes ;
- benchmarks de niche : Decision Index, Decision Bench et JevBench forment un écosystème jeune, propre aux modèles de décision ;
- régressions ponctuelles : Max fait nettement moins bien que v2.0 sur certains bancs, comme la prédiction d’accords musicaux POP909-CL (de 79,5 à 55,6) ;
- auteurs juges et parties : le rapport est écrit par l’éditeur des modèles.
Lecture Neurone21
Drex illustre une tendance utile pour les entreprises : ne pas faire rédiger un grand modèle quand on attend un choix. Trier des tickets, vérifier qu’un document respecte une règle, décider si un agent a fini sa tâche, tout cela tient en une liste d’options. Une probabilité par option, calibrée et stable, se branche directement dans un workflow, avec un seuil de confiance au-dessous duquel on renvoie le cas à un humain.
L’écart de coût annoncé, plus de 150 fois moins cher qu’Opus 5.5 pour 1 000 décisions, mérite d’être vérifié sur ses propres données. Mais l’idée est simple à tester : prendre cent décisions réelles déjà tranchées, les passer au modèle de décision et au grand modèle, et comparer précision, latence et facture.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 6 novembre 2026 (13:16 UTC, 14:16 heure de Paris), puis l’a republié le 7 novembre. Nous avons lu la version officielle arXiv 2611.07854v1. Écarts avec le post :
Le post écrit que le modèle « répond en 183 ms au lieu de 3,5 s » : ces chiffres viennent du tableau de latence d’une requête simple, mesurée au lancement du modèle, réseau compris ; sur Decision Bench v4, le temps médian de bout en bout mesuré par le client est de 0,66 s pour Max contre 4,33 s pour Opus 5.5. Le post décrit le RLAF comme un enseignant qui propose une probabilité ajustée par la bonne réponse : le rapport le formule comme des récompenses vérifiables ajustées par les probabilités d’un modèle juge, ce qui revient à la même idée. Les autres chiffres cités (67,52 contre 60,70, 1,6 point, 2,0 points, 6,3 % à 4,2 %, les quatre tailles) correspondent au papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.07854
- Le PDF : https://arxiv.org/pdf/2611.07854
- Les poids et le code d’inférence : https://github.com/nace-ai/drex-decision-models
- Drex Max sur Hugging Face : https://huggingface.co/nace-ai/drex-max-v1
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2118693892300439722
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/towards-foundation-decision-models-drex-2611.07854