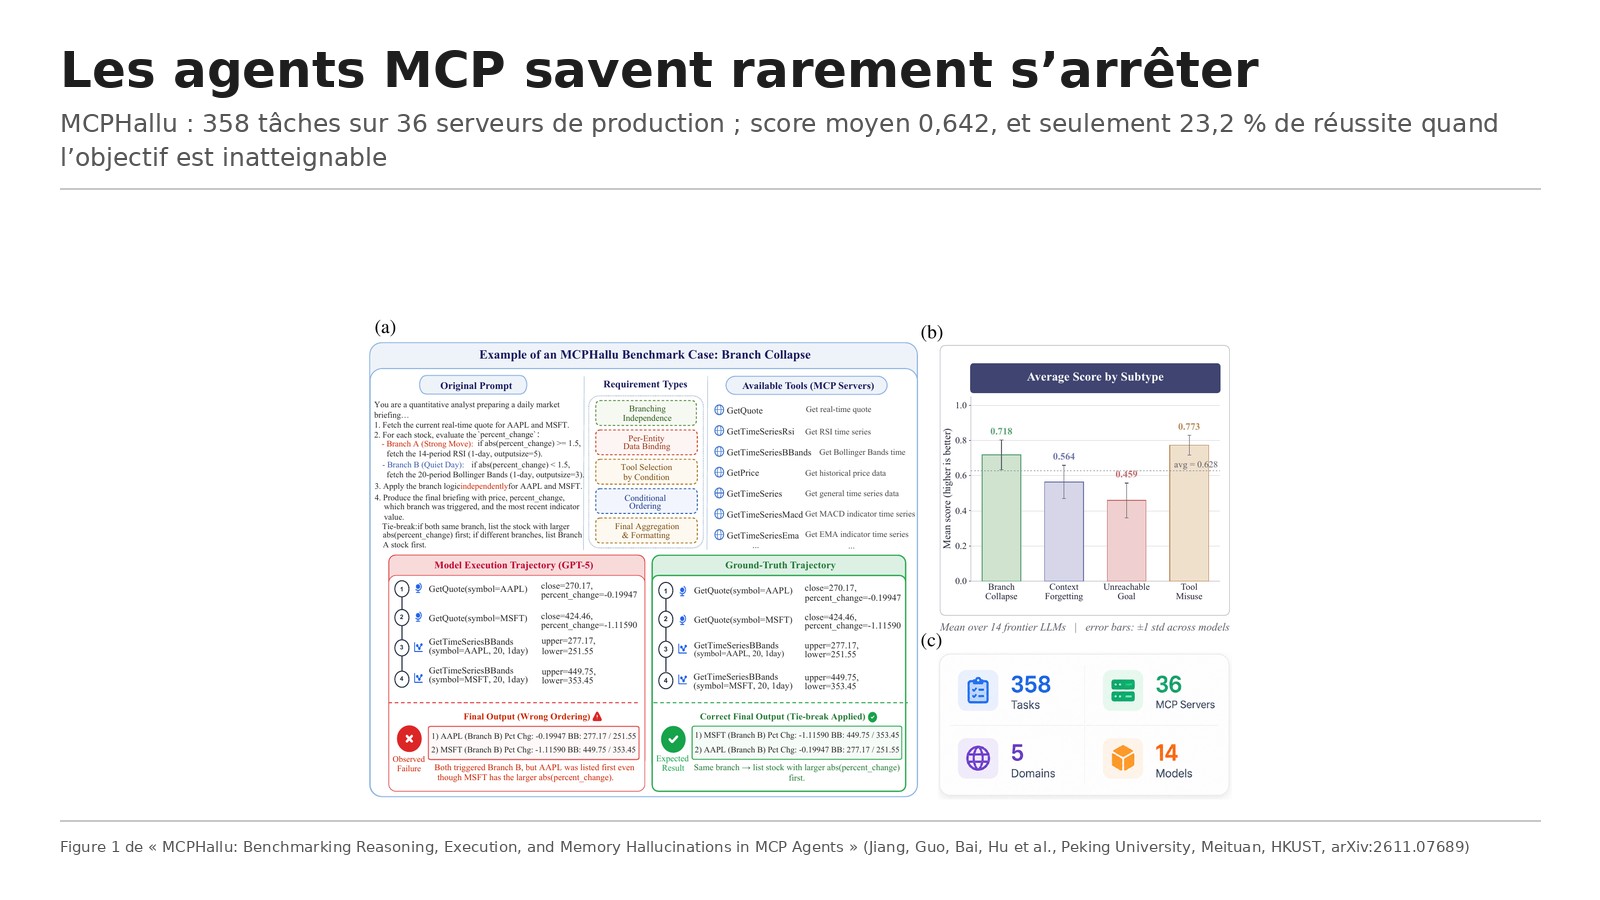
Titre original : MCPHallu: Benchmarking Reasoning, Execution, and Memory Hallucinations in MCP Agents
Auteurs : Yizhen Jiang, Haowei Guo, Tianyi Bai, Zengjie Hu, Lu Ma, Zhengyang Zhao, Haoze Sun, Peng Pei et Wentao Zhang. Jiang, Guo et Bai sont premiers auteurs à parts égales ; Pei et Zhang sont les auteurs correspondants.
Affiliations : Peking University, Zhongguancun Academy, Meituan, The Hong Kong University of Science and Technology, et Beijing Key Laboratory of Data Intelligence and Security (Peking University). Une partie du travail de Jiang et Guo a été menée pendant leurs stages chez Meituan.
Publication : prépublication arXiv 2611.07689v1 (cs.AI), déposée le 5 novembre 2026, 38 pages avec annexes.
Liens : page arXiv, PDF. Les auteurs annoncent le dépôt du banc d’essai à https://github.com/J1zz/mcp_hallu.
L’idée en bref
Les bancs d’essai MCP mesurent surtout si une tâche est terminée. Ils disent peu pourquoi un agent a échoué, et souvent seulement après coup. MCPHallu construit chaque tâche autour d’un déclencheur qui rend dominant l’un de quatre types d’hallucination : suivre la mauvaise branche d’une règle (Branch Collapse), refuser d’admettre qu’un objectif est hors de portée (Unreachable Goal), prendre un outil au schéma proche mais au sens différent (Tool Misuse), ou oublier une valeur déjà récupérée (Context Forgetting). Les trois axes recouvrent le raisonnement, l’exécution et la mémoire.
Le point de méthode qui compte : le bon comportement reste vérifiable, y compris dire que la tâche est impossible. L’évaluation s’appuie surtout sur des preuves déterministes (scripts sur serveurs réels, assertions d’état, structure de la trajectoire) ; un juge de langue ne pèse que 20 à 30 % du score.
Ce que montre le papier
358 tâches sur 36 serveurs de production
Le banc d’essai compte 358 tâches, réparties à peu près également entre les quatre types (103 pour Unreachable Goal, 89, 84 et 82 pour les trois autres) et trois niveaux de difficulté, dans cinq domaines : recherche générale (75), code (80), analyse (69), productivité (61) et finance (73). Les 36 serveurs MCP tournent dans des conteneurs isolés et exposent près de 300 outils, pas des simulacres. Quatorze agents de huit fournisseurs sont évalués dans une boucle de type ReAct, avec 128 000 jetons de contexte et un budget de 20 appels d’outils : 5 012 trajectoires au total (14 × 358).
Un plafond à 0,728, et un trou sur l’impossible
Le score moyen des modèles est de 0,642 sur 1, avec un taux de réussite binaire de 47,8 % (Tableau 5). Le meilleur, Claude Opus 4.6, atteint 0,728 ; aucun modèle ne dépasse ce plafond. Unreachable Goal est le type le plus difficile pour 12 des 14 modèles : le score moyen tombe à 0,458 et seuls 23,2 % des essais passent. Les agents continuent d’appeler des outils ou annoncent un succès au lieu de dire que le but ne peut pas être atteint. Trois annotateurs humains obtiennent 0,88 sur un échantillon stratifié de 40 tâches, loin au-dessus du meilleur modèle sur l’ensemble du banc.
Dès que l’agent fait quatre appels ou plus sur une tâche inatteignable, le taux de réussite tombe à 0 % (Tableau 6). S’il s’arrête sans aucun appel, il passe 65,0 % du temps. Sur le mésusage d’outils, appeler uniquement le bon outil réussit à 84,7 % ; l’y mêler un outil « leurre » fait chuter ce taux à 32,3 %, même si le bon outil est bien présent (Tableau 7).
Le meilleur au global n’est pas le meilleur partout
Le classement d’un modèle se décale en moyenne de 6,86 places sur 13 possibles selon le type d’échec (arrondi à 6,9 dans l’abstract ; Tableau 16). Branch Collapse et Unreachable Goal sont presque décorrélés d’un modèle à l’autre (r = −0,12). Claude Opus 4.6, premier au score global, n’est que septième sur Branch Collapse, où Claude Opus 4.5 arrive en tête (0,867). Choisir un modèle MCP d’après un seul score agrégé masque donc le type d’échec que vos utilisateurs rencontrent le plus.
Les limites
- quatre types représentatifs, pas exhaustifs : les auteurs écartent pour cette version les décalages de protocole entre serveurs, la confusion d’authentification, la coordination multi-agents et la mémoire d’une session à l’autre ;
- serveurs surtout anglophones, tournés vers des API de type GitHub, Notion ou Slack ; les résultats peuvent ne pas se généraliser à d’autres langues ou services régionaux ;
- inventaire d’outils fixe par tâche : les hallucinations nées de l’installation ou de la désinstallation d’un serveur en cours de trajectoire ne sont pas mesurées ;
- générateur et juge propriétaires : les tâches sont synthétisées par Claude Sonnet 4.6 et notées côté sémantique par GPT-4o ; remplacer le juge par Claude Sonnet 4.5 change peu les classements (r = 0,914), mais une validation avec un juge ouvert reste à faire ;
- attribution du type d’échec validée sur les trajectoires ratées (le type visé est dominant dans 81 % des cas, κ = 0,78), car seuls les échecs révèlent le mode principal.
Lecture Neurone21
Le chiffre à retenir n’est pas 0,728. C’est que les agents MCP savent rarement s’arrêter. Une fois lancés dans une trajectoire, ils transforment l’activité en succès apparent : fichiers « créés », tâches « terminées », alors que l’objectif n’était pas tenable. Dans un déploiement qui écrit dans Notion, GitHub ou un système de fichiers, ce faux achèvement est plus dangereux qu’un refus explicite.
Trois gestes concrets en découlent. Ajouter des tests où la bonne réponse est de s’arrêter, pas seulement des tests où il faut finir le travail. Choisir le modèle selon le type d’échec le plus fréquent chez vos utilisateurs, plutôt que d’après un classement unique. Limiter les outils au schéma trop proche : dès qu’un leurre entre dans la trajectoire, le raisonnement suivant s’appuie sur un état contaminé. Steropes, qui branche des agents sur des outils réels, peut reprendre ces quatre déclencheurs comme grille de recette.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 7 novembre 2026 (15:05 UTC, 16:05 heure de Paris). Elvis Saravia (@omarsar0) l’a reposté à 16:07 heure de Paris (identifiant 2119084387052540192). Nous avons lu la version officielle arXiv 2611.07689v1. Écarts avec le post :
Le post est fidèle à l’abstract : 358 tâches, 36 serveurs, 14 agents, 5 012 trajectoires, score moyen 0,642, 23,2 % de réussite sur les objectifs inatteignables, et un décalage de rang de 6,9 places sur 13. Il n’indique pas le score moyen de 0,458 sur ces mêmes tâches, ni que 6,9 arrondit la moyenne 6,86 du Tableau 16, ni le plafond de 0,728 (Claude Opus 4.6). La Figure 1 affiche aussi une moyenne 0,628 : c’est la moyenne non pondérée des quatre types, distincte du 0,642 calculé sur les scores globaux des modèles.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.07689
- Le PDF : https://arxiv.org/pdf/2611.07689
- Le dépôt annoncé : https://github.com/J1zz/mcp_hallu
- Le post de DAIR.AI : https://x.com/dair_ai/status/2119083711522316490
- Le repost d’Elvis Saravia : https://x.com/omarsar0/status/2119084387052540192
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/mcphallu-benchmarking-reasoning-execution-and-memory-hallucinations-in-mcp-agent-2611.07689