Titre original : The Art of Building Verifiers for Computer Use Agents
Auteurs : Corby Rosset (auteur correspondant), Pratyusha Sharma, Andrew Zhao, Miguel Gonzalez-Fernandez et Ahmed Awadallah.
Affiliations : Microsoft Research et Browserbase (Miguel Gonzalez-Fernandez).
Publication : prépublication déposée sur arXiv le 5 avril 2026 (2604.06240v1, 33 pages), indiquée « en cours de relecture ». Les auteurs annoncent la publication du code et des données sur le dépôt GitHub microsoft/fara.
Liens : page arXiv, PDF, dépôt annoncé.
L’idée en bref
Un agent d’ordinateur (computer use agent) navigue, clique et remplit des formulaires. Pour l’évaluer ou l’entraîner, il faut répondre à une question simple en apparence : a-t-il réussi ? En pratique, c’est difficile. La trajectoire compte des dizaines de captures d’écran, la tâche peut être à moitié faite, réussie par un chemin inattendu, ou ratée de façon fugace dans une capture enfouie au milieu. Un vérificateur qui se trompe fausse à la fois les benchmarks et les données d’entraînement.
Les auteurs livrent les leçons tirées de la construction de leur vérificateur, l’Universal Verifier, autour de quatre principes. Des grilles de notation aux critères précis et sans chevauchement, pour réduire le bruit. Deux notes séparées : une pour le résultat (la tâche est-elle accomplie ?) et une pour le processus (les actions étaient-elles appropriées ?), qui captent des cas différents, comme un agent qui suit les bonnes étapes mais se heurte à un obstacle. Une distinction entre échecs dont l’agent est responsable et obstacles hors de son contrôle, notés sans faire payer deux fois la même erreur. Enfin, une gestion du contexte « diviser pour régner » qui examine toutes les captures d’écran, pour rester fiable sur les longues trajectoires.
Ce que montre le papier
Un banc pour juger les juges
Pour mesurer leurs progrès, les auteurs publient CUAVerifierBench, des trajectoires étiquetées par des humains à la fois pour le résultat et le processus. Le jeu interne compte 140 trajectoires de l’agent Fara-7B sur WebTailBench, étiquetées par des annotateurs experts maison. Un second jeu, étiqueté par des annotateurs externes recrutés via Browserbase, compte 106 trajectoires de Fara-7B sur Online-Mind2Web, avec deux annotateurs par trajectoire.
Presque plus de faux succès
Sur le résultat final, l’Universal Verifier atteint un kappa de Cohen (mesure d’accord corrigée du hasard) de 0,64 sur le jeu interne et 0,58 sur le jeu Browserbase, contre 0,44 et 0,26 pour WebJudge et 0,31 et 0,13 pour WebVoyager. Surtout, son taux de faux succès (une trajectoire déclarée réussie alors qu’un humain la juge ratée) tombe à 0,01 et 0,08, quand celui des deux références dépasse 22 % pour WebJudge et 45 % pour WebVoyager.
Ce n’est pas qu’une question de modèle : en passant WebVoyager et WebJudge sur GPT-5.2, leurs faux succès baissent (de 0,45 à 0,10 pour WebVoyager sur le jeu interne), mais leurs faux échecs montent (de 0,24 à 0,44), et leur accord global ne progresse que modestement. Sur trois benchmarks connus (WebVoyager, Online-Mind2Web, WebTailBench), les vérificateurs livrés avec les benchmarks affichent plus de 20 % de faux succès par rapport à l’Universal Verifier. Sur AgentRewardBench, les auteurs jugent que 8 des 30 trajectoires « réussies » d’un échantillon sont en fait des échecs.
Aussi bon qu’un humain face à un autre humain
Entre eux, les annotateurs Browserbase s’accordent avec un kappa de 0,53 à 0,57 sur le résultat et de 0,36 à 0,45 sur le processus. L’Universal Verifier (0,58 et 0,43) tombe dans ces fourchettes. Quand on montre ensuite aux annotateurs le verdict et le raisonnement du vérificateur, leur accord avec lui monte de 0,39 à 0,63 sur le résultat ; 16,6 % des jugements changent, presque tous de « réussi » vers « raté », parce que le vérificateur a repéré un échec qu’ils avaient manqué.
L’auto-recherche aide, sans remplacer l’expert
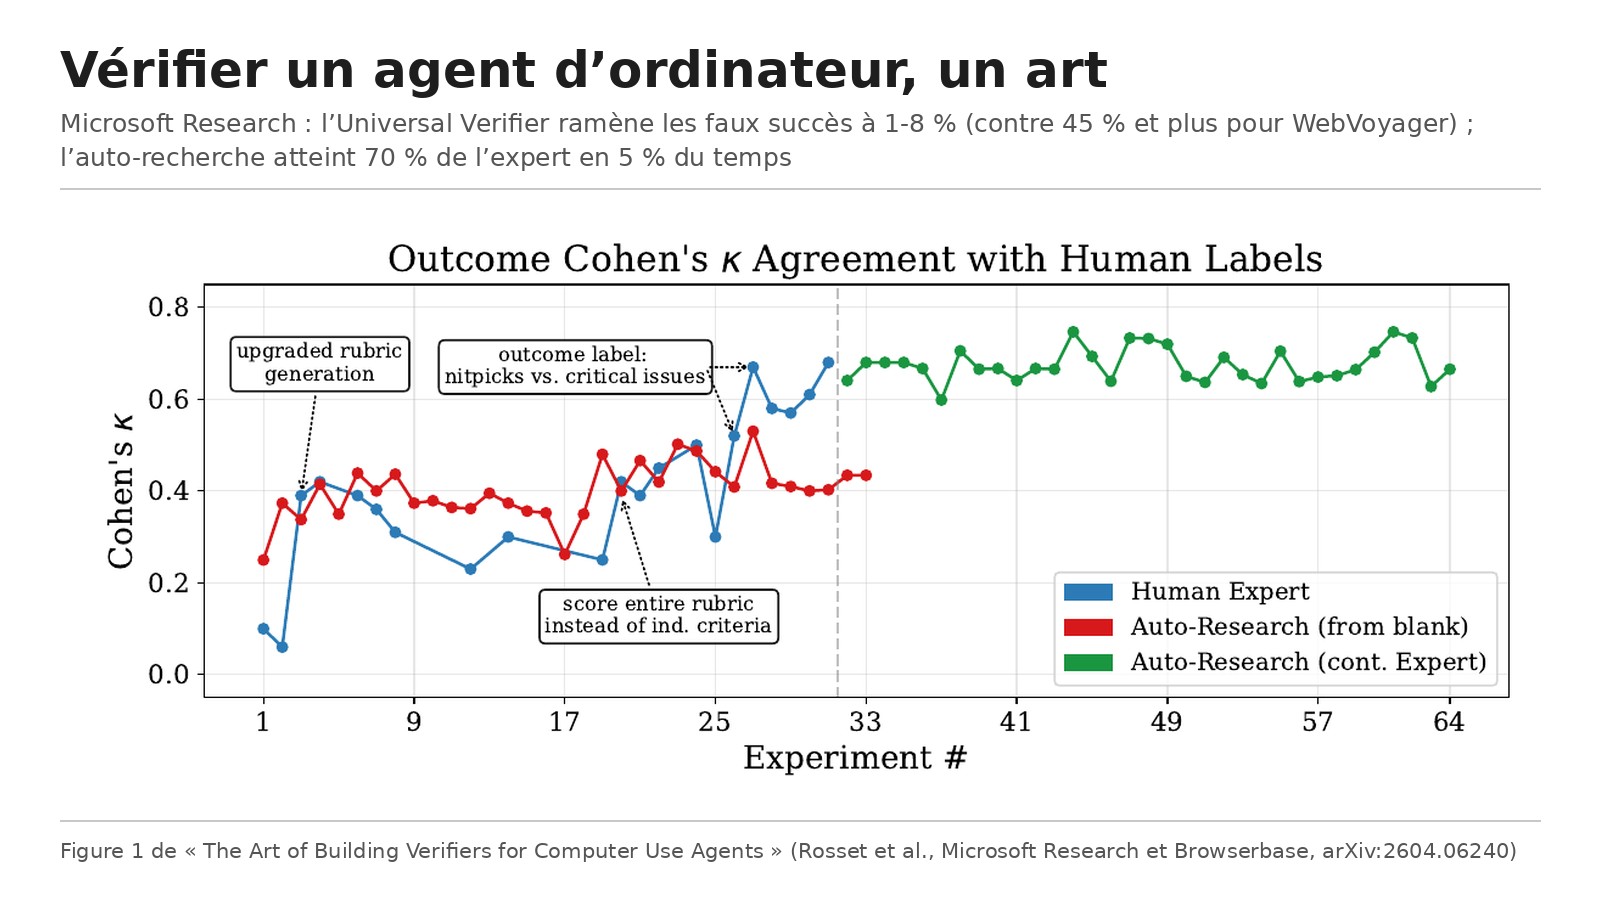
L’expert humain a mené 32 expériences en trois semaines pour atteindre un kappa d’environ 0,7 ; selon les auteurs, la seule refonte de la grille explique à peu près la moitié des gains. Un agent d’auto-recherche (Claude Code avec Claude Opus 4.6), parti de consignes vides mais des mêmes principes, refait le parcours en un jour environ et plafonne vers 0,55 : 70 % de la qualité de l’expert en 5 % du temps. Ses modifications sont prudentes et incrémentales, et il ne trouve pas les grands changements de structure. En revanche, parti de la meilleure version de l’expert, il trouve encore des améliorations sans augmenter les faux succès.
Les limites
Les auteurs le disent : les gains viennent de l’effet cumulé des choix de conception plutôt que d’une astuce isolée, et la conception d’un vérificateur reste autant un art d’encoder un jugement qu’un problème d’ingénierie.
Nos réserves : les deux jeux humains sont petits (140 et 106 trajectoires) et produits par un seul agent, Fara-7B, développé lui aussi chez Microsoft. Tout est sur le web ; les applications de bureau ne sont pas testées. Les annotateurs externes ont été recrutés via Browserbase, dont un salarié cosigne le papier, ce que les auteurs signalent. Enfin, le code et les données sont annoncés, pas encore vérifiables à la lecture du papier.
Lecture Neurone21
Pour une entreprise qui teste des agents sur ses propres parcours web (commande, réservation, back-office), la recette est réutilisable telle quelle : une note pour le résultat, une autre pour la manière, une grille sans critères redondants, et une distinction entre la faute de l’agent et la panne du site. Le chiffre qui compte le plus est le taux de faux succès : un vérificateur qui valide à tort près d’une trajectoire sur deux rend tout benchmark ou tout entraînement trompeur. Et l’auto-recherche est utile pour affiner un vérificateur bien conçu, pas pour le concevoir à votre place.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en huitième (« Separate Process and Outcome ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2604.06240v1. Écarts avec l’article :
Le résumé est fidèle : deux notes séparées, critères sans chevauchement, distinction entre erreurs de l’agent et problèmes extérieurs, quelques faux succès restants (de 1 à 8 % selon le jeu). L’article ne donne pas de chiffres et ne mentionne ni CUAVerifierBench ni l’expérience d’auto-recherche.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2604.06240
- Le PDF : https://arxiv.org/pdf/2604.06240
- Le dépôt annoncé : https://github.com/microsoft/fara
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur Claw-Eval, qui note aussi le parcours des agents : /p/claw-eval-trajectoires-agents-securite
- Notre fiche sur les agents juges : /p/agent-juge-etude-synthese-polyu