Titre original : When AI Benchmarks Plateau: A Systematic Study of Benchmark Saturation
Auteurs : Mubashara Akhtar et Anka Reuel (autrices principales), avec une quarantaine de contributeurs, dont Leshem Choshen et Vilém Zouhar. Conseillers : Mykel J. Kochenderfer, Sanmi Koyejo, Mrinmaya Sachan, Stella Biderman, Zeerak Talat, Avijit Ghosh et Irene Solaiman.
Affiliations : 26 institutions, dont ETH Zurich et ETH AI Center, Stanford University, EleutherAI, IBM Research, l’université de Cambridge, l’université d’Édimbourg et Hugging Face. Le travail a été mené au sein de la coalition EvalEval (Evaluating Evaluations).
Publication : déposé sur arXiv le 18 février 2026, version 4 du 6 août 2026 (2602.16763v4), publié dans les actes d’ICML 2026 (PMLR 306, Séoul). Données et code publiés sur GitHub. Les auteurs déclarent un conflit d’intérêts possible : certains membres de la coalition ont contribué à des modèles ou à des évaluations analysés.
Liens : page arXiv, PDF.
L’idée en bref
Un benchmark n’a de valeur que s’il départage les modèles. Or beaucoup de bancs d’essai populaires, comme HumanEval, ont vu les meilleurs modèles s’agglutiner près du plafond : ils ne disent plus lequel est meilleur. On parle de saturation, mais sans définition partagée : atteindre le niveau humain ? toucher 100 % ? ne plus pouvoir séparer statistiquement les meilleurs ?
Les auteurs tranchent. Un benchmark est saturé quand les meilleurs modèles (les cinq premiers du classement) ne se distinguent plus statistiquement et qu’ils approchent le plafond observé. Si seule la première condition est remplie, ils parlent de stagnation, qui peut venir d’une limite des modèles ou d’un banc mal conçu. Ils en tirent un indice de saturation calculé à partir des classements publics : l’écart entre les cinq meilleurs scores est rapporté à l’incertitude attendue, qui dépend de la taille du jeu de test.
Ce que montre le papier
Près de la moitié des bancs sont saturés
L’étude porte sur 60 benchmarks textuels très utilisés, âgés de 1 à 114 mois : connaissances et raisonnement, multilingue, code, contexte long, factualité et tâches d’agents. Vingt-trois chercheurs les ont annotés selon 14 propriétés (format de réponse, langues, mode de construction, accès au test). Le corpus compte 56 bancs publics et 4 privés, 44 en anglais seul et 16 multilingues.
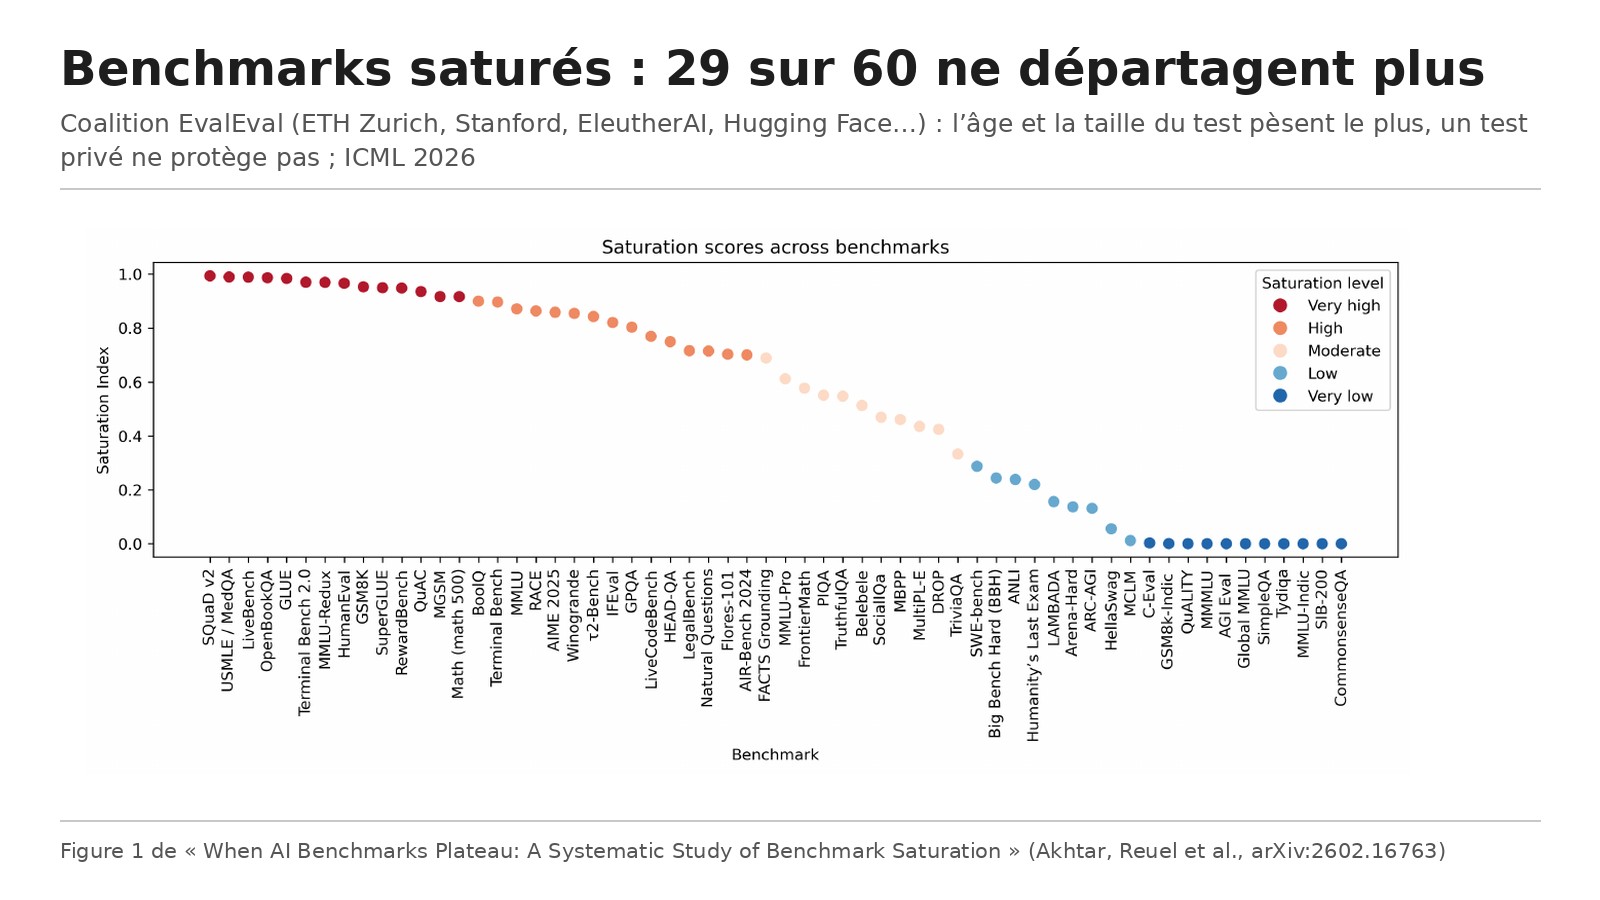
Résultat : 29 bancs sur 60 présentent une saturation forte ou très forte (indice d’au moins 0,7), dont 14 très forte (au moins 0,9). La part de bancs saturés passe de 42,9 % pour ceux sortis depuis moins de 24 mois à 54,5 % pour ceux de plus de 60 mois, avec des indices moyens de 0,51, 0,52 et 0,60 selon l’âge. La tendance est cohérente mais modeste, et pas significative à elle seule. Dans les régressions qui combinent tous les facteurs, l’âge et la taille du jeu de test ressortent comme les prédicteurs les plus constants : plus il y a de questions, moins les meilleurs scores se tassent.
Ce qui ne protège pas
Garder le jeu de test privé ne fait pas de différence statistiquement significative. Les bancs multilingues semblent moins saturés, mais ils sont aussi plus jeunes (32,9 mois en moyenne contre 48,9) : une fois l’âge pris en compte, l’avantage disparaît. La popularité (citations, présence dans les rapports techniques des éditeurs) n’est plus liée à la saturation une fois l’âge contrôlé. Les formats fermés (choix multiple) et les questions générées à partir de gabarits ne changent pas grand-chose non plus.
Ce qui semble aider
Les bancs conçus par des experts sont moins saturés à âge comparable ; certains, comme ARC-AGI ou BIG-Bench Hard, résistent malgré une longue exposition. Les auteurs restent prudents : les catégories de construction diffèrent elles-mêmes par l’âge, qui reste un facteur de confusion. Les bancs entièrement synthétiques sont peu saturés, mais trop récents pour conclure.
Leurs recommandations
Surveiller la saturation pendant toute la vie d’un benchmark ; le renouveler (rafraîchissements, sous-ensembles cachés tournants, collecte adversariale) ; publier avec les scores des intervalles de confiance et l’écart entre les meilleurs, au lieu d’un seul score de pointe ; et prévoir dès la conception des règles de révision ou de retraite. Ils rappellent aussi qu’une saturation n’est pas toujours mauvaise : sur un banc valide, elle peut signifier que la tâche est vraiment maîtrisée.
Les limites
Les auteurs le disent : les classements publics sont hétérogènes (plusieurs classements par banc, protocoles différents, mises à jour irrégulières), et leur mesure d’incertitude ne vaut que pour des scores de type précision sur un jeu fixe. Les classements Elo, les pass@k ou les notes de juges LLM demanderaient d’autres calculs. L’étude est observationnelle et ne prouve pas de causalité.
Nos réserves : la conclusion sur les jeux de test privés repose sur seulement 4 bancs privés contre 56 publics, ce qui limite beaucoup la portée du « ne protège pas ». Le seuil de cinq modèles et les seuils de 0,7 et 0,9 sont des choix raisonnables mais conventionnels.
Lecture Neurone21
Quand un éditeur annonce un record sur un banc saturé, l’écart avec le concurrent peut tenir dans le bruit de mesure. Avant de choisir un modèle sur la foi d’un classement, il vaut la peine de vérifier que les modèles qui vous intéressent s’écartent encore nettement les uns des autres sur ce banc, de préférer des bancs récents, gros et conçus par des experts, et surtout de tester sur ses propres données, qui ne sont saturées par personne.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a placé en premier (« Pick Durable Benchmarks ») dans son article X « My Top 10 Eval Papers of 2026 », publié le 16 novembre 2026 à 15:17 heure de Paris, qu’il a ensuite cité et reposté le même jour. Nous avons lu la version officielle arXiv 2602.16763v4. Écarts avec l’article :
« Près de la moitié saturés » correspond à 29 bancs sur 60. « Les bancs plus anciens sont plus souvent saturés » est une tendance que le papier juge modeste et non significative à elle seule, même si l’âge reste le facteur le plus constant dans les régressions. « Les bancs les plus durables sont conçus par des experts » est présenté par les auteurs comme une association, avec l’âge comme facteur de confusion. Le constat sur les tests publics ou privés est conforme, mais repose sur 4 bancs privés.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2602.16763
- Le PDF : https://arxiv.org/pdf/2602.16763
- L’article d’Elvis Saravia « My Top 10 Eval Papers of 2026 » : https://x.com/omarsar0/status/2122333324895035868
- Notre fiche sur Terminal-Bench 2.0, un banc conçu pour rester difficile : /p/terminal-bench-2-agents-terminal-89-taches
- Notre fiche sur LifeVal, des tâches personnelles pour évaluer les agents : /p/lifeval-agents-taches-quotidiennes-openai