Titre original : Scaling Discovery Requires Forgetting
Auteurs : Shangyin Tan, Ben Zhou, Lakshya A Agrawal, Jialin Zhang, Yilin Chen, Qiuyang Mang, Donghyun Lee, Dennis Jacob, Koushik Sen, Alex Dimakis, Matei Zaharia
Affiliations : UC Berkeley, Université Stanford, Bespoke Labs.
Publication : déposé sur arXiv le 14 octobre 2026 (version 1).
Liens : page arXiv, PDF. Aucun dépôt de code propre au papier n’est indiqué.
L’idée en bref
La « recherche automatisée » (autoresearch) confie à un agent une boucle complète : proposer une solution, la faire noter par un évaluateur automatique, en tirer des leçons, recommencer. Pour lui donner plus de moyens, on peut le faire tourner plus longtemps, lancer plusieurs agents en parallèle, ou les laisser partager leurs résultats. Les auteurs constatent que les trois stratégies finissent par plafonner pour la même raison : en accumulant l’historique de ses essais, chaque agent s’y ancre et ne propose plus que des retouches de plus en plus petites.
Leur remède est l’oubli. Périodiquement, on efface la session de chaque agent (sa conversation et ses raisonnements) et tout l’historique des solutions candidates, pour ne garder que la meilleure. De nouveaux agents, au contexte vide, repartent de celle-ci.
Ce que montre le papier
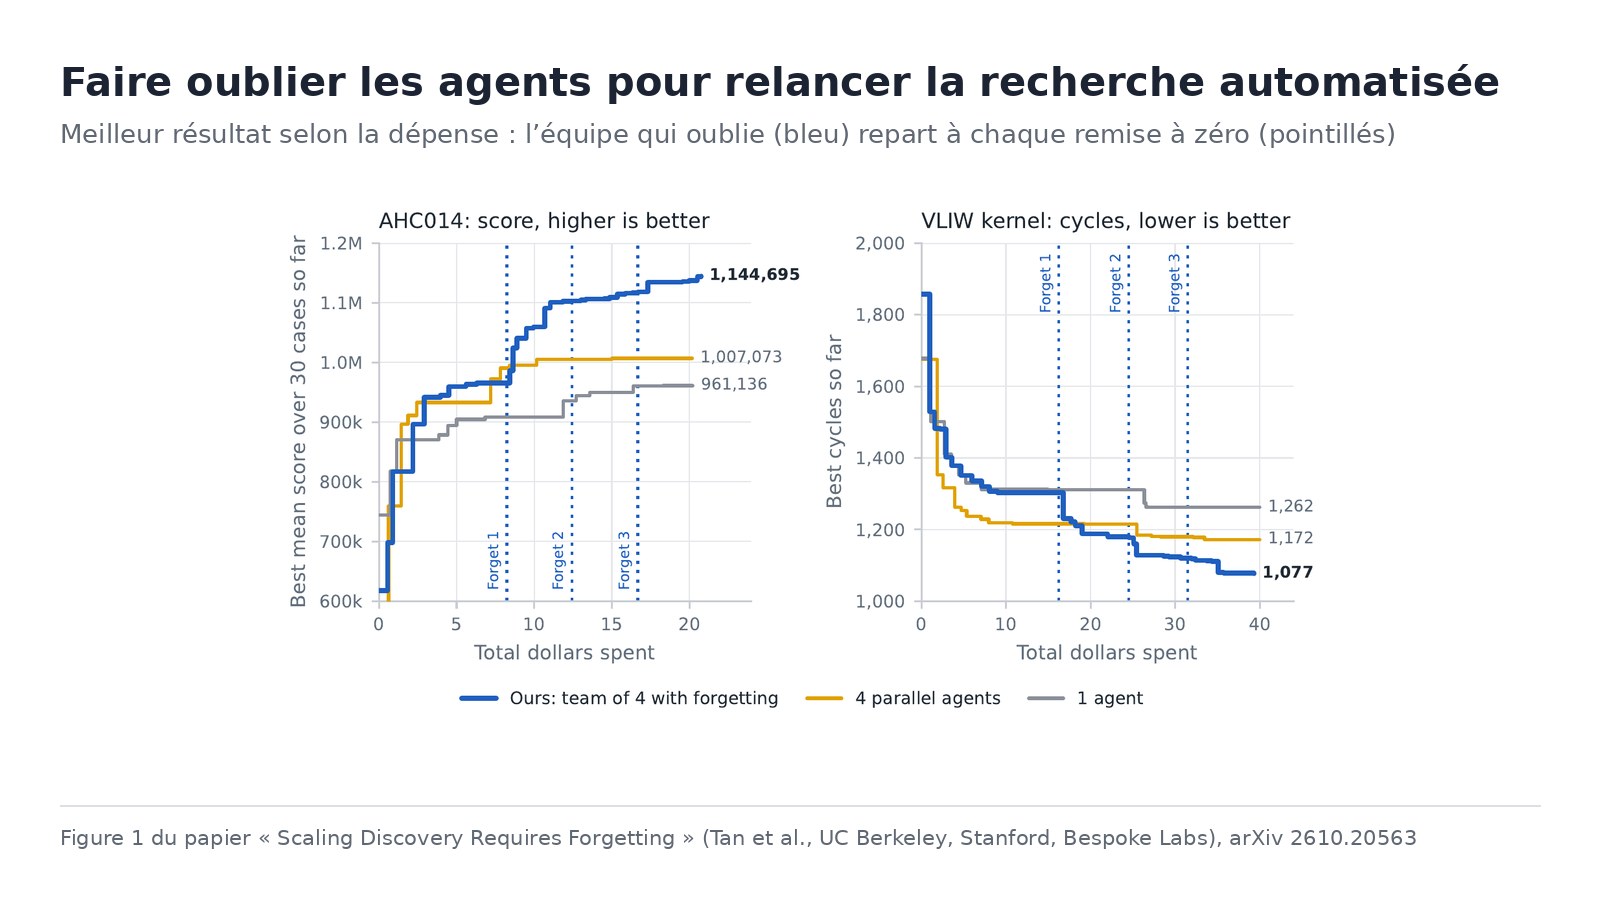
Le protocole. Quatre tâches : écrire un programme d’optimisation pour un concours de programmation (AtCoder Heuristic Contest 014), un problème d’optimisation algorithmique (Frontier-CS), l’accélération d’un noyau de calcul pour une machine simulée (le test d’embauche « VLIW » d’Anthropic) et l’amélioration d’un script d’entraînement d’un petit modèle de langage en cinq minutes (nanochat). Trois configurations à budget égal : un agent seul, quatre agents en parallèle sans échange, et une équipe de quatre agents qui communiquent et oublient trois fois. Chaque configuration tourne trois fois, avec un seul modèle, DeepSeek V4.1 Flash, dans l’environnement d’agent Pi.
Les gains. L’équipe qui oublie arrive en tête sur les quatre tâches. Sur AHC014, son score moyen dépasse de 14 % celui des agents parallèles et de 39 % celui de l’agent seul : c’est l’origine du « jusqu’à 39 % » cité par Elvis Saravia. Le « jusqu’à 15 % » face aux agents parallèles correspond à l’écart des moyennes sur Frontier-CS. Les écarts sont bien plus modestes ailleurs : sur nanochat, le gain sur la meilleure référence n’est que de 1,9 %.
Pourquoi ça plafonne. Au fil d’une session, les modifications rétrécissent. Avant sa première remise à zéro, l’équipe passe d’environ 150 lignes modifiées par proposition à 30, et son raisonnement d’environ 28 000 jetons à 7 000. Sur le noyau VLIW, 532 des 763 tours d’un agent seul ne produisent aucune solution : l’agent déclare avoir atteint « la limite pratique de la machine », alors que l’équipe fera bien mieux sur la même tâche.
Oublier coûte moins cher que continuer. Depuis un même état bloqué, continuer fait gagner 1,4 % à 1,9 % ; oublier fait gagner 4,5 % à 9,2 %, pour à peu près la moitié du coût, car une longue session coûte plus cher à chaque tour.
Les limites
- Un seul modèle et un seul environnement d’agent : rien ne dit que l’effet se retrouve avec d’autres modèles, notamment ceux qui gèrent mieux les longs contextes.
- Trois répétitions par configuration, et une figure d’ouverture qui montre la meilleure des trois.
- Quatre tâches, toutes dotées d’un évaluateur automatique et chiffré. La méthode suppose qu’on sache désigner la « meilleure » solution ; elle ne s’applique pas telle quelle à une recherche sans note objective.
- Le moment de l’oubli est fixé à l’avance (trois fois par budget). Savoir quand oublier et quoi retenir reste, selon les auteurs eux-mêmes, la prochaine question.
- Pas de section dédiée aux limites dans le papier : celles-ci sont déduites du protocole.
Lecture Neurone21
L’intuition va à rebours d’une tendance du moment, qui consiste à donner aux agents toujours plus de mémoire et de contexte. Pour des tâches d’optimisation longues (code, algorithmes, réglages d’entraînement), ce travail suggère qu’une mémoire trop chargée rend l’agent conservateur, et qu’un redémarrage propre à partir du meilleur résultat vaut mieux qu’une prolongation coûteuse.
Pour les équipes qui font tourner des agents pendant des heures sur un problème, la leçon pratique est simple à tester : surveiller la taille des modifications proposées comme signal de plateau, et prévoir des remises à zéro. Le résultat reste à confirmer sur d’autres modèles.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.20563
- Le PDF : https://arxiv.org/pdf/2610.20563
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2110911109964386460
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/scaling-discovery-requires-forgetting-2610.20563