Titre original : You don’t need long context
Auteurs : Peter Belcak, Saurav Muralidharan, Jindong Jiang, Yonggan Fu, Wonmin Byeon, Hanrong Ye, Ryan Angilly, Ali Taghibakhshi, Shih-Yang Liu, Siru Ouyang, Greg Heinrich et Pavlo Molchanov.
Affiliations : NVIDIA.
Publication : rapport technique, prépublication arXiv 2611.05306v1 (cs.AI), déposée le 3 novembre 2026, 31 pages et 8 figures.
Liens : page arXiv, PDF. Aucun dépôt de code n’est indiqué dans le papier.
L’idée en bref
Plus le contexte d’un modèle est long, plus chaque nouveau jeton coûte cher à produire : la mémoire occupée et le temps de calcul augmentent avec la taille du contexte. Pourtant, les modèles actuels acceptent de 200 000 jetons à plus d’un million. Les auteurs identifient deux sources de longs contextes : les tâches longues, où l’historique d’un agent s’accumule étape après étape, et les entrées longues, où un gros document est collé en entier dans la requête. Ils testent si l’un ou l’autre est vraiment nécessaire.
Leur méthode tient en deux gestes. Pour les tâches longues, l’agent écrit un court relais (la « compaction ») dès que le contexte atteint un seuil, puis une nouvelle conversation reprend avec la consigne d’origine et ce relais seulement. Pour les documents longs, le texte est rangé dans des fichiers et l’agent le lit par morceaux avec des commandes simples (grep, sed), au lieu de le recevoir en entier.
Ce que montre le papier
Un long contexte coûte plus cher à servir
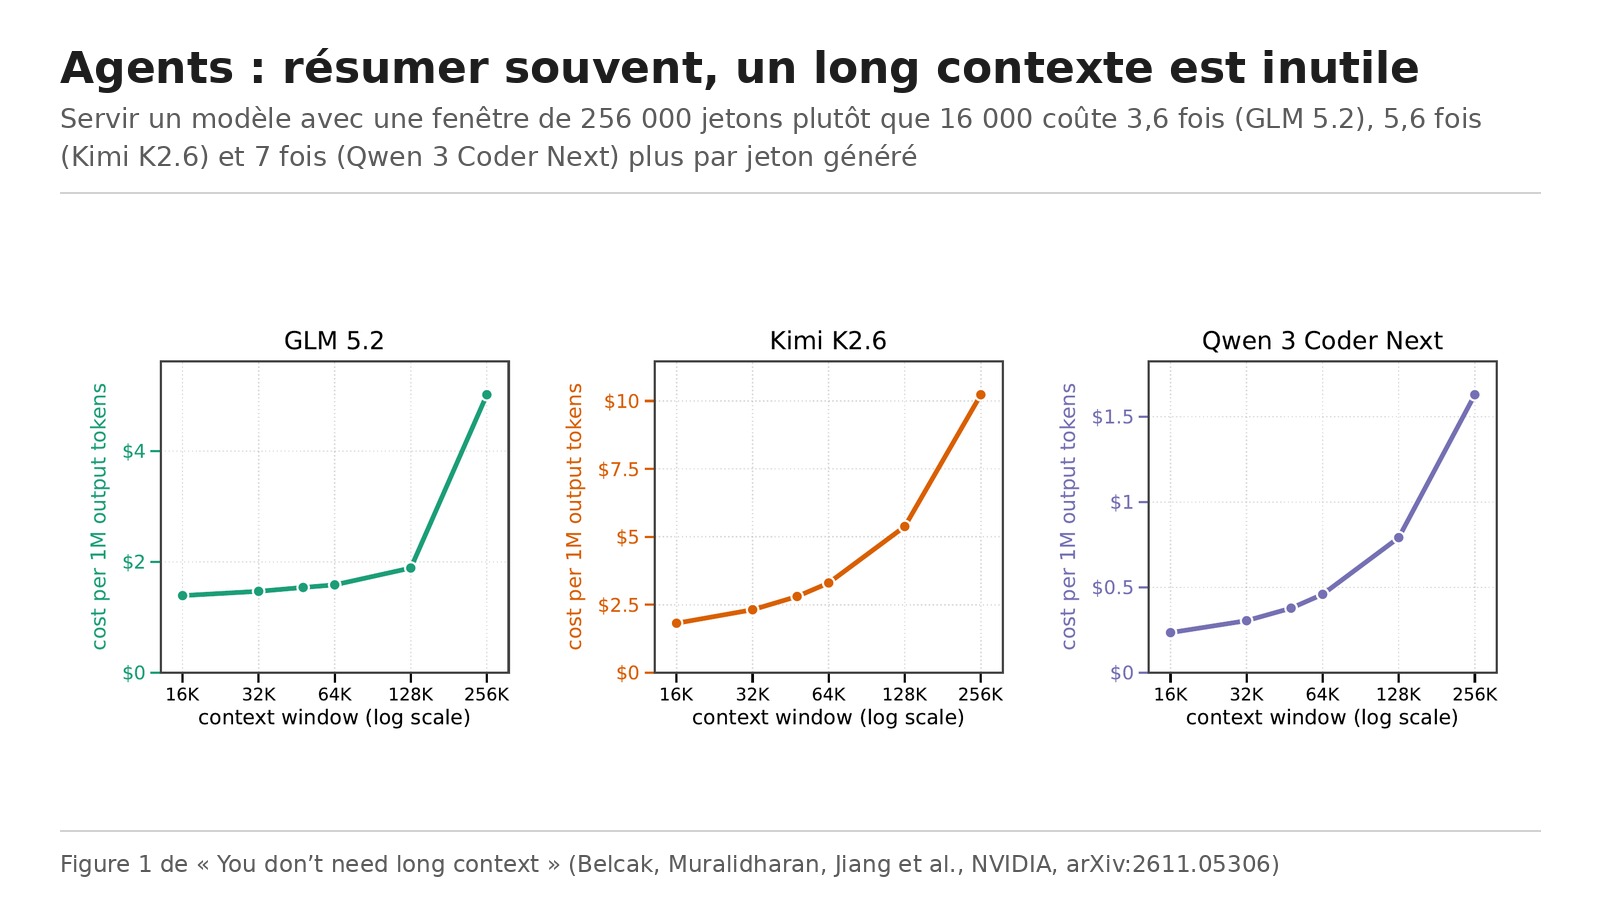
Sur des GPU H100 loués à la demande (3,85 dollars par heure et par GPU), les auteurs mesurent le débit maximal de trois modèles ouverts selon la taille de fenêtre configurée. Passer d’une fenêtre de 16 000 à 256 000 jetons multiplie le coût de génération par jeton par 3,6 pour GLM 5.2, 5,6 pour Kimi K2.6 et 7 pour Qwen 3 Coder Next. Sur un NVIDIA DGX Spark, la latence entre deux jetons double environ pour plusieurs modèles locaux quand le contexte s’allonge. Les auteurs notent que les prix publics sont affichés par million de jetons sans tenir compte de la longueur du contexte, ce qui masque cet écart à l’utilisateur.
Tâches longues : résumer souvent suffit
Six tests : SWE-bench Verified (500 corrections de bugs réels), SWE-bench Multilingual (300), Terminal-Bench 2.1 (89 tâches en ligne de commande), FRAMES (824 questions multi-sources), τ²-bench (184 tâches de dialogue avec outils) et BFCLv3 (200 épisodes d’appels d’outils). Deux modèles fermés, Claude Opus 4.5 et GPT 5.6 Sol, avec un agent minimal. La limite totale de contexte descend de 48 000 à 8 000 jetons selon les tests.
L’écart de précision avec l’historique complet va de moins 3,7 à plus 5,6 points pour Opus et de moins 3,3 à plus 4,4 points pour GPT. Pour chaque modèle, 5 réglages sur 22 au plus perdent plus de 2 points. Sur SWE-bench Verified, Opus passe de 70,0 % à 74,8 % (limite de 24 000 jetons) et GPT de 84,4 % à 88,8 % (limite de 48 000). Sur Terminal-Bench, Opus passe de 47,2 % à 52,8 % et GPT de 87,6 % à 88,8 %. FRAMES fait exception : la précision baisse dans tous les réglages, de 1,3 à 3,7 points pour Opus et de 1,5 à 3,3 points pour GPT. Au réglage le plus serré de SWE-bench Verified (16 000 jetons), Opus recule à 68,8 %.
Documents longs : lire par morceaux
Sept tests, dont trois jeux de questions sur de vrais documents (LongBench v2, LOONG, AA-LCR) et quatre jeux d’aiguilles dans une botte de foin (NIAH, RULER, Counting-Stars, BABILong). La lecture par morceaux avec compaction en secours égale ou dépasse la référence presque partout. Sur LOONG, le score moyen d’Opus passe de 70,1 à 79,8 et celui de GPT de 79,3 à 84,6. Sur AA-LCR (100 questions), Opus passe de 65,0 % à 84,0 % et GPT de 82,0 % à 83,0 %. Sur RULER, le rappel moyen passe de 62,5 % à 95,7 % pour Opus et de 65,5 % à 96,4 % pour GPT. Sur BABILong, de 67,1 % à 92,0 % et de 70,7 % à 94,0 %. Sur LongBench v2, la différence reste faible : moins 0,4 point pour Opus et plus 1,8 point pour GPT. La longueur totale des conversations reste dans une bande étroite quand les documents grossissent.
Une seule action par contexte
Dans le cas extrême, chaque conversation ne fait qu’une action, puis l’état est réécrit et la conversation est jetée. Sur SWE-bench Verified, Opus obtient 70,2 % contre 70,0 % avec l’historique complet, et le contexte maximal d’une étape tombe de 200 000 à 16 000 jetons (médiane de 32 000 à 8 000). Sur Terminal-Bench, Opus gagne 4,6 points (51,8 % contre 47,2 %). GPT 5.6 Sol perd 2,0 points sur SWE-bench Verified (82,4 % contre 84,4 %) et 3,3 points sur Terminal-Bench (84,3 %, soit 75 tâches sur 89). Sur les deux modèles et les deux tests, la médiane du contexte de pointe reste entre 7 000 et 9 000 jetons.
À partir de là, les auteurs proposent une idée, non entraînée ni testée : des « modèles à état sémantique », post-entraînés pour porter un état écrit en langage naturel d’une étape à l’autre au lieu de relire tout l’historique.
Ce qui fait une bonne compaction
En annexe, les auteurs expliquent qu’un résumé fidèle de l’historique marche moins bien qu’une fiche choisie pour la suite du travail. Les meilleures compactions contiennent une copie quasi mot pour mot de la consigne, l’occupation et les prochaines étapes de l’agent, et tout ce qui servira ensuite : plan décomposé, critères de fin de tâche, chemins de fichiers, erreurs déjà rencontrées.
Les limites
- Le coût des modèles fermés est estimé, pas mesuré. Les auteurs ont mesuré le rapport de coût entre 16 000 et 256 000 jetons sur trois modèles ouverts (de 0,14 à 0,28, moyenne arrondie à 0,20), puis ont appliqué ce facteur de 0,20 aux tarifs d’Opus et de GPT, par interpolation. Aux tarifs publics réels, le coût « nominal » baisse peu et monte parfois : sur SWE-bench Verified, Opus passe de 420 à 296 dollars (réglage 24 000 / 18 000) et GPT de 168 à 189 dollars. Les économies de 2,2 à 8,8 fois (Opus) et de 2,4 à 5,0 fois (GPT) sur les tâches longues, et jusqu’à 233 fois sur les documents longs, supposent un fournisseur qui facture moins cher les contextes courts ;
- les meilleurs scores sont choisis après coup : la valeur « meilleure compaction » est le meilleur de quatre réglages testés sur les mêmes tâches, et le papier ne donne ni intervalle de confiance ni répétition des exécutions pour les scores des agents ;
- deux modèles fermés et un agent minimal (commandes Bash seulement) ; sur cinq modèles ouverts quantifiés, tous perdent en précision sur SWE-bench Verified au réglage le plus serré, et Qwen 3 Coder Next s’effondre de 53,0 % à 3,6 % à 16 000 / 12 000 jetons, car ses traces verbeuses laissent trop peu de place entre deux compactions ;
- les gains sur documents longs mêlent deux changements (lecture par morceaux et compaction) et dépendent de la facilité de recherche : les auteurs relient eux-mêmes le 100 % sur NIAH au recouvrement de mots entre l’aiguille et la question ;
- le papier ne prouve pas l’inutilité de tout long contexte : les auteurs précisent que leurs résultats n’excluent pas des tâches où un contexte long aide ; les auteurs sont de NVIDIA, dont le DGX Spark sert aux mesures locales, et le papier est une prépublication non relue par des pairs.
Lecture Neurone21
Le message utile pour une entreprise est de ne pas payer une très longue fenêtre par défaut. Prenons un agent de support qui suit un dossier client sur trente échanges. Au lieu de relire toute la conversation à chaque réponse, il peut garder une fiche d’état : la demande, les vérifications faites, les pièces reçues, la prochaine étape. C’est la forme de compaction que le papier recommande, mais il l’a mesurée sur du code, de la recherche d’information et des appels d’outils, pas sur du support client.
Deux précautions pratiques. D’abord, tester sur ses propres tâches avec deux ou trois seuils, en gardant le journal complet dans un fichier que l’agent peut consulter si besoin : c’est ce qui rend la compaction réversible. Ensuite, regarder la facture réelle plutôt que le nombre de jetons. Notre fiche sur la compression du contexte des agents de code montre qu’une compression qui casse le cache du fournisseur peut coûter autant qu’un contexte complet ; ici aussi, seule une vraie facture tranche.
La lecture par morceaux rejoint le résultat de RAGFlow, où un agent muni seulement de BM25 et de grep répond déjà à 91 % de FRAMES. Et un contexte plus court n’est pas seulement moins cher : la fiche voisine sur la concurrence entre affirmations suggère que ce qu’on met dans le contexte compte plus que sa taille.
D’où vient ce papier
Elvis Saravia (@omarsar0) a recommandé ce papier le 4 novembre 2026 avec le lien arXiv et un lien « Chat with Paper » de DAIR.AI, et l’a republié le 5 novembre. Nous avons lu la version officielle sur arXiv : tous les chiffres ci-dessus viennent du papier, pas du post. Quelques écarts avec le post :
Le post dit que les jetons tardifs coûtent « jusqu’à 7 fois » plus sur des modèles ouverts de pointe. Le papier mesure le coût de service avec une fenêtre de 256 000 jetons plutôt que 16 000, et 7 fois est la valeur la plus haute (Qwen 3 Coder Next), contre 3,6 et 5,6 fois pour les deux autres modèles. Les chiffres « 70,2 contre 70,0 » et « 32 000 à 8 000 jetons » ne valent que pour Claude Opus 4.5 ; GPT 5.6 Sol perd 2,0 points dans ce réglage. Le passage de 70,0 à 74,8 est le meilleur de quatre réglages (les autres donnent 73,6, 72,0 et 68,8). Enfin, le post parle de pertes modestes « dans certains réglages » : sur FRAMES, la précision baisse dans tous les réglages testés.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.05306
- Le PDF : https://arxiv.org/pdf/2611.05306
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2117956281910829083
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/you-dont-need-long-context-2611.05306