Titre original : Length Is Cheap, Competition Is Not: Attention Predicts Context Rot in Retrieval
Auteur : Yinuo Liu.
Affiliation : Department of Computer Science and Engineering, University of California San Diego (États-Unis).
Publication : prépublication arXiv 2611.04169v1 (cs.CL), déposée le 3 novembre 2026, 15 pages, 2 figures et 5 tableaux.
Liens : page arXiv, PDF, code sur GitHub, données sur Hugging Face.
L’idée en bref
Quand un modèle reçoit un très long texte, sa capacité à retrouver une information baisse : on parle de « pourrissement du contexte » (context rot). L’explication courante est la longueur elle-même. L’auteur propose une autre lecture : une information noyée dans du texte sans rapport reste facile à retrouver, mais des phrases qui ressemblent à l’information cherchée lui font concurrence, et c’est cette concurrence qui fait échouer le modèle.
Pour le tester, il fixe la longueur du contexte et la position de l’information, et ne change que ce qui l’entoure. Chaque essai cache une phrase du type « Le code secret de la rivière est 4821 » et demande ensuite le code. Le contexte est rempli de quatre façons : rien (référence courte), du texte neutre (nombres au hasard, mots au hasard ou une phrase répétée), des phrases au même format que l’information (« Le code secret du pont est 1734 », avec des clés tirées parmi 51 noms), ou du texte neutre caché au mécanisme d’attention tout en gardant les positions. Il mesure aussi la part d’attention que le modèle laisse sur la bonne phrase.
Ce que montre le papier
Le texte neutre ne coûte presque rien
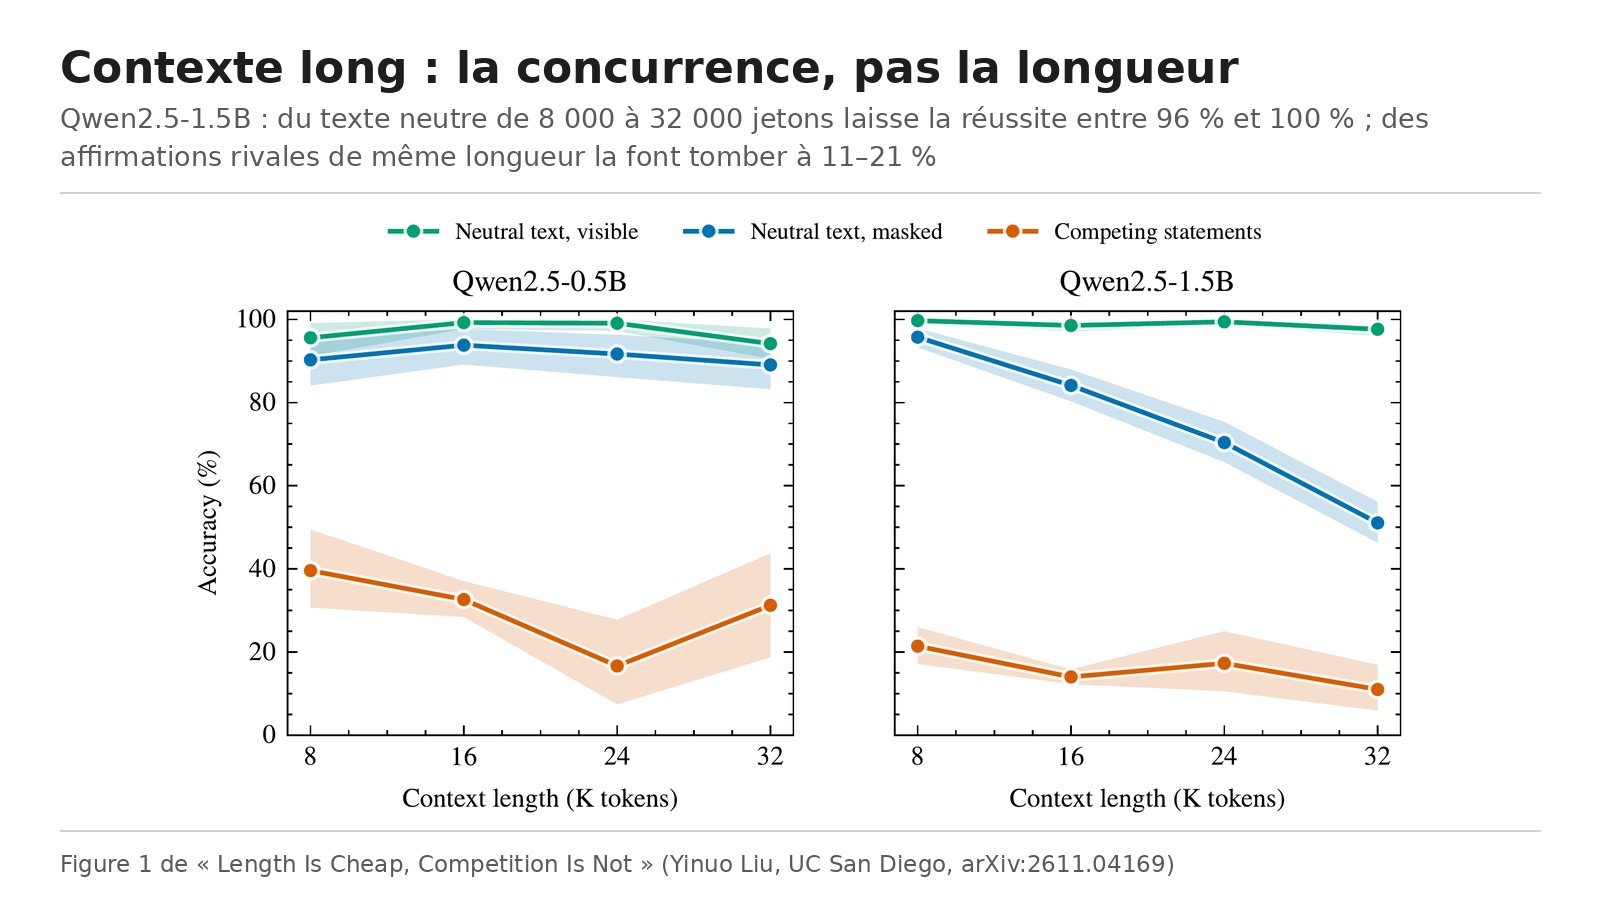
Sur Qwen2.5-1.5B, le texte neutre visible laisse la réussite entre 96 % et 100 % de 8 000 à 32 000 jetons (98 % à 32 000), avec une perte médiane de 0,006 nat au plus. Les autres modèles testés (Qwen2.5-0.5B, SmolLM2-1.7B, Llama-3.2-3B) se comportent de même jusqu’à 4 000 jetons. OLMo-2-1B fait exception : il perd 0,57 nat à 2 048 jetons (réussite de 91 %).
Les phrases concurrentes font chuter la réussite
À longueur identique, remplacer le texte neutre par des phrases au même format fait tomber Qwen2.5-1.5B à 11 % à 21 % de réussite entre 8 000 et 32 000 jetons (17 % à 40 % pour Qwen2.5-0.5B). La perte se concentre sur les phrases qui donnent à la clé demandée une autre valeur. Jusqu’à 2 048 jetons, la perte moyenne est de 0,02 à 0,34 nat sans aucun conflit de ce type, et de 1,38 à 3,24 nats avec au moins un ; la réussite est de 97 % à 100 % sans conflit contre 25 % à 52 % avec un. Une seule phrase rivale multiplie la perte par 9 à 110 selon le modèle, et chaque phrase de plus l’aggrave : sur Qwen2.5-1.5B à 2 048 jetons, la perte vaut 0,03, 1,37, 2,24, 2,48, 2,71, 3,26 et 3,45 nats pour 0 à 6 conflits ou plus. Les phrases qui n’ont que le même format, sans la même clé, comptent beaucoup moins (au plus 0,3 % de la variance).
L’attention laissée sur la bonne phrase prédit l’échec
Sur 126 473 essais, la quantité mesurée est la part d’attention que huit têtes de lecture du modèle envoient vers la phrase à retrouver. Entre 512 et 2 048 jetons, le logarithme de son inverse explique de 35 % à 58 % de la variance de la perte selon le modèle, contre 2 % à 8 % pour le logarithme de la longueur. Entre 8 000 et 32 000 jetons, l’écart reste : 32 % et 33 % (Qwen2.5-1.5B et Llama-3.2-3B) contre 2 % et 3 %. L’attention sur la bonne phrase passe de 0,51–0,77 avec le contexte court à 0,17–0,31 avec les phrases concurrentes. Sur Qwen2.5-1.5B, la perte reste proche de zéro tant que cette part ne tombe pas sous environ 0,35, puis monte brutalement : le modèle supporte de perdre à peu près la moitié de son attention, puis échoue d’un coup.
Masquer des jetons ne mesure pas l’effet de la longueur
Un travail antérieur (Du et al.) cachait des jetons à l’attention en gardant leurs positions et concluait que la longueur seule fait perdre de la précision. L’auteur reproduit ce résultat sur 1 000 questions MMLU : à 30 000 jetons masqués, Llama-3.2-3B passe de 51,7 % à 40,5 % et Qwen2.5-7B de 65,8 % à 48,1 %. Mais en recherche d’information, masquer le même texte neutre coûte 46 points de réussite à 32 000 jetons (98 % visible, 52 % masqué sur Qwen2.5-1.5B), alors que le laisser visible ne coûte rien. Le masquage crée de longs trous de position que le modèle n’a jamais vus à l’entraînement ; son coût n’est donc pas celui de la longueur. L’auteur recommande d’ajouter un témoin visible à toute étude sur la longueur.
Les limites
- Un lien prédictif, pas causal : l’attention est mesurée dans la même passe que la perte et aucune intervention n’est faite dessus ;
- de très petits modèles et une tâche synthétique : cinq modèles de 0,5 à 3 milliards de paramètres, un seul type de tâche (retrouver un code à quatre chiffres) ; le modèle de 7 milliards n’intervient que dans la reproduction sur MMLU, sans témoin visible au-delà de 4 000 jetons ;
- le nombre de conflits grandit avec la longueur : tout contexte de 4 096 jetons ou plus en contient au moins un, donc l’effet de phrases au même format mais sans conflit n’est pas mesuré au-delà de 2 000 jetons, et l’analyse des conflits n’était pas préenregistrée ;
- la mesure d’attention est étroite : un seul jeton de question, huit têtes choisies sur le contexte court, sans retirer l’attention portée au premier jeton ;
- la longueur n’est pas gratuite partout : du remplissage par espaces fait tomber Qwen2.5-1.5B à 36,0 % sur MMLU à 4 096 jetons (contre 59,1 % sans remplissage), donc la concurrence domine en recherche mais des effets de longueur restent possibles en raisonnement ;
- un seul auteur, une prépublication non relue par des pairs.
Lecture Neurone21
L’enseignement pratique concerne ce qu’on met dans un contexte plus que sa taille. Imaginons une base de connaissances qui contient trois versions de la même grille tarifaire (2024, 2025 et 2026). Pour un assistant, ces trois versions sont exactement les « phrases rivales » du papier : elles ressemblent à la réponse cherchée et lui donnent des valeurs différentes. Avant de raccourcir ou de racheter plus de contexte, il vaut mieux retirer les versions périmées, dater ce qui reste et repérer les contradictions.
Le papier ne l’a pas testé sur de grands modèles ni sur de vrais documents d’entreprise : c’est une direction cohérente avec ses mesures, et l’auteur ne l’a pas validée par une expérience de nettoyage. Elle va dans le même sens que la fiche sur la mémoire d’agent où un RAG simple sur l’historique brut devance les systèmes complexes, et elle complète le papier NVIDIA publié la même semaine : les deux invitent à contrôler ce qui entre dans le contexte plutôt qu’à l’agrandir.
D’où vient ce papier
Le post de DAIR.AI du 4 novembre 2026 (13 h 35, heure de Paris) présente ce papier avec le lien arXiv et un lien « Chat with Paper » ; Elvis Saravia (@omarsar0) l’a republié le même jour. Nous avons lu la version officielle sur arXiv : tous les chiffres ci-dessus viennent du papier, pas du post. Quelques écarts avec le post :
Le post écrit que la réussite tombe « entre 16 % et 33 % » avec les phrases proches de la réponse. Le papier donne 11 % à 21 % pour Qwen2.5-1.5B et 17 % à 40 % pour Qwen2.5-0.5B ; nous n’y avons pas trouvé 16 % à 33 %. Le post écrit 97 % à 100 % pour 32 000 jetons de texte neutre sur Qwen2.5-1.5B : c’est la fourchette du résumé du papier, mais le corps du texte donne 96 % à 100 % de 8 000 à 32 000 jetons (98 % à 32 000). Les « 58 % » et « 8 % » de variance valent pour 512 à 2 048 jetons sur cinq modèles, et le logarithme de la longueur est la variable testée ; entre 8 000 et 32 000 jetons, l’attention explique 32 % à 33 % de la variance. Enfin, le conseil de dédoublonner les affirmations avant de les donner au modèle est une recommandation de l’auteur dans sa discussion, pas un résultat mesuré.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.04169
- Le PDF : https://arxiv.org/pdf/2611.04169
- Le code : https://github.com/yliusci/length-is-cheap
- Les données : https://huggingface.co/datasets/yliusci/length-is-cheap
- Le post de DAIR.AI : https://x.com/dair_ai/status/2117958798841434118
- La republication d’Elvis Saravia : https://x.com/omarsar0/status/2117969801708487042