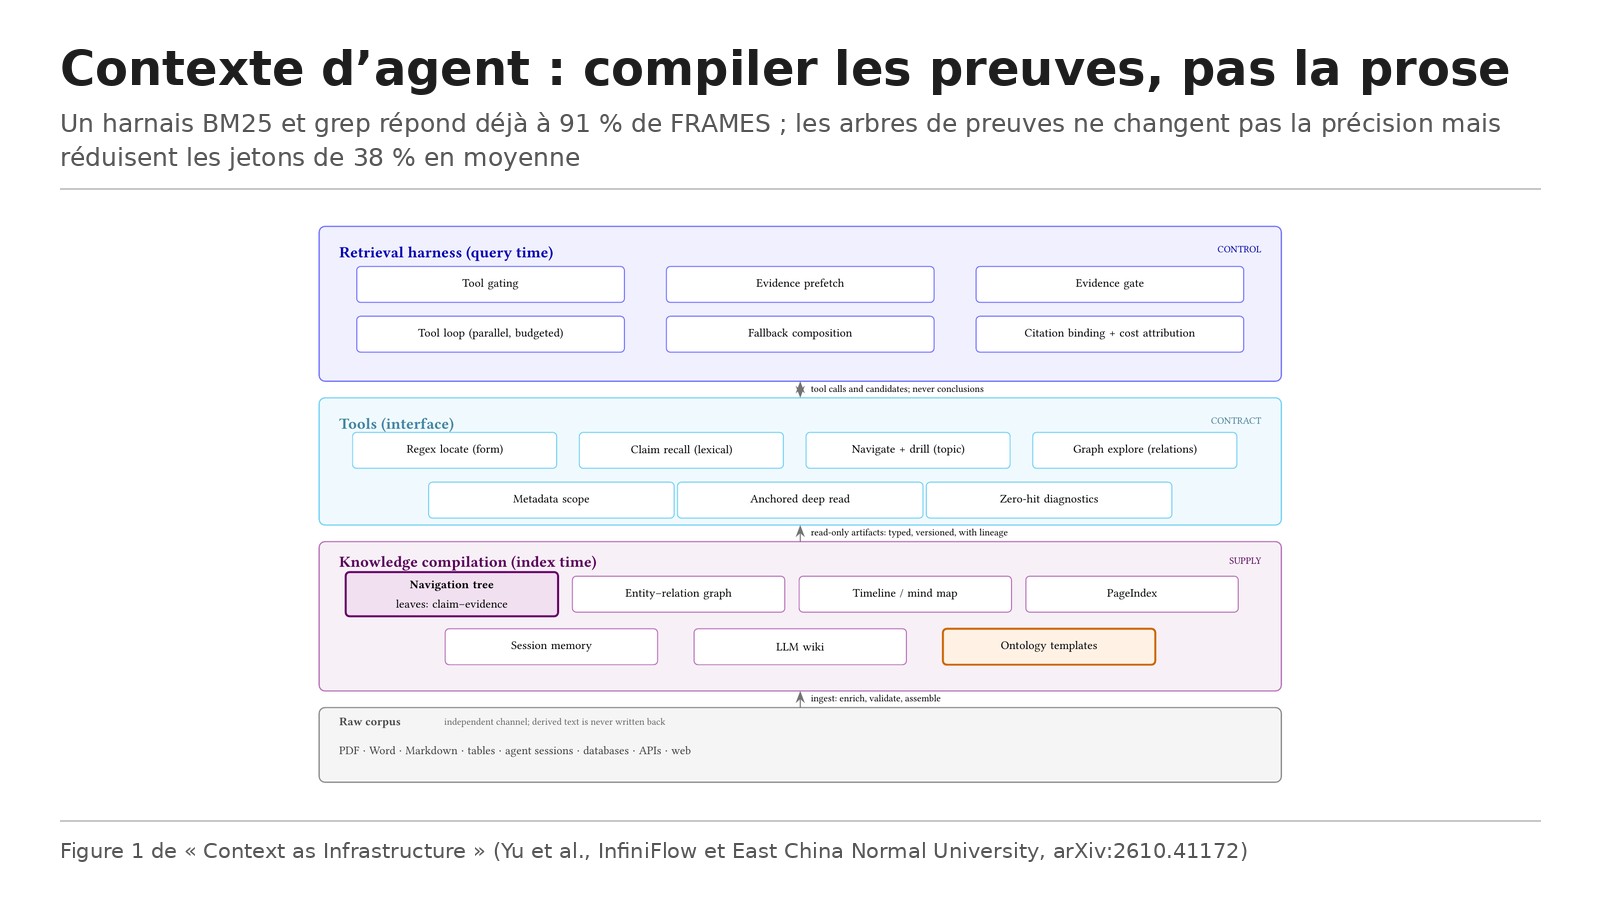
Titre original : Context as Infrastructure: Knowledge Compilation for Retrieval in Agentic Systems with Harnesses
Auteurs : Zhichang Yu, Baining Cao, Sbaaoui Idriss, Qi Wang, Gangqiang Xu, Ling Qin, Xiaoling Jin, An Liu, Shaohao Cai, Xiaoyang Bao, Shengle Chen, Changchang Ding, Pengfei Zhu, Jingxiang Xu, Yifeng Mao, Lu Liu, Hai Jin et Yingfeng Zhang (18 auteurs).
Affiliations : InfiniFlow Inc. (Shanghai) pour presque tous les auteurs ; Baining Cao est à l’East China Normal University (Shanghai). Le système décrit est implémenté dans le projet libre RAGFlow.
Publication : prépublication arXiv 2610.41172v1 (cs.IR), déposée le 30 octobre 2026, 13 pages et 2 figures.
Liens : page arXiv, PDF, projet RAGFlow.
L’idée en bref
Le RAG (retrieval-augmented generation, génération appuyée sur une recherche documentaire) change de nature : un agent, appelé ici le harnais de recherche, écrit lui-même ses requêtes, lit ce qu’il trouve, reformule et décide quand s’arrêter. Selon les auteurs, cela règle l’essentiel du problème de précision. Il reste un problème de contexte : une boucle sans discipline répète les mêmes requêtes, relit les mêmes documents et remplit la fenêtre de passages jamais utilisés.
Leur réponse est la « compilation de connaissances » : une chaîne de préparation, exécutée une fois avant les questions, où un modèle enrichit les documents avec ce qu’aucun morceau ne contient seul (affirmations avec preuve textuelle, graphes d’entités, chronologies, wikis, mémoire). Le papier teste surtout un artefact, un arbre de navigation dont les feuilles sont des paires affirmation-preuve, et il est franc sur ce qui ne marche pas.
Ce que montre le papier
Un harnais minimal suffit pour la précision
Avec uniquement BM25 (recherche lexicale classique) et grep (recherche de texte exact), et MiniMax M3 comme modèle de réponse, les auteurs obtiennent 85 % sur BrowseComp-Plus et 91 % sur FRAMES (une série de questions à plusieurs étapes sur Wikipédia), sans aucun index compilé ni vectoriel. Le papier précise que les deux chiffres ne sont pas comparables : BrowseComp-Plus consomme environ 3 millions de jetons par question, FRAMES environ 324 000 (tableau 4 et section 8.7). Les auteurs disent aussi que l’ajout d’une branche de recherche vectorielle a fait baisser la précision dans leurs essais, car l’agent effectue déjà lui-même l’étape sémantique en reformulant.
Résumés, plans, wikis et graphes n’améliorent pas la précision
Sur FRAMES complet, un arbre de résumés de type RAPTOR, un wiki rédigé par un modèle et un graphe d’entités et de relations ne donnent aucun gain de précision détectable (tableau 3). Un plan de type PageIndex (une table des matières du document, utilisée pour router la recherche) se révèle un handicap à l’échelle de FRAMES. Les auteurs avancent quatre raisons. Le harnais s’adapte déjà : grep puis lecture revient à construire un index à la demande. Une structure ne contient pas de faits nouveaux, elle ne fait que reformuler. Les erreurs d’extraction s’accumulent : selon un modèle analytique des auteurs, un niveau de plan juste à 95 % donne environ 75 % de routage correct de bout en bout sur 105 documents, avec huit branches par niveau. Enfin, naviguer coûte des tours et du contexte à l’agent.
Les arbres de preuves réduisent le coût en jetons
Ce qui marche, c’est de ne compiler que des paires affirmation-preuve. Une petite équipe de modèles les extrait (ici glm-4-flash, sans modèle de pointe), et chaque preuve est vérifiée comme extrait exact de la source, sinon la paire est écartée. À la lecture, le harnais remplace un morceau localisé par ses paires, et une porte de décision, un petit modèle de décision de Qwen, juge si la preuve suffit ou s’il faut ouvrir le texte brut.
Sur 200 questions de FRAMES, quand la porte juge la preuve suffisante, le nombre total de jetons de la requête baisse de 91 %. Quand elle ne la juge pas suffisante, il augmente de 1,9 %, car l’agent paie la projection puis relit le morceau. En moyenne, la baisse est de 38 %, sans changement de précision fiable (tableau 4). Le tableau donne aussi, pour le bras avec preuves et porte de décision, 155 305 jetons en moyenne contre 324 479 pour la version non compilée, soit moins 52 % ; les auteurs précisent que ce chiffre est une moyenne par bras, qu’on ne peut pas comparer aux 91 % ni aux 38 %. Sans preuves, la même porte économise environ 30 % en évitant des lectures profondes qui ne changeaient pas la réponse.
Un seuil de rentabilité très bas
Le papier en tire une formule. La compilation devient rentable dès que la preuve suffit dans environ 2 % des cas, et le taux mesuré est d’environ 43 %, ce qui est en réalité un taux d’acceptation par la porte, jugé par les auteurs comme un indicateur de la suffisance (section 8.6). Pour une collection dont la compilation coûte dix requêtes, le retour se fait après environ 26 requêtes. Mais le seuil de 2 % vaut pour un très grand nombre de requêtes : pour un pilote de 1 000 requêtes et un coût de dix requêtes, il faut déjà 3,12 %.
Les jetons s’achètent avec du temps
Sur sept questions auxquelles les deux variantes ont répondu, la page d’évidences divise les jetons par deux environ mais multiplie le temps de réponse par trois environ, car un morceau de preuve plus petit demande plus de tours de recherche pour converger. Avec l’arbre de feuilles d’affirmations présent, la porte de décision fait ensuite passer la latence moyenne de bout en bout de 140 secondes à 30 secondes (tableau 4). Le tableau donne 46,7 secondes pour la version non compilée.
Les limites
Les auteurs reconnaissent que (section 8.8) :
- les mesures viennent d’un seul banc d’essai (FRAMES, en anglais, sur Wikipédia), d’un seul compilateur et d’un seul modèle de réponse ;
- ils ne donnent aucun intervalle de confiance ni plusieurs essais : les variantes structurelles ont été lancées une seule fois, et « neutre » veut dire non distinguable d’une variation d’un essai à l’autre, pas « prouvé identique » ;
- la dégradation du plan PageIndex est une observation à l’échelle de FRAMES, pas une loi générale, et les 75 % de routage sont un calcul, pas une mesure ;
- le taux de fausses acceptations de la porte n’est pas mesuré : l’audit prévu, de 100 à 400 exemples étiquetés, n’a pas été fait ;
- les bénéfices pour les ontologies, graphes, wikis, chronologies et mémoires sont des hypothèses de déploiement : le tableau 2 est un protocole dont aucune ligne n’a encore atteint sa cible, et chacune est marquée « aucun effet mesuré » ;
- ils précisent que leurs résultats concernent des textes anglais, des harnais BM25 et grep et des questions-réponses, et que des corpus d’entreprise avec tableaux, scans et jargon peuvent donner une extraction de moindre qualité, donc plus d’échecs et moins d’économies.
Réserves de notre lecture :
- l’équipe qui publie est celle qui édite RAGFlow, et le papier décrit son propre produit sous le nom de « base de données native pour agents » ;
- le comparatif de latence entre variantes repose sur sept questions, et la moyenne de 140 secondes n’est pas celle de la version non compilée (46,7 secondes d’après le tableau 4), sans que le papier précise le nombre de requêtes de chaque bras ;
- le papier ne fournit pas de résultats question par question, et rien ne dit si ces ordres de grandeur tiennent sur de vrais documents d’entreprise.
Lecture Neurone21
Pour une équipe qui construit un agent de recherche sur ses documents, le papier déplace la question habituelle. Avant d’investir dans un index vectoriel, un graphe ou un wiki, il faut vérifier si un agent muni de BM25 et de grep répond déjà correctement : c’est le cas sur les deux bancs d’essai des auteurs. Le travail utile se situe alors ailleurs, dans le coût de lecture, par exemple en fournissant à l’agent des extraits sourcés plutôt que des pages entières, avec un repli vers le texte brut.
Un exemple concret : sur une base de contrats ou de notices techniques, remplacer chaque passage trouvé par deux ou trois phrases de preuve citées mot pour mot réduit la facture en jetons, à condition de mesurer la fréquence des cas où ces phrases ne suffisent pas, car le seuil de rentabilité dépend surtout de ce taux d’échec. Le papier le dit lui-même : ce qu’il faut mesurer avec soin, c’est la fréquence des projections ratées.
Le résultat rejoint ceux de nos fiches sur le RAG simple qui devance la mémoire complexe et sur DecisionRAG, et il complète notre dossier sur le harnais des agents IA. À lire avec prudence : les économies de jetons s’accompagnent d’un temps de réponse plus long, et les chiffres viennent de l’éditeur de la solution testée.
Le résumé de DAIR.AI, repris par Elvis Saravia, est fidèle aux chiffres. Nuances : la latence de 140 à 30 secondes est une moyenne par bras, au nombre de requêtes non précisé, et le papier note par ailleurs que la substitution de preuves triple la latence sur sept questions ; « aucun gain de précision » signifie non détectable dans un seul essai ; et les 85 % et 91 % concernent deux bancs d’essai que les auteurs déclarent non comparables.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.41172
- Le PDF : https://arxiv.org/pdf/2610.41172
- Le projet RAGFlow : https://github.com/infiniflow/ragflow
- Le post de DAIR.AI, repris par Elvis Saravia : https://x.com/dair_ai/status/2117274289154252866
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/context-as-infrastructure-knowledge-compilation-for-retrieval-in-agentic-systems-2610.41172