Titre original : Retriever-Free Retrieval: Navigating Documents with Decision Models
Auteurs : Chao Wan et Paul Jünger (contribution égale), Beixi Du, Bodong Liu (département d’informatique de l’université Cornell, New York), Navaneetha Krishnan (ASAPP) et Kilian Q. Weinberger (Cornell et ASAPP).
Publication : prépublication arXiv 2610.35868v1 (cs.AI), déposée le 26 octobre 2026, 21 pages avec annexes. Travail financé notamment par la National Science Foundation américaine. Le PDF ne mentionne pas de publication du code.
Liens : page arXiv, PDF.
L’idée en bref
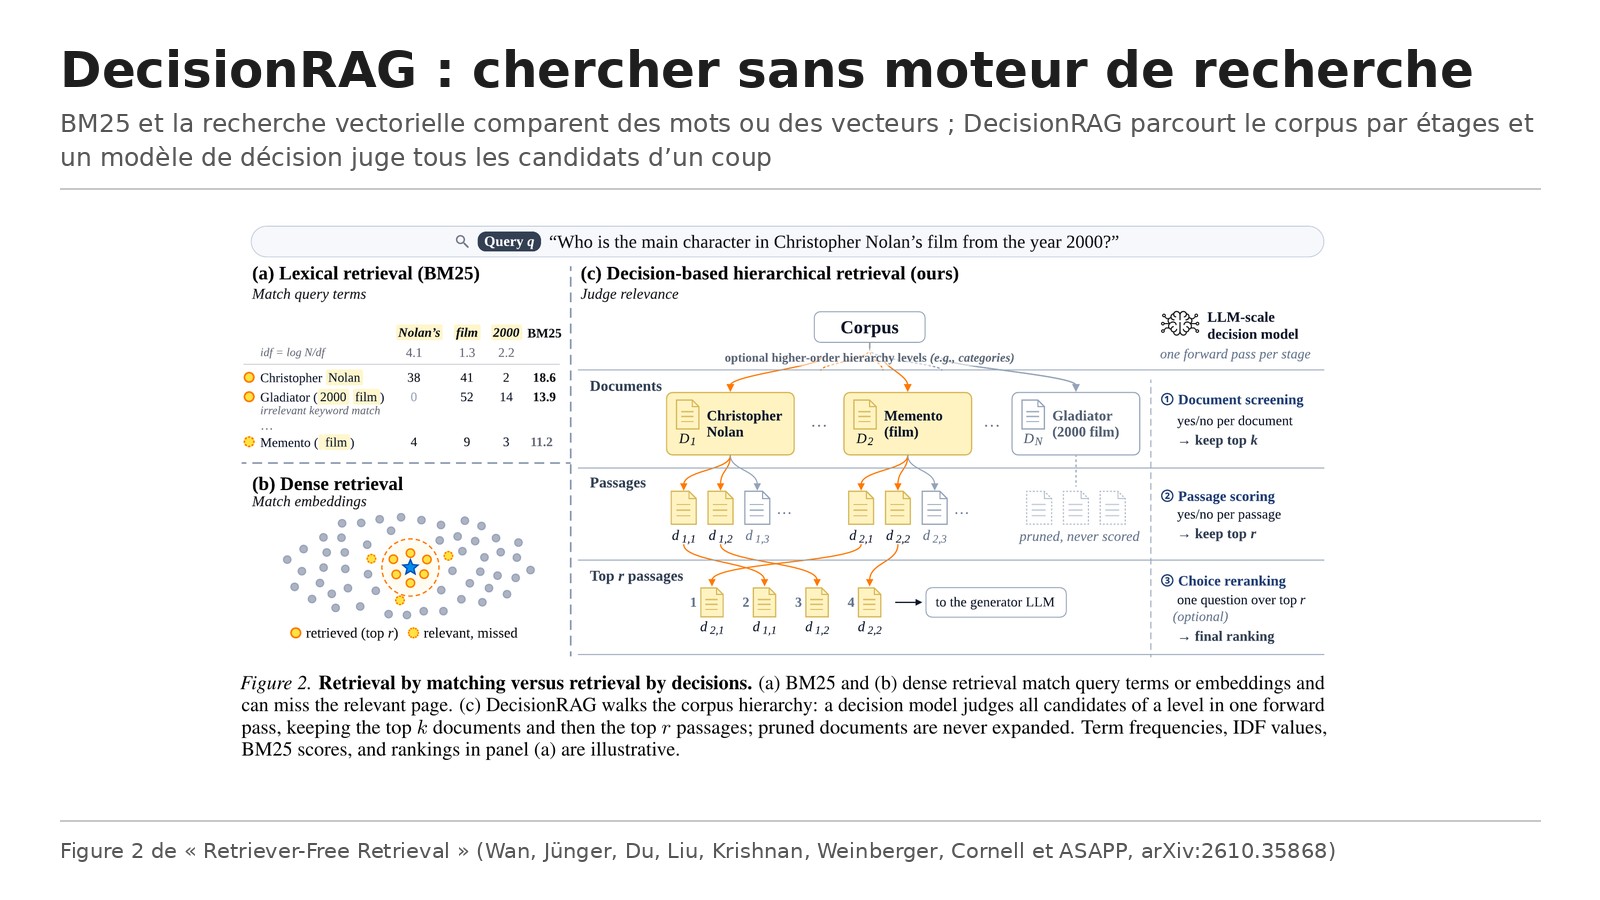
Un système RAG classique commence par un « retriever » : une recherche par mots-clés (BM25) ou par similarité de vecteurs (recherche dense) ramène une centaine de passages, qu’un reranker ou un grand modèle reclasse ensuite. Si le bon passage n’est pas dans cette première pêche, rien ne peut le rattraper.
DecisionRAG supprime cette première étape. Le corpus est organisé en hiérarchie (par exemple centre d’aide, puis page, puis passage), et un modèle de décision la parcourt de haut en bas. À chaque niveau, il reçoit la question et la liste des candidats dans un même contexte, et rend pour chacun une probabilité de « oui » en une seule passe, sans générer de texte. Le système garde les meilleurs, descend d’un étage et recommence. Le modèle utilisé est Jev 1.13, un modèle de décision commercial de TypeSafe AI, appelé via OpenRouter, sans aucun réglage pour ces tâches (sections 3 et 4).
Ce que montre le papier
Mieux qu’une recherche dense suivie d’un reranker, sans entraînement
Sur quatre jeux de test (tableau 2), DecisionRAG dépasse la meilleure chaîne classique, une recherche dense Qwen3-Embedding-8B suivie du reranker Qwen3-Reranker-8B sur les 100 premiers résultats : 47,4 % contre 33,6 % en R@1 sur MultiDoc2Dial (+13,8 points) et 65,4 % contre 48,0 % en Hit@1 sur Natural Questions (+17,4 points). Sur Natural Questions, le parcours porte sur 108 626 pages Wikipédia et 2,68 millions de paragraphes, regroupés en 1 000 grappes thématiques ; le système n’examine finalement que 16 % des titres de pages (section 5).
Face à GPT-5, un match plus serré
Comparé à un reclassement par GPT-5 des 20 premiers résultats denses, l’avantage est plus mince : 65,4 % contre 60,8 % en Hit@1 sur Natural Questions, 34,2 % contre 31,8 % en R@5 sur MTRAG, quasi-égalité sur MultiDoc2Dial (47,4 % contre 47,5 % en R@1), et GPT-5 reste devant en Hit@1 sur ConditionalQA (73,4 % contre 69,7 %). DecisionRAG se distingue surtout en rappel : 71,9 % contre 64,0 % en R@10 sur ConditionalQA. En ajoutant les candidats de la recherche dense au dernier étage, le R@10 monte à 84,7 % sur MultiDoc2Dial et 88,9 % sur Natural Questions.
Sur la qualité des réponses finales, avec Qwen3.5-27B comme générateur, 44,1 % des réponses sont jugées correctes sur MTRAG contre 39,4 % avec le reranker Qwen3, et 47,3 % avec les candidats denses en plus (section 5).
Rapide, mais pas toujours moins cher
La recherche prend 0,68 à 1,76 seconde par requête en médiane, contre 3,3 à 14,3 secondes pour la chaîne dense avec reranker Qwen3 servie sur une carte NVIDIA RTX A6000, et 11,8 à 15,0 secondes pour le reclassement GPT-5. Le coût d’API va de 0,22 centime par requête sur MultiDoc2Dial à 2,33 centimes sur Natural Questions. Sur ces deux jeux, c’est respectivement six fois moins et environ 1,7 fois plus que le reclassement par GPT-5 (1,40 centime) ; sur MTRAG, les coûts sont proches (1,73 contre 1,90 centime) (tableau 5).
Juger les candidats ensemble aide
Évaluer les passages de toutes les pages retenues dans un même contexte, plutôt que page par page, fait passer le R@1 de 36,7 % à 44,4 % sur MultiDoc2Dial (+7,7 points) ; le gain atteint 6,5 points de Hit@1 sur Natural Questions. Découper une liste trop longue en plusieurs requêtes d’au moins 50 candidats ne coûte rien en précision (section 6). Comparé à une navigation de la même hiérarchie par GPT-5 générant ses choix en texte, DecisionRAG est 34 à 145 fois plus rapide et 21 à 25 fois moins cher, sans gain régulier pour GPT-5 (il devance DecisionRAG de 4,1 points de Hit@1 sur ConditionalQA, écart que l’ajout des candidats denses comble, et reste 6,0 points derrière sur Natural Questions).
Un petit modèle entraîné fait encore mieux
En entraînant un modèle de décision de 8 milliards de paramètres (dérivé de Qwen3-8B) sur des données du domaine, le R@1 atteint 60,7 % sur MultiDoc2Dial, 5,7 points au-dessus du meilleur système entraîné publié parmi ceux que les auteurs comparent (55,0 %).
L’élagage, levier de coût
Sur Natural Questions, ne garder que 15 % des grappes au premier étage donne un rappel équivalent à l’évaluation directe des 108 626 titres de pages (86,2 % contre 84,5 % en R@10), pour un cinquième du coût (2,3 contre 12,1 centimes par requête) et un tiers de la latence (1,7 contre 4,5 secondes). En dessous de 5 %, la qualité chute, jusqu’à 63,7 % en gardant seulement 1 % des grappes (section 6.6, figure 7).
Les limites
Les auteurs reconnaissent que (section 7) :
- la méthode suppose une hiérarchie de documents dont la structure et les descriptions permettent au modèle de repérer les bonnes branches ; des documents mal organisés ou des descriptions pauvres dégradent la recherche ;
- l’élagage est irréversible : un passage pertinent est perdu si son ancêtre est écarté, ce que des budgets d’exploration plus larges ou l’ajout de la recherche dense compensent en partie.
Réserves de notre lecture, tirées du papier :
- Les résultats sans entraînement reposent sur Jev 1.13, un modèle commercial accessible par API ; la reproductibilité dépend de ce fournisseur.
- Sur Natural Questions, l’évaluation porte sur 500 questions ; sur MultiDoc2Dial, le jeu de test publié étant inutilisable, les auteurs évaluent sur le jeu de validation ; sur MTRAG, les passages pertinents ont été complétés par un jugement de GPT-5.
- Pour Natural Questions, la hiérarchie a dû être construite : regroupement des pages en 1 000 grappes et résumés rédigés par Qwen3-8B. Ce travail préparatoire a un coût qui ne figure pas dans le coût par requête.
- Le gain en coût n’est pas général : sur le plus gros corpus, DecisionRAG coûte plus cher par requête que le reclassement par GPT-5.
Lecture Neurone21
Pour une entreprise, le cas le plus parlant est celui de la documentation déjà rangée : un centre d’aide, une base de procédures, un intranet organisé par services. Là, la hiérarchie existe déjà, et la méthode évite de maintenir un index vectoriel tout en répondant en une à deux secondes. Pour un tas de documents sans structure, il faut d’abord bâtir cette hiérarchie, et le bénéfice est moins évident.
Ce papier complète utilement notre fiche sur les modèles de décision utilisés comme reclasseurs, qui concluait qu’un reranker entraîné pour la tâche les égalait ou les battait. Ici, l’intérêt des modèles de décision ne vient pas du reclassement seul mais du parcours complet de la structure du corpus, avec des candidats jugés ensemble. Sur la question plus large de savoir quand un RAG simple suffit, voir aussi la taxe de la mémoire des agents.
Le post d’Elvis Saravia reprend correctement les chiffres principaux (+13,8 et +17,4 points, 2,68 millions de paragraphes, 0,7 à 1,8 seconde, 0,2 à 2,3 centimes, jusqu’à 7,7 points grâce au jugement groupé, 60,7 % pour le modèle entraîné). Il ne dit pas que le modèle utilisé est un modèle commercial de TypeSafe AI, ni que face à GPT-5 l’avantage est mince et parfois inversé, ni que sur Natural Questions le coût par requête dépasse celui du reclassement par GPT-5.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.35868
- Le PDF : https://arxiv.org/pdf/2610.35868v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115810394614960516
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/retriever-free-retrieval-navigating-documents-with-decision-models-2610.35868