Titre original : System One Models Are Not Better Rerankers
Auteurs : Michael Dinzinger (université de Passau), Kanishka Ghosh Dastidar (Interdisciplinary Transformation University Austria, IT:U, Linz), Michael Granitzer (université de Passau et IT:U)
Publication : prépublication arXiv 2610.32318v1 (cs.CL), déposée le 23 octobre 2026, 8 pages avec la bibliographie. Le code, les probabilités produites par chaque modèle et tous les résultats sont publics.
Liens : page arXiv, PDF, code et données.
L’idée en bref
Dans un moteur de recherche ou un RAG, un premier outil rapide (souvent BM25) ramène une centaine de passages candidats, puis un reranker, ou reclasseur, les remet dans le bon ordre. Depuis septembre 2026, une nouvelle famille de modèles est apparue : les « System One models », ou modèles de décision. Au lieu de générer du texte, ils répondent à une question par une probabilité qu’on dit calibrée, c’est-à-dire fiable comme pourcentage. TypeSafe AI a publié le premier, Jev, le 15 septembre 2026, entraîné avec une méthode non publiée appelée RLCD. Des équivalents ouverts ont suivi : Kev et Clef (Cloudflare), construits sur des modèles Qwen.
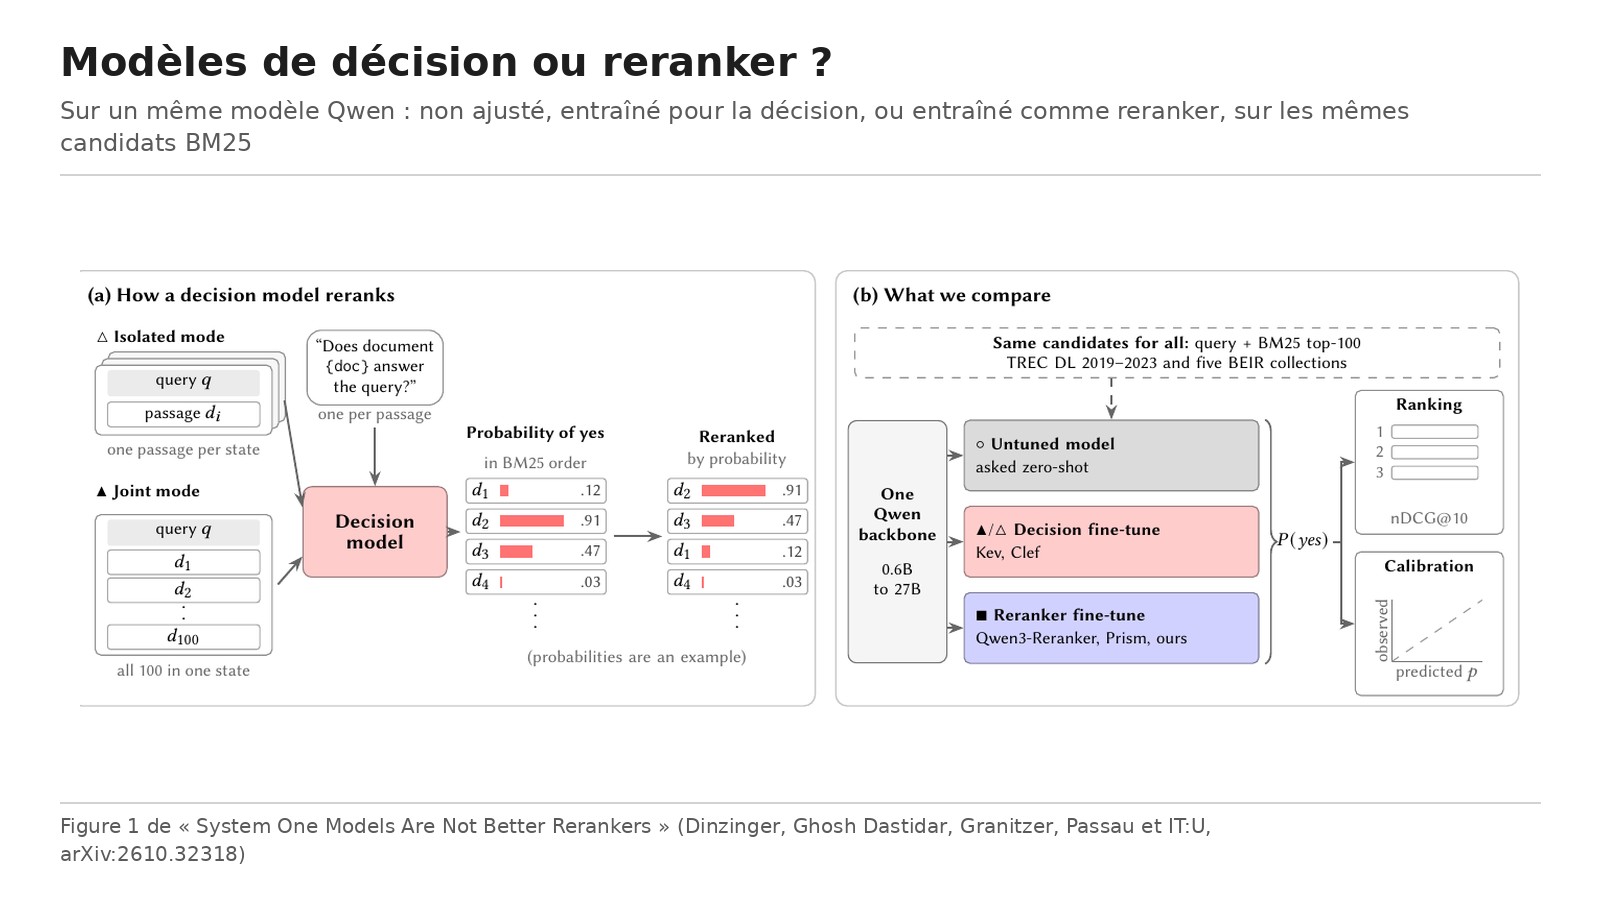
En quelques semaines, ces modèles ont été utilisés comme reclasseurs : on leur demande « ce document répond-il à la requête ? » et on trie les passages par probabilité de « oui ». Les auteurs posent une question simple : ce qui marche vient-il de l’entraînement « décision », ou du modèle de base ? Pour le savoir, ils comparent sur un même modèle Qwen trois versions : le modèle non ajusté interrogé directement, sa version entraînée pour la décision et sa version entraînée comme reranker classique.
Ce que montre le papier
Un protocole propre
Six modèles Qwen de 0,6 à 27 milliards de paramètres servent de base. Chaque version reclasse exactement les mêmes 100 premiers candidats de BM25, sur dix collections : cinq éditions de TREC Deep Learning (2019 à 2023) et cinq collections BEIR (TREC-COVID, NFCorpus, SciFact, Touché et DBPedia). Faute de reranker publié à 9 et 27 milliards de paramètres, les auteurs en entraînent deux eux-mêmes, avec LoRA sur 100 000 requêtes MS MARCO (sections 3 et 4).
Le reranker gagne jusqu’à 9 milliards de paramètres
De 0,6 à 9 milliards de paramètres, la version entraînée comme reranker classe mieux que les deux autres sur chaque modèle, avec un écart de 5,2 points (59,0 pour Prism-9B contre 53,8 pour Clef-Flash) à 28,8 points (56,1 contre 27,3) de nDCG@10. L’écart est statistiquement significatif sur 48 comparaisons sur 60, et il tient sur les collections qu’aucun des modèles n’a vues à l’entraînement (5,4 à 23,9 points) (tableau 1). À 27 milliards, les deux font jeu égal : 59,6 pour le reranker des auteurs, 60,1 pour Kev-27B.
L’entraînement « décision » n’apporte presque rien au classement
Jusqu’à 9 milliards, la version décision reste entre 2,5 points en dessous et 0,7 point au-dessus du modèle non ajusté auquel on pose la même question. L’entraînement reranker, lui, ajoute de 5,9 à 29,5 points. Autrement dit, quelqu’un qui prend Qwen3.5-4B ou Qwen3.5-9B tel quel et lui demande si le passage répond à la requête obtient le même classement que les modèles de décision bâtis dessus, sans aucun coût d’entraînement (section 5).
Pour situer, Jev obtient 59,1 en moyenne, au niveau des rerankers de 8 et 9 milliards (59,0 à 59,4), pour 1,11 dollar les 1 000 requêtes. Laya, un autre modèle du genre, plafonne à 43,5, à peine au-dessus de BM25 seul (43,2) (tableau 2). Présenter les 100 candidats d’un coup au modèle n’aide que les plus gros : Kev-27B gagne environ un point, mais Kev-0.6B en perd 12,2 et Kev-8B 13,0.
Une calibration qui dépend de la question
C’est l’argument principal des modèles de décision. Avec la question des auteurs, ils sont effectivement mieux calibrés que les rerankers publiés à partir de 4 milliards de paramètres : erreur de calibration de 0,113 pour Kev-8B contre 0,257 pour Qwen3-Reranker-8B, et 0,075 pour Jev, le meilleur de l’étude (tableau 3). Mais avec une formulation un peu plus large, reprise d’un travail antérieur (S1Rank), l’avantage disparaît : l’erreur de Jev monte à 0,224 (tableau 4). Le reranker des auteurs à 9 milliards, entraîné avec une simple perte oui ou non, est d’ailleurs aussi bien calibré que Clef-Flash (0,111 contre 0,112).
La calibration ne rattrape pas un moins bon classement
Quand on garde les passages au-dessus d’un seuil de 0,5, un reranker classe mieux et garde de meilleurs passages : score F1 de 51,0 pour Prism-4B contre 42,6 pour Kev-4B. Pour estimer combien de passages pertinents existent, la somme des probabilités de Kev-8B se trompe en moyenne de 7,6 passages, contre 12,9 pour Qwen3-Reranker-8B. Mais deviner simplement la médiane donne une erreur de 8,6, et le Qwen3.8-27B non ajusté fait mieux que tous, à 5,8. Avec la formulation de S1Rank, aucun modèle de décision ne bat vraiment la médiane (tableau 3).
Les limites
Les auteurs reconnaissent que (section 7) :
- ils comparent des modèles publiés, dont les données d’entraînement diffèrent autant que l’objectif ; le papier décrit l’entraînement « décision » tel qu’il est disponible aujourd’hui, pas la méthode RLCD elle-même, non publiée ;
- leurs propres rerankers à 9 et 27 milliards ont été entraînés une seule fois, avec une seule recette et sans recherche d’hyperparamètres ;
- la calibration n’est mesurée que sur TREC DL, à un seul niveau de pertinence et un seul seuil, et une seule autre formulation de la question a été essayée ;
- tous les modèles de décision ont au plus un mois, et de nouvelles versions peuvent changer le tableau.
Réserves de notre lecture, tirées du papier :
- Le classement de Jev, modèle fermé, est mesuré mais ne peut pas être contrôlé de la même façon : il sert de point de repère, pas de cas d’étude.
- Les collections sont en anglais et la première étape est toujours BM25 : le résultat ne dit rien d’un RAG multilingue avec une recherche par embeddings en amont.
- L’étude porte sur la qualité du classement et de la calibration, pas sur la latence ni le coût de calcul local, qui comptent aussi dans le choix d’un reranker.
Lecture Neurone21
Le message pratique tient en une phrase, que les auteurs écrivent eux-mêmes : si vous avez besoin d’un reranker, entraînez un reranker. Pour une entreprise qui construit un RAG sur sa documentation, cela veut dire qu’un modèle de reclassement spécialisé reste le choix par défaut, et qu’un modèle de décision à la mode ne vaut que s’il bat ce reranker sur vos propres requêtes. La calibration a un vrai intérêt quand on veut un seuil (« ne montrer que les passages sûrs à plus de 80 % ») ou une estimation du nombre de documents pertinents. Mais le papier montre que cette calibration dépend de la manière de formuler la question, et qu’elle doit donc se vérifier sur ses données, avec sa propre définition de « pertinent ».
Pour l’IA locale, la bonne nouvelle est double : un reranker de 0,6 milliard de paramètres, qui tourne sur un poste modeste, garde l’avantage sur un modèle de décision de même taille, et un Qwen de 4 ou 9 milliards interrogé directement fait déjà aussi bien qu’un modèle de décision dérivé. Cette fiche complète celle sur la taxe de la mémoire des agents, publiée le même jour, où un RAG hybride avec un petit reclasseur Qwen bat des systèmes de mémoire bien plus coûteux.
Elvis Saravia rend fidèlement le protocole et les résultats. Il arrondit un peu : « 5 à 29 points » pour l’avance du reranker (5,2 à 28,8 dans le papier) et « 6 à 30 points » pour l’apport de l’entraînement reranker (5,9 à 29,5). Il ne mentionne pas que le reranker de 27 milliards a été entraîné une seule fois par les auteurs, ni que Jev reste un modèle fermé, ni le chiffre clé de calibration de Jev.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.32318
- Le PDF : https://arxiv.org/pdf/2610.32318v1
- Le code et les données : https://github.com/KanishkaGD/decision-rerank
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115176716947833003
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/system-one-models-are-not-better-rerankers-2610.32318