Titre original : Skill++: Towards Lifelong Agents via Routing-Aware Skill Refinement
Auteurs : Hanrong Zhang, Minghao Liang, Jiawei Wu, Yankai Chen, Shicheng Fan, Zhiwei Liu, Enze Ma, Junwei Yuan, Tianyi Wang, Dehai Min, Kening Zheng, Xue Liu et Philip S. Yu.
Affiliations : University of Illinois Chicago, Trip.com Group, Rutgers University, MBZUAI, McGill University, Recursive, et deux chercheurs indépendants.
Publication : prépublication arXiv 2611.00544v1 (cs.AI), déposée le 31 octobre 2026.
Liens : page arXiv, PDF.
L’idée en bref
Un agent de programmation ou de bureau dispose de « compétences » : des dossiers de consignes, que l’agent choisit en lisant seulement leur nom et une courte description. Quand la bibliothèque compte des centaines de compétences, certaines se ressemblent. Le papier décrit deux façons d’échouer. Dans la substitution, une compétence voisine est choisie à la place de la bonne. Dans l’encombrement, des compétences proches occupent les quelques places retenues et la bonne n’est plus sélectionnée. Ces deux cas expliquent 87,5 % des erreurs avec les descriptions d’origine.
Skill++ ne touche ni au routeur (le modèle qui choisit) ni à l’entraînement. À chaque arrivée d’une compétence, il réécrit une seule fois son nom et sa description en tenant compte des compétences déjà présentes qui lui ressemblent le plus. Le papier présente cela comme un problème d’apprentissage continu : la bibliothèque grossit par lots et les anciennes compétences doivent rester utilisables.
Ce que montre le papier
La méthode
Trois éléments sont réécrits. La description est refaite à partir du contenu de la compétence : elle ne dit que ce que le contenu permet vraiment, et commence par ce qui la distingue de sa voisine la plus proche, sans la nommer. Des exclusions indiquent ce que la compétence ne couvre pas. Le nom est précisé quand il commence comme celui d’une compétence existante. Un petit modèle de langage fait l’écriture (Gemini 3.5 Flash-Lite dans l’étude), avec un modèle d’embeddings pour trouver les voisines. Aucune requête étiquetée n’est nécessaire.
Les résultats principaux
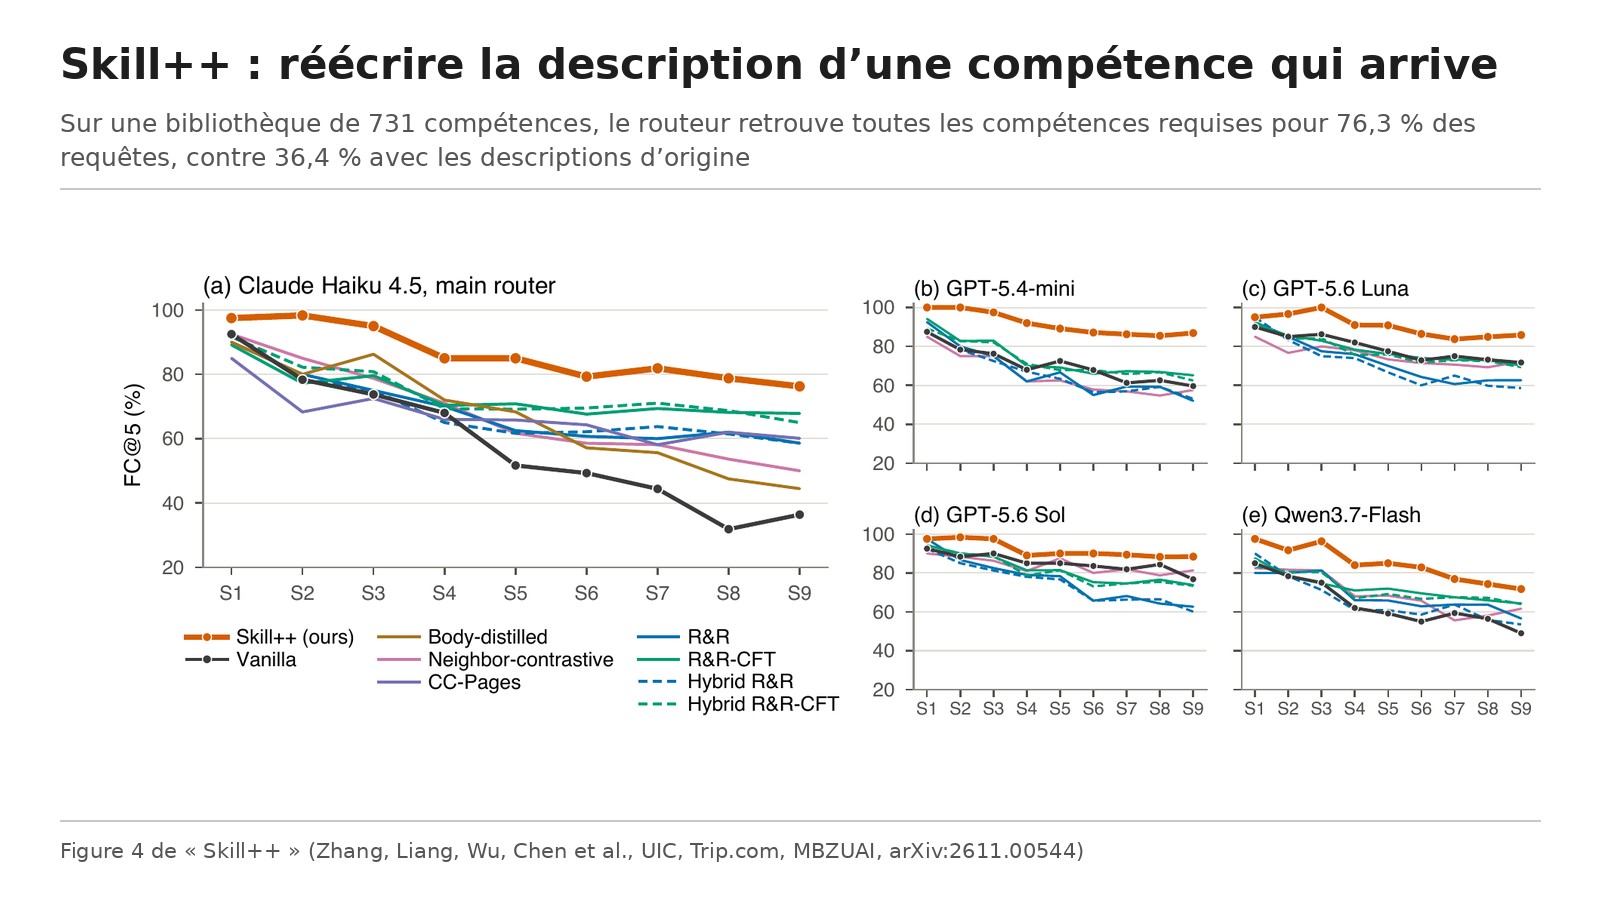
L’étude principale fait grandir une bibliothèque de 27 à 731 compétences en dix sessions, avec 198 requêtes et le routeur Claude Haiku 4.5. La mesure est la couverture complète : la part des requêtes dont toutes les compétences nécessaires figurent parmi les cinq retenues. Avec les descriptions d’origine, elle tombe de 92,5 % à 36,4 %. Avec Skill++, elle reste à 76,3 % et passe devant les méthodes comparées à chaque étape. La meilleure méthode concurrente atteint 67,8 %, et une méthode appelée CC-Pages, 60,1 %.
Sur trois jeux d’essai et cinq routeurs, la couverture à la dernière session gagne en moyenne 23,1 points de pourcentage par rapport aux descriptions d’origine. Sur les deux autres jeux, dont les bibliothèques atteignent environ 2 000 compétences, la moyenne sur les sessions 1 à 9 gagne 10,9 et 12,4 points, et la dernière session 14,4 et 18,9 points.
Les compétences qui arrivent ne sont pas pénalisées : sur les requêtes écrites à partir de leur contenu, la compétence visée est classée première pour 56,9 % d’entre elles avec Skill++, contre 51,9 % avec les descriptions d’origine. Et parmi les 115 requêtes bien routées au départ, 62 échouent à la fin avec les descriptions d’origine, contre 33 sur 177 avec Skill++ (le papier compte ici 115 requêtes bien routées au départ pour les descriptions d’origine et 177 pour Skill++).
Dans un vrai agent
Les auteurs répètent l’expérience dans l’outil Codex CLI, avec GPT-5.6 Luna et GPT-5.6 Sol. La couverture moyenne sur les sessions 1 à 9 dépasse celle des descriptions d’origine de 34,3 points avec Luna et de 11,1 points avec Sol. Sur une bibliothèque de 87 compétences et 150 requêtes, la couverture passe de 33,3 % à 77,3 % avec Luna et de 82,0 % à 88,0 % avec Sol, et la réussite aux tests cachés progresse de 4,0 et 0,7 points.
Chaque composant compte
À la dernière session, la couverture tombe de 76,3 % à 56,6 % sans la différenciation de la description, à 64,6 % sans les exclusions et à 61,6 % sans la précision du nom. La différenciation est donc la pièce la plus importante.
Les limites
- L’étude principale repose sur 198 requêtes et un seul routeur de base ; les cinq routeurs et trois jeux d’essai donnent des résultats dans le même sens, mais l’écart varie beaucoup : Skill++ n’ajoute que 3,0 points à la dernière session avec GPT-5.6 Sol dans Codex CLI, qui sélectionnait déjà bien ;
- les bibliothèques sont construites par les auteurs, qui ajoutent à chaque session des candidates proches des compétences requises ; ce n’est pas une bibliothèque observée en production ;
- la mesure principale est la sélection des compétences ; la réussite finale des tâches n’est testée que sur une petite bibliothèque et gagne peu (4,0 et 0,7 points) ;
- Skill++ réécrit une fois à l’arrivée : il ne remet pas en cause les descriptions d’origine des anciennes compétences quand une nouvelle arrive.
Lecture Neurone21
Le message utile est simple : la description d’une compétence est du texte d’aiguillage, et elle doit se lire à côté des autres compétences, pas seule. Si votre agent dispose déjà d’une compétence « rapport mensuel de ventes » et que vous en ajoutez une « rapport trimestriel de ventes », une description qui dit seulement « génère des rapports de ventes » les rend interchangeables. Une description qui précise la période et indique « ne couvre pas le rapport mensuel » évite que l’agent prenne l’une pour l’autre.
Pour une équipe qui monte sa bibliothèque d’outils agentiques, cela se met en pratique sans outil : à chaque ajout, relire les trois compétences les plus proches, écrire ce qui distingue la nouvelle et ce qu’elle ne fait pas. Le papier mesure l’effet d’une version automatique, pas celui de cette relecture manuelle ; elle n’en reprend que l’idée. Nos fiches sur les compétences dans Gemini et sur la collection de compétences de NVIDIA montrent la même tendance : ces bibliothèques grossissent vite.
D’où vient ce papier
Le post de DAIR.AI du 3 novembre 2026 ne contient qu’une image, sans lien ni titre dans le texte. Elvis Saravia (@omarsar0) l’a repris en citation. Nous avons identifié le papier à partir de l’image, puis lu la version officielle sur arXiv : tous les chiffres ci-dessus viennent du papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.00544
- Le PDF : https://arxiv.org/pdf/2611.00544
- Le post de DAIR.AI : https://x.com/dair_ai/status/2117612013258228030
- La citation d’Elvis Saravia : https://x.com/omarsar0/status/2117744698039095459