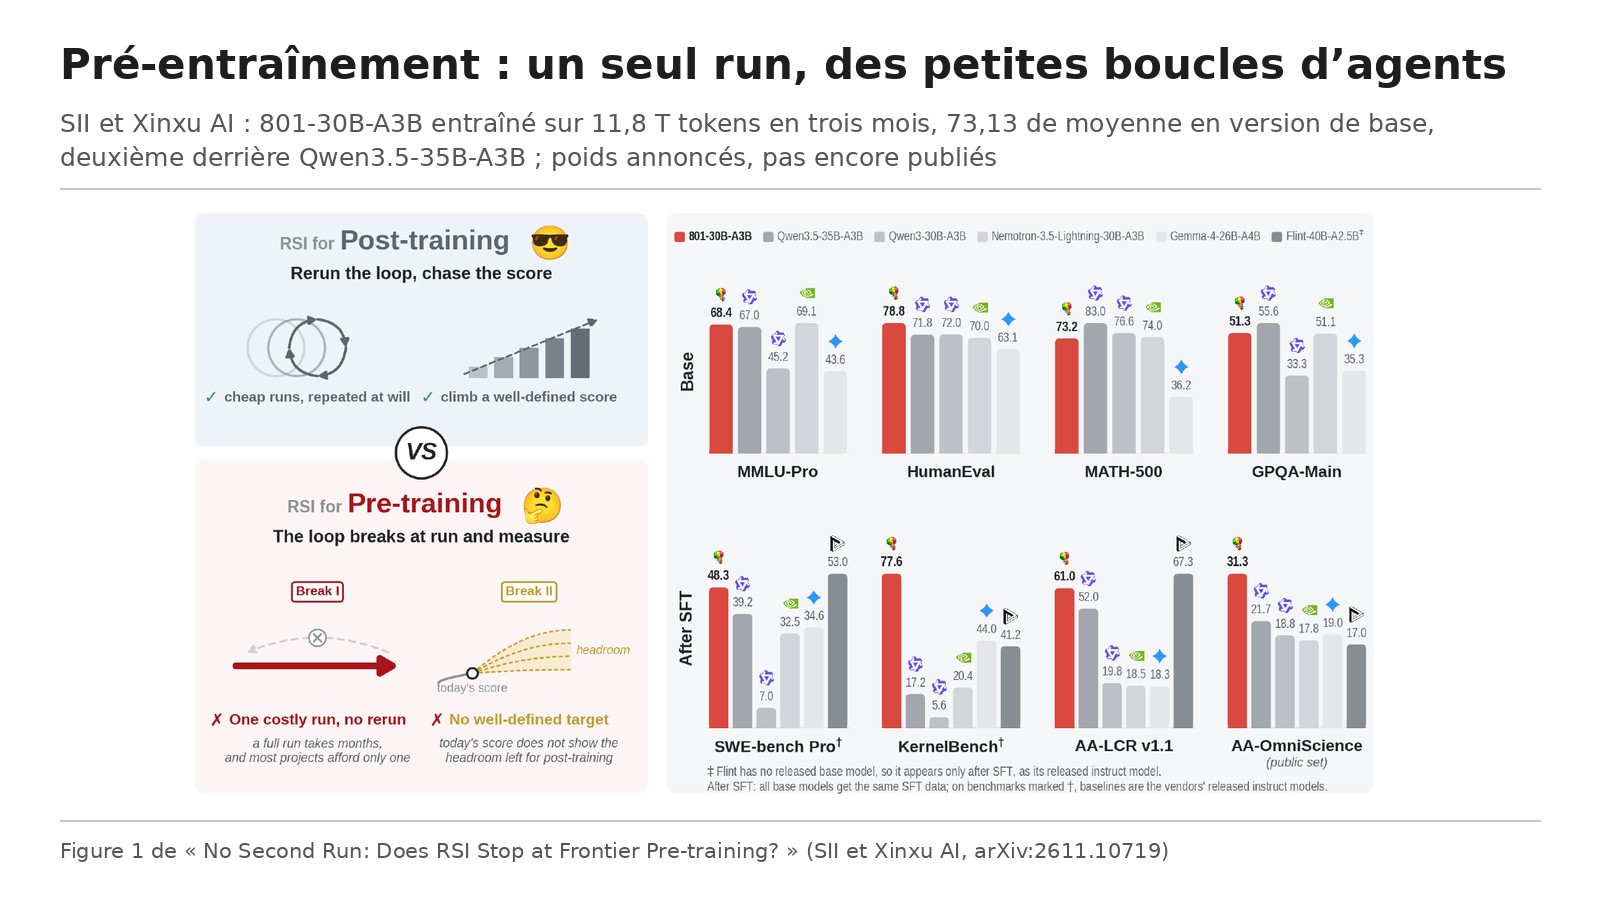
Titre original : No Second Run: Does RSI Stop at Frontier Pre-training?
Auteurs : 59 contributeurs listés par ordre alphabétique, de Xiaojie Cai à Haoyang Zou, parmi lesquels Pengfei Liu, Yu Qiao et Xipeng Qiu.
Affiliations : SII et Xinxu AI. Le rapport porte la marque SII-GAIR et le dépôt est publié sous l’organisation GitHub GAIR-NLP.
Publication : rapport technique déposé sur arXiv le 7 novembre 2026 (2611.10719v1, cs.AI). Le jeu de données d’ajustement (Tiny-SFT) est en ligne sur Hugging Face. Le modèle 801-30B-A3B-Base est annoncé, mais au 16 novembre 2026 le dépôt GitHub indique encore « coming soon » pour les poids.
Liens : page arXiv, PDF, dépôt GitHub, données Tiny-SFT.
L’idée en bref
L’auto-amélioration récursive (RSI, pour recursive self-improvement) désigne un système qui transforme ses propres résultats en changements durables, selon la boucle proposer, exécuter, mesurer, mettre à jour. Elle marche aujourd’hui en post-entraînement : on part d’un modèle existant, chaque essai coûte quelques heures GPU et rend un score vérifiable.
Le pré-entraînement casse ces trois conditions. Un run complet consomme des centaines de milliers d’heures GPU sur des mois, et la plupart des équipes n’en ont qu’un. Son vrai objectif n’est pas le score du jour mais la marge de progression laissée au post-entraînement, qu’aucun score unique ne mesure. Et ce qu’il faut améliorer n’est pas un modèle mais toute une chaîne de production : dans ce projet, six pipelines de données à plus de 30 étapes produisant 1 053 sous-ensembles et 10,5 T tokens uniques, plus de 130 versions du code d’infrastructure, 106 paramètres d’entraînement, et des équipes séparées pour les données, l’infrastructure, l’entraînement et l’évaluation.
La réponse des auteurs : la RSI ne s’arrête pas au pré-entraînement, elle change de forme. Faute de pouvoir boucler sur le run entier, ils ferment de petites boucles là où c’est possible. Les boucles de débogage déplacent l’expérimentation vers l’infrastructure et les données, qu’on peut rejouer à bas coût. La boucle de marge juge les points de sauvegarde sur leur potentiel après ajustement. Les boucles « de l’expérience à la métrique » donnent une mesure chiffrée à des tâches jusque-là réglées au jugé. Toutes partagent une infrastructure de contexte, la mémoire de l’organisation, qui garde aussi les échecs et leurs raisons pour qu’une nouvelle proposition parte de ce qui a déjà été écarté.
Ce que montre le papier
Des agents qui remontent aux causes
Pendant deux runs pilotes, arrêtés à 1 T et 3 T tokens, des agents qui surveillent les métriques internes repèrent un déséquilibre de charge entre experts du modèle (une architecture à mélange d’experts) : faible partout dans le premier pilote, très fort sur les couches 15 et 18 dans le second, alors que la moyenne semblait normale. En croisant ces courbes avec plus de 130 versions du code et 106 paramètres, ils remontent à un changement dans le calcul de la pénalité d’équilibrage et à son interaction avec l’optimiseur. Les corrections (pénalité de 10⁻² à 10⁻⁴, taux d’apprentissage de 2,7 × 10⁻³ à 5 × 10⁻⁴, routeur passé de Muon à AdamW, équilibrage calculé sur tout le lot) réduisent le déséquilibre de la couche 15 : à 3 T tokens, il dépassait 14 dans le pilote et tourne autour de 5 dans le run principal.
Côté données, les agents repèrent des sorties anormales et les relient à leur source. Au mot « deepseek », un pilote recrachait une chaîne ressemblant à une clé d’API, suivie d’un bloc de configuration répété sans fin : la cause était des fichiers de configuration mal nettoyés dans le corpus de code. D’autres défauts venaient d’un corpus de questions-réponses saturé d’un même modèle de question, et d’un générateur de données synthétiques trop peu varié. Les humains gardent deux décisions : l’ordre des enquêtes et l’approbation des corrections. Au total, cinq diagnostics croisant infrastructure, données et recette ont été bouclés en un mois environ, quand ce genre d’enquête peut prendre des mois selon les auteurs.
À budget égal de 1 T tokens, la moyenne sur 22 bancs d’essai passe de 47,78 (premier pilote) à 51,96 (second pilote) puis 56,83 (run principal). Les données et la recette ayant changé en même temps, ce gain ne s’attribue à aucune correction en particulier.
Le score de base ment parfois
Pour estimer la marge de progression, l’équipe ajuste chaque point de sauvegarde avec un petit jeu supervisé de 6,33 milliards de tokens (Tiny-SFT : mathématiques, sciences et code à 31,6 % chacun, suivi d’instructions à 5,2 %), puis l’évalue. Entre 4,1 T et 7 T tokens, le score du modèle de base stagne autour de 61, alors que le score après ajustement monte de 65,34 à 66,83. Entre 8,1 T et 11,5 T, même constat : de 70,54 à 72,93 après ajustement, pour un score de base qui plafonne. Les classements des points de sauvegarde changent aussi : la corrélation de rang entre les deux mesures n’est que de 0,438 sur la fin de l’entraînement. Se fier au seul score de base aurait pu faire arrêter l’entraînement trop tôt.
Des données agentiques produites par des agents
Les agents ne servent pas qu’à déboguer. Sur 260 000 demandes de fusion de code (pull requests) réelles, plus de 84 % ont été transformées en tâches exécutables avec leur environnement et leurs tests. Les 220 000 tâches obtenues ont été jouées dans neuf harnais (dont Claude Code, Codex, OpenHands et SWE-agent) avec des modèles ouverts comme DeepSeek-Flash et GPT-OSS. Après filtrage, dont la détection des tricheries (aller chercher le correctif en ligne, sauter les tests qui échouent), il reste 1,1 million de trajectoires, soit plus de 100 milliards de tokens. Avec d’autres sources, 134 milliards de tokens agentiques ont nourri la phase de contexte long. Un agent a aussi trouvé pourquoi 10 % de séquences longues divisaient la vitesse d’entraînement par deux ; le nouveau chargeur de données multiplie le débit par 2,26 sur 256 GPU.
Le modèle : deuxième en base, premier en moyenne agentique
801-30B-A3B reprend l’architecture de Qwen3-30B-A3B (30 milliards de paramètres, 3 milliards actifs) et a été entraîné de zéro sur 11,8 T tokens en trois mois par une équipe nouvellement formée. En version de base, il obtient 73,13 de moyenne sur 13 bancs d’essai, deuxième des sept modèles comparés derrière Qwen3.5-35B-A3B (76,67), juste devant Nemotron-3.5-Lightning-30B-A3B (73,07) et 6,97 points devant Qwen3-30B-A3B. Avec le même ajustement supervisé pour tous, il reste deuxième sur 13 bancs classiques (81,34 contre 83,76) et passe premier en moyenne sur cinq évaluations spécialisées (28,70 contre 20,54 pour Qwen3.5-35B-A3B).
Face à des modèles entièrement post-entraînés par leurs éditeurs, avec ses seuls 6,33 milliards de tokens d’ajustement et sans apprentissage par renforcement, il obtient la meilleure moyenne sur quatre bancs agentiques : 58,43, devant Flint-40B-A2.5B (50,23) et Qwen3.6-35B-A3B (44,59). Ce premier rang repose surtout sur KernelBench, où il atteint 77,60 quand le suivant plafonne à 44,00. Sur SWE-bench Verified, il fait 68,95, derrière Flint (72,80) et Qwen3.6 (71,65). Les auteurs présentent eux-mêmes cette comparaison comme un repère de marge, pas comme une comparaison à armes égales.
Les limites
Les auteurs le disent : les données et la recette ont changé ensemble, donc aucun gain n’est attribué à une correction précise ; l’ajustement Tiny-SFT n’a pas été répété avec plusieurs graines aléatoires ; chaque variante d’optimiseur n’a été entraînée qu’une fois ; l’évaluation a été limitée par le temps et les moyens, avec un accent sur les tâches agentiques. Ils précisent aussi que l’évaluation des classifieurs de données mesure l’accord avec un modèle fort, pas avec un jugement humain.
Nos réserves : le rapport ne compare pas avec une équipe qui aurait travaillé sans agents, si bien que l’apport propre des agents reste raconté plus que mesuré. La « récursion » tient surtout à la mémoire partagée des diagnostics et aux humains qui valident les corrections, plus qu’à un système qui s’améliore seul. Le budget GPU exact n’est pas donné. L’avance sur Nemotron-3.5-Lightning en version de base n’est que de 0,06 point. La moyenne agentique dépend d’un seul banc : sans KernelBench, notre calcul à partir du tableau 9 donne 52,05 pour 801-30B-A3B contre 53,24 pour Flint. Enfin, l’affirmation d’être « les premiers au monde » n’est pas vérifiable, et tant que les poids ne sont pas publiés, personne ne peut refaire ces mesures.
Lecture Neurone21
Peu d’entreprises pré-entraînent un modèle, mais beaucoup gèrent un projet coûteux qu’on ne peut pas rejouer : une migration, un déploiement, une campagne d’entraînement de modèle métier. Le rapport donne trois idées réutilisables. Garder une trace écrite des échecs et de leurs causes, pour que les agents et les équipes ne refassent pas la même enquête. Surveiller les signaux internes, qui bougent avant les indicateurs finaux. Et juger un modèle sur ce qu’il devient après adaptation à son usage, pas sur son score brut. Côté choix de modèle, 801-30B-A3B sera intéressant à tester en local quand ses poids seront publiés, surtout sur du code, mais sa moyenne agentique doit être lue banc par banc.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 12 novembre 2026 à 16:16 heure de Paris, puis l’a retenu dans sa sélection « Top AI Papers of the Week » du 9 au 15 novembre 2026, publiée le 15 novembre 2026 (17:57 UTC, 18:57 heure de Paris). Elvis Saravia (@omarsar0) a reposté cette sélection le 15 novembre 2026 à 19:05 heure de Paris. Nous avons lu la version officielle arXiv 2611.10719v1. Écarts avec le post :
Les chiffres de la sélection sont ceux du papier : 11,8 T tokens, trois mois, 6 milliards de tokens d’ajustement sans apprentissage par renforcement. La sélection affirme que « le modèle de base et les données d’ajustement sont publiés » : au 16 novembre 2026, seules les données le sont, les poids étant marqués « coming soon ». Elle attribue le travail à « SII et GAIR », alors que le rapport est signé SII et Xinxu AI. « Bat Nemotron-3.5-Lightning » est exact, mais de 0,06 point en moyenne, et Nemotron fait mieux sur MMLU-Pro. Enfin, la meilleure moyenne agentique est réelle mais tient surtout à KernelBench ; le modèle n’est premier ni sur SWE-bench Verified ni sans ce banc.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.10719
- Le PDF : https://arxiv.org/pdf/2611.10719
- Le dépôt GitHub : https://github.com/GAIR-NLP/801-30B
- Les données Tiny-SFT : https://huggingface.co/datasets/SII-GAIR-NLP/801-30B-A3B-tiny-sft-dataset
- La sélection DAIR.AI de la semaine : https://x.com/dair_ai/status/2122026336059543589
- Le post DAIR.AI sur le papier : https://x.com/dair_ai/status/2120898418801525191
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/no-second-run-does-rsi-stop-at-frontier-pre-training-2611.10719
- Notre fiche sur RSI-Dojo, des agents entraînés à post-entraîner d’autres modèles : /p/rsi-dojo-agents-post-entrainement-modeles
- Notre fiche sur un algorithme unique du pré-entraînement à l’apprentissage par renforcement : /p/entrainement-unifie-pretraining-rl-un-seul-algorithme
- Notre article sur Flint, le modèle de code ouvert de Recursive : /p/recursive-flint-modele-code-local-open-weights
- Notre fiche sur LongCapHarness, un harnais amélioré en boucle : /p/longcapharness-harnais-contexte-long-microsoft