Titre original : LongCapHarness: Capability-Guided Auto-Harnessing for Long-Context Reasoning
Auteurs : Tao Zhang et Yuhang He (auteur correspondant).
Affiliation : Microsoft Research Asia.
Publication : prépublication arXiv 2611.10463v1 (cs.CL), déposée le 7 novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
Pour qu’un modèle raisonne sur de très longs documents, la méthode habituelle consiste à fabriquer un grand corpus de textes longs, puis à réentraîner le modèle dessus. C’est coûteux et assez empirique. Les auteurs prennent l’autre chemin : ne pas toucher au modèle, mais construire autour de lui un harnais, c’est-à-dire le programme qui découpe la tâche, appelle le modèle sur de petits morceaux et garde les résultats intermédiaires hors de son contexte.
Leur point de départ : un long document demande de comprendre la structure de la tâche, de localiser les passages utiles, de retenir des résultats intermédiaires et de les assembler. Faire tout cela en un seul appel laisse ces étapes implicites. LongCapHarness les rend explicites en « capacités » (par exemple reclasser des passages), elles-mêmes découpées en primitives (juger la pertinence, puis trier), chacune réalisée par du code quand la règle est nette, ou par un appel au modèle quand il faut interpréter du texte.
Ce que montre le papier
Comment le harnais se construit
Un agent puissant, GPT-5.6-Sol, étudie les questions d’un jeu de développement de 2 242 exemples, propose les capacités et leurs primitives, écrit leur code, leurs consignes et la logique qui les enchaîne. Il compare la réponse obtenue à la réponse attendue et réécrit le tout en boucle (auto-amélioration récursive). Les harnais finis sont figés dans une bibliothèque, chacun avec une courte description. Au test, sur 59 826 exemples sans recouvrement, le petit modèle choisit le harnais adapté et l’exécute.
Les résultats
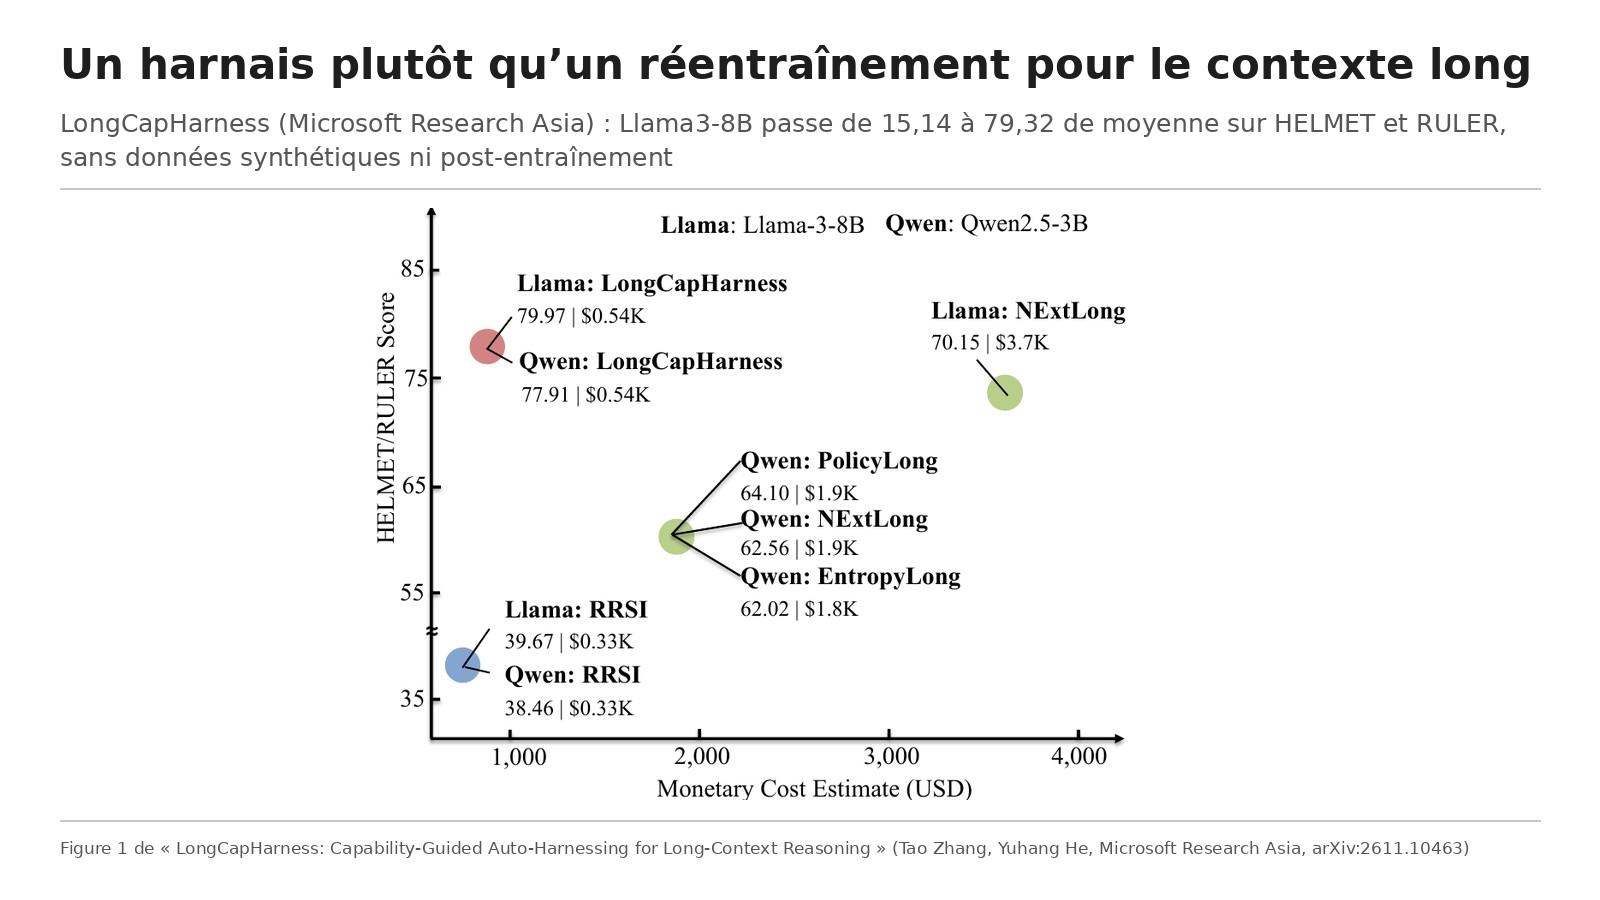
Sur la moyenne HELMET et RULER, Llama3-8B seul, limité à 8 000 jetons de contexte, obtient 15,14. Avec LongCapHarness, toujours à 8 000 jetons par appel, il atteint 79,32, soit 64,18 points de plus. C’est 9,17 points de plus que Llama3-8B réentraîné par NExtLong à 128 000 jetons (70,15), et 39,65 de plus que RRSI, une autre méthode d’auto-amélioration (39,67). Le harnais transféré sur Qwen2.5-3B donne 78,73, contre 64,10 pour PolicyLong et 61,91 pour le modèle seul.
Les gains sont massifs là où des règles explicites suffisent : 100 sur les tâches de rappel avec les deux modèles, 94,62 et 94,28 sur RULER. Ils sont faibles et irréguliers là où il faut du jugement : sur l’apprentissage par exemples, la recherche augmentée et les questions sur long texte, le harnais gagne ou perd quelques points selon le modèle, et reste par exemple à 0,46 point derrière NExtLong sur les questions longues avec Llama. Sur LongBench-v2 avec Qwen2.5-3B, il dépasse PolicyLong sur les textes moyens (34,47 contre 27,10) mais reste derrière sur les plus longs, de 128 000 à 2 millions de jetons (27,85 contre 31,50).
Les coûts
Le développement du harnais est estimé à 541,47 dollars de jetons GPT-5.6-Sol, contre 3 696 dollars d’entraînement sur H100 pour NExtLong et 1 858,82 dollars pour PolicyLong (estimations de location), mais plus que RRSI (331,56 dollars). À l’usage, le harnais génère beaucoup moins de texte que RRSI mais lit plus de jetons : le coût d’inférence est à peu près égal avec Llama (8,23 contre 8,30 dollars) et presque double avec Qwen (53,74 contre 29,39 dollars).
Les limites
Les auteurs reconnaissent que tout repose sur un agent très puissant pour écrire les harnais : la performance chute fortement quand Llama3-8B ou Qwen2.5-3B construisent leur propre harnais, sans que le papier chiffre cette chute. Les harnais organisent les opérations mais ne remplacent pas le jugement sémantique du modèle, d’où les résultats moyens sur les tâches d’interprétation.
Nos réserves : les coûts d’entraînement des concurrents sont des estimations de location, et celui de PolicyLong est extrapolé. La figure 1 affiche 79,97 et 77,91 alors que le tableau 1 donne 79,32 et 78,73 pour les mêmes configurations. Les harnais sont développés sur les mêmes types de tâches que le test, ce qui en fait des outils spécialisés plutôt qu’une capacité générale. Enfin, la comparaison oppose un modèle outillé par un modèle de pointe à des modèles réentraînés sans outil.
Lecture Neurone21
Pour une entreprise qui veut faire travailler un petit modèle, local ou bon marché, sur de longs documents (contrats, dossiers techniques, journaux), le message est pratique : avant de payer un réentraînement, il vaut la peine d’investir dans le programme qui entoure le modèle. Une partie du travail, chercher un mot-clé, compter, suivre une variable, se fait mieux en code qu’en demandant au modèle de tout garder en tête.
La condition, c’est l’accès ponctuel à un modèle de pointe pour écrire ce harnais, puis la possibilité de le faire tourner avec un petit modèle. C’est un schéma intéressant pour la souveraineté : le gros modèle sert une fois en atelier, le petit tourne ensuite chez soi. Mais il faut regarder le coût à l’usage, qui peut doubler selon le modèle, et ne pas attendre de miracle sur les tâches qui demandent vraiment de comprendre le texte.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 10 novembre 2026 à 15:23 heure de Paris, puis a reposté son propre post le 11 novembre à 03:30 heure de Paris. Nous avons lu la version officielle arXiv 2611.10463v1. Écarts avec le post :
Les chiffres du post sont ceux du papier : 64,18 points de gain moyen pour Llama3-8B et un coût de développement inférieur à la moitié des coûts d’entraînement estimés de NExtLong et PolicyLong. Le post ne précise pas que ces coûts sont des estimations, que le harnais coûte presque deux fois plus cher que RRSI à l’usage avec Qwen2.5-3B, ni qu’il reste derrière PolicyLong sur les textes les plus longs de LongBench-v2. Il parle d’un travail de Microsoft : il s’agit de Microsoft Research Asia, avec deux auteurs.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.10463
- Le PDF : https://arxiv.org/pdf/2611.10463
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2120160305347260443
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/longcapharness-capability-guided-auto-harnessing-for-long-context-reasoning-2611.10463