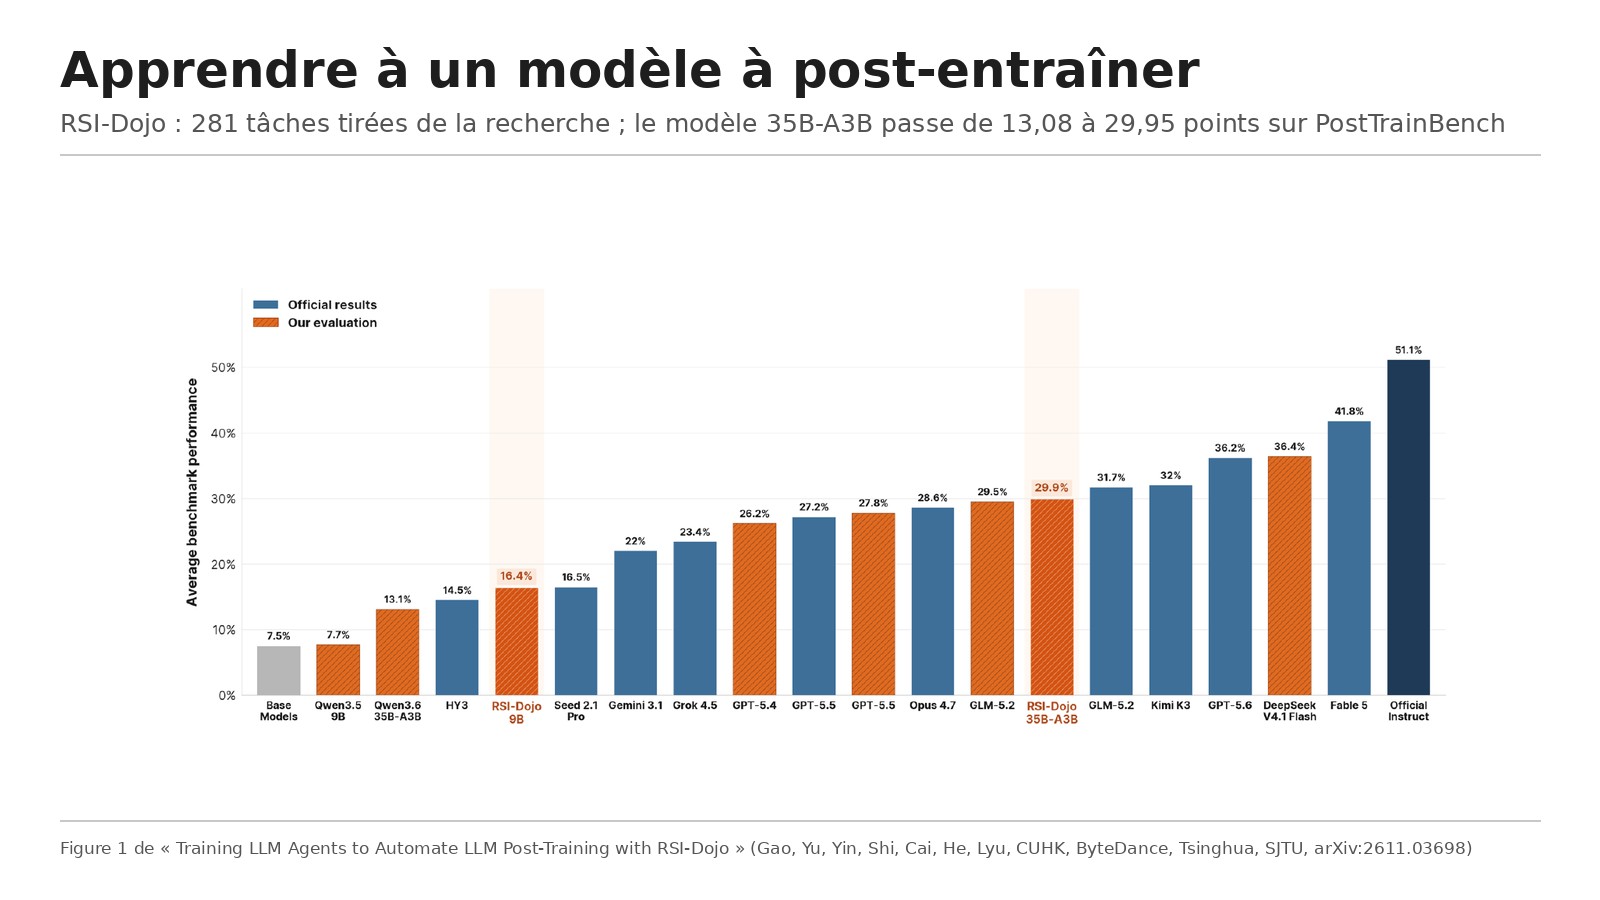
Titre original : Training LLM Agents to Automate LLM Post-Training with RSI-Dojo
Auteurs : Shuzheng Gao, Zhaojian Yu, Penghao Yin, Yuling Shi, Kai Cai, Shilin He et Michael R. Lyu.
Affiliations : The Chinese University of Hong Kong (CUHK), ByteDance, Tsinghua University et Shanghai Jiao Tong University.
Publication : prépublication arXiv 2611.03698v1 (cs.AI), déposée le 29 octobre 2026.
Liens : page arXiv, PDF.
L’idée en bref
On sait déjà demander à un agent de post-entraîner un modèle : choisir des données, lancer un entraînement, lire les erreurs, recommencer. Jusqu’ici, les progrès venaient surtout du harnais autour de l’agent (consignes, étapes imposées, mémoire). Les auteurs veulent mettre ce savoir-faire dans les poids d’un modèle ouvert de taille moyenne.
Il faut pour cela beaucoup de tâches d’entraînement exécutables, ce qui n’existe pas comme pour le code (tickets GitHub) ou l’apprentissage automatique classique (concours Kaggle). D’où RSI-Craft, une chaîne automatique qui transforme des papiers de recherche en environnements, et RSI-Dojo, la collection qui en sort. RSI désigne l’auto-amélioration récursive, des systèmes d’IA qui améliorent des systèmes d’IA.
Ce que montre le papier
Des papiers aux environnements
RSI-Craft parcourt trois ans de NeurIPS, ICML, ICLR, ACL, EMNLP, NAACL et COLM, plus la plateforme InspectAI, et retient 547 candidats qui apportent un vrai jeu de données. Un agent retrouve les données, la métrique et le code d’évaluation, les installe et vérifie qu’ils tournent : 315 environnements fonctionnent. Les filtres écartent ensuite les évaluations instables et les tâches qui ne séparent pas un petit modèle (Qwen3-4B-Base) d’un grand (GPT-5-mini) d’au moins 10 points. Il reste 281 tâches sur dix domaines, dont 31,7 % de questions générales et 14,6 % de sécurité.
Des trajectoires guidées puis filtrées
Des modèles de pointe résolvent ces tâches avec un harnais renforcé, qui cible des erreurs fréquentes : réglage du jeton de fin de génération oublié, changements de recette sans analyse des échecs, modèle final non rendu. Sur 100 trajectoires de chaque, ce guidage fait passer le taux de trajectoires conservées de 42 % à 56 %, et les cas de trop peu de données d’entraînement de 22 à 3. Un filtre de comportement puis un filtre de résultat (le modèle final doit progresser) laissent 324 sessions, découpées en 1 240 exemples d’entraînement.
Les gains sur PostTrainBench
Sur PostTrainBench (un GPU, dix heures pour améliorer un modèle de base sur un banc cible), RSI-Dojo-9B passe de 7,72 à 16,46 points et RSI-Dojo-35B-A3B de 13,08 à 29,95. Le 35B-A3B dépasse de peu GLM-5.2 (29,52), GPT-5.5 (27,80) et GPT-5.4 (26,21) évalués par les auteurs, mais reste sous DeepSeek-V4.1-Flash (36,36). Sur la version Lite, il passe de 5,80 à 53,29, au niveau de GPT-5.5 (52,96), sous GLM-5.2 (56,37) et DeepSeek-V4.1-Flash (62,92). Il mène au moins un entraînement à terme dans 28 réglages sur 28, contre 15 pour le modèle de base. Les deux filtres ensemble comptent : avec un seul, le score Lite tombe à 30,66 ou 26,13.
Les limites
- conditions d’évaluation adaptées : faute de matériel, les expériences tournent sur un GPU moins puissant que celui exigé par le banc officiel, et les jeux de données sont téléchargés à l’avance ;
- pas d’outil de recherche web pour les modèles auto-hébergés, désactivé aussi pendant la collecte ;
- tâches proches du banc : les environnements couvrent surtout des tâches du type PostTrainBench, pas une recherche longue et ouverte ;
- boucle non fermée : le modèle entraîné améliore de plus petits modèles, pas un successeur de lui-même ;
- trous connus : faible sur AIME 2025 (les trajectoires de maths difficiles sont filtrées faute de progrès) et sur Arena-Hard, où les gros gains viennent souvent de la distillation par un modèle enseignant, absente des données.
Lecture Neurone21
Le message utile n’est pas qu’un modèle de 35B « égale » les modèles de pointe : il les rejoint sur un banc précis, dans des conditions adaptées, et reste derrière DeepSeek-V4.1-Flash. Le message utile est ailleurs : les erreurs qui ruinent un post-entraînement sont souvent bêtes et répétitives (jeton de fin mal réglé, trop peu de données, modèle non rendu), et un harnais qui les cible améliore nettement la qualité du travail.
Pour une entreprise qui affine ses propres modèles, la leçon se transpose sans rien entraîner : une liste de contrôle sur ces points avant chaque lancement, et une évaluation qui revient sur le jeu complet une fois le sous-ensemble saturé. Le papier montre aussi qu’un modèle ouvert de taille moyenne peut apprendre ce métier, ce qui intéresse ceux qui veulent garder leur chaîne d’entraînement en interne.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a retenu dans sa sélection « Top AI Papers of the Week » du 2 au 8 novembre 2026, publiée le 8 novembre 2026 (16:28 UTC, 17:28 heure de Paris). Elvis Saravia (@omarsar0) a reposté cette sélection le 8 novembre 2026 à 17:30 heure de Paris, puis le post qui l’annonce le 9 novembre 2026 à 02:00 heure de Paris. Nous avons lu la version officielle arXiv 2611.03698v1. Écarts avec le post :
Les chiffres de la sélection sont ceux du papier : 281 tâches, gains de 8,74 et 16,87 points, 29,95 sur PostTrainBench et 53,29 sur la version Lite. La formule « au niveau de GLM-5.2 et GPT 5.5 » reprend l’abstract, mais sur la version Lite GLM-5.2 fait mieux (56,37), et DeepSeek-V4.1-Flash, évalué dans les mêmes conditions, dépasse RSI-Dojo-35B-A3B sur les deux bancs (36,36 et 62,92). La sélection ne mentionne pas non plus le GPU moins puissant que celui du protocole officiel.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.03698
- Le PDF : https://arxiv.org/pdf/2611.03698
- La sélection DAIR.AI de la semaine : https://x.com/dair_ai/status/2119467209550365099
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/training-llm-agents-to-automate-llm-post-training-with-rsi-dojo-2611.03698