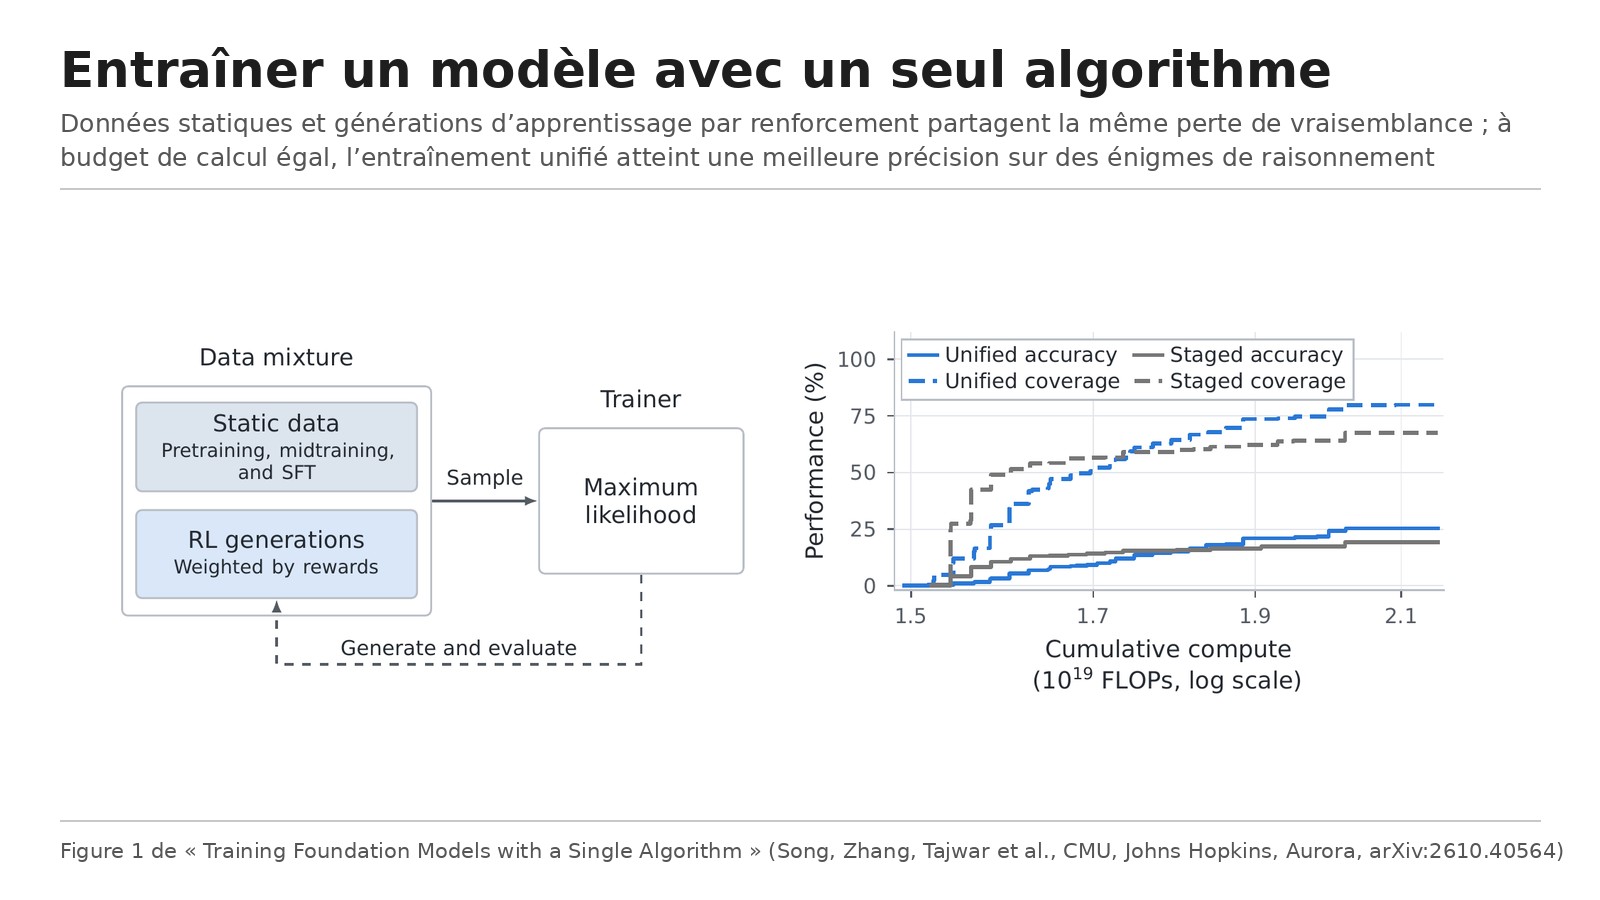
Titre original : Training Foundation Models with a Single Algorithm
Auteurs : Yuda Song, Alvin Zhang, Fahim Tajwar, Daman Arora, Jeff Schneider, Daniel Khashabi, Ruslan Salakhutdinov, J. Andrew Bagnell, Aarti Singh et Andrea Zanette, de Carnegie Mellon University, Johns Hopkins University et Aurora Innovation (États-Unis).
Publication : prépublication arXiv 2610.40564v1 (cs.LG), déposée le 29 octobre 2026, 67 pages avec annexes.
Liens : page arXiv, PDF.
L’idée en bref
Un grand modèle de langage est aujourd’hui entraîné en étapes successives : le pré-entraînement sur du texte général, le mid-training sur un corpus plus choisi, l’ajustement supervisé (SFT) sur des démonstrations, puis l’apprentissage par renforcement (RL) sur des réponses générées par le modèle et notées. Chaque étape a sa recette et souvent son outillage.
Les auteurs montrent que cette séparation n’est pas une nécessité. Les trois premières étapes utilisent déjà la même règle, la maximisation de la vraisemblance des données. En s’appuyant sur une méthode appelée MaxRL, ils montrent qu’une forme adaptée de RL revient aussi à ajuster le modèle, par vraisemblance, sur ses propres réponses réussies. Toutes les étapes peuvent donc tourner avec une seule perte et un seul entraîneur, ce qu’ils appellent l’entraînement unifié (section 3).
La question change alors de nature : il ne s’agit plus d’enchaîner des étapes, mais de choisir quelles données montrer au modèle, en quelles proportions et à quel moment. L’entraînement par étapes devient un cas particulier, celui où l’on passe brutalement d’une source à l’autre.
Ce que montre le papier
Un banc d’essai contrôlé sur des énigmes de raisonnement
Les auteurs entraînent depuis zéro un modèle de 124 millions de paramètres, avec un corpus de pré-entraînement fixe de 20 milliards de tokens et un corpus de mid-training de 510 millions de tokens, fait de solutions rédigées d’énigmes logiques. Le RL porte ensuite sur de nouvelles combinaisons de ces énigmes, dont certaines plus grandes que celles vues à l’entraînement (section 5.1).
Les meilleures configurations unifiées battent l’entraînement par étapes sur les tâches de RL, et aussi sur des énigmes plus grandes que toutes celles vues en mid-training ou en RL (figure 4). Les deux meilleures configurations parcourent le corpus de mid-training 2 et 4 fois pendant le pré-entraînement. À l’inverse, l’entraînement par étapes perd en précision dès que le mid-training dépasse son budget optimal.
Un avantage qui dépend du budget de calcul
À calcul total égal (pré-entraînement, mid-training et RL compris), l’entraînement unifié obtient la meilleure précision aux plus petits et aux plus grands budgets, tandis que l’entraînement par étapes l’emporte aux budgets intermédiaires. En couverture (au moins une bonne réponse sur 16 essais), l’entraînement par étapes est souvent plus efficace, sauf sur le test de généralisation, où l’unifié domine presque partout (section 5.1.2, figure 5).
Moins d’oubli des connaissances générales
Mélanger le corpus de mid-training au pré-entraînement préserve les connaissances générales au niveau du modèle seulement pré-entraîné, même quand la part de mid-training augmente. La meilleure configuration par étapes, elle, a une perte plus élevée sur des textes de pré-entraînement mis de côté et un score moyen plus bas sur cinq tests généraux (section 5.1.3, figure 6).
Le test « réel » : un modèle de 0,76 milliard de paramètres en mathématiques
Les auteurs entraînent ensuite un modèle de 0,76 milliard de paramètres, puis font du RL en mathématiques (jeu Math12K) en y mêlant de 0 % à 5 % d’un corpus de 240 millions de tokens (web, maths, code, traces de raisonnement). La précision en maths reste quasi stable. La rétention s’améliore : la perte sur le corpus mis de côté baisse de 0,1474 nat par token avec 5 % de mélange, alors qu’elle monte de 0,0472 en entraînement par étapes, et le score au test scientifique SciQ passe à 65,10 % contre 53,00 % (tableau 16). Mais la programmation recule : à 5 % de mélange, HumanEval+ tombe à 10,90 % en précision au premier essai, contre 15,51 % pour l’entraînement par étapes (section 5.2.1, tableau 16).
Le calendrier compte aussi : arrêter le mélange à mi-parcours améliore la programmation et garde le gain sur SciQ, mais conserve moins la baisse de perte (section 5.2.2).
Un meilleur point de départ pour apprendre une nouvelle tâche
Après l’entraînement en maths, tous les modèles passent par le même RL de programmation, sans mélange. Les modèles unifiés partent plus bas en code, mais finissent tous au-dessus de l’entraînement par étapes en précision au premier essai sur HumanEval+ et MBPP+. Le mélange à 5 % est le meilleur sur les quatre mesures : 24,96 % sur HumanEval+ et 32,69 % sur MBPP+, contre 22,94 % et 29,81 % pour l’entraînement par étapes (section 5.2.3, tableau 22).
Les limites
Les auteurs reconnaissent que (section 7) :
- les expériences restent à petite échelle, et la plupart n’optimisent qu’une tâche de RL à la fois ;
- ils n’ont pas trouvé de mélange ni de calendrier qui gagne partout : précision, couverture et rétention se font concurrence ;
- l’étude de calcul ne fournit pas de lois d’échelle prédictives ;
- l’adaptation d’un modèle à une nouvelle tâche exigera toujours une étape à part.
Réserves de notre lecture, tirées du papier :
- Les écarts en apprentissage continu sont parfois minces : sur MBPP+, le modèle unifié à 1 % fait 29,94 % contre 29,81 % pour l’entraînement par étapes (tableau 22).
- En couverture sur HumanEval+ (au moins une bonne réponse sur 16 essais), les petits mélanges font aussi bien ou moins bien que l’entraînement par étapes ; seul le mélange à 5 % l’emporte nettement (section 5.2.3).
- La baisse en programmation pendant le RL de maths est nette et grandit avec la part de mélange, ce qui montre que mélanger n’est pas gratuit.
- Les modèles testés (124 millions et 0,76 milliard de paramètres) sont loin des modèles de production. Rien ne dit encore que les résultats tiennent à l’échelle de dizaines de milliards de paramètres.
Lecture Neurone21
Pour une entreprise qui utilise des modèles sans les entraîner, l’intérêt est indirect mais réel. Ce travail suggère que les laboratoires pourraient fabriquer des modèles qui oublient moins ce qu’ils savaient quand on les spécialise, et qui se prêtent mieux à un ajustement ultérieur. C’est précisément ce que cherche une organisation qui veut adapter un modèle ouvert à ses propres données sans le dégrader ailleurs.
Le principe est aussi transposable à plus petite échelle : quand on spécialise un modèle, garder une petite part de données générales dans le mélange peut éviter qu’il perde ses autres compétences. Le papier montre que la dose et le moment comptent, et qu’il faut mesurer ce que l’on gagne et ce que l’on perd sur chaque tâche. Sur la façon dont les données de RL se dosent, voir aussi notre fiche sur les lois d’échelle du RL agentique.
Le post d’Elvis Saravia reprend fidèlement les résultats du papier. Il ne donne pas les chiffres, qui sont dans les tableaux en annexe, et ne précise pas que l’avantage en apprentissage continu est parfois très faible selon le mélange.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.40564
- Le PDF : https://arxiv.org/pdf/2610.40564v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2116629539623473617
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/training-foundation-models-with-a-single-algorithm-2610.40564