Titre original : How Data Scales in Agentic Reinforcement Learning: Laws and Synthesis Strategies
Auteurs : Bowei He, Yankai Chen, Xiaokun Zhang, Changjiang Han, Ye Yuan, Chong Li, Xue Liu
Affiliations : MBZUAI (Abou Dhabi), Université McGill, City University of Hong Kong (CityUHK), Université Columbia. Travail financé par le fonds de base de MBZUAI, selon les auteurs.
Publication : déposé sur arXiv le 8 octobre 2026 (version 1), accepté à la conférence NeurIPS 2026 d’après la notice arXiv.
Liens : page arXiv, PDF, code sur GitHub.
L’idée en bref
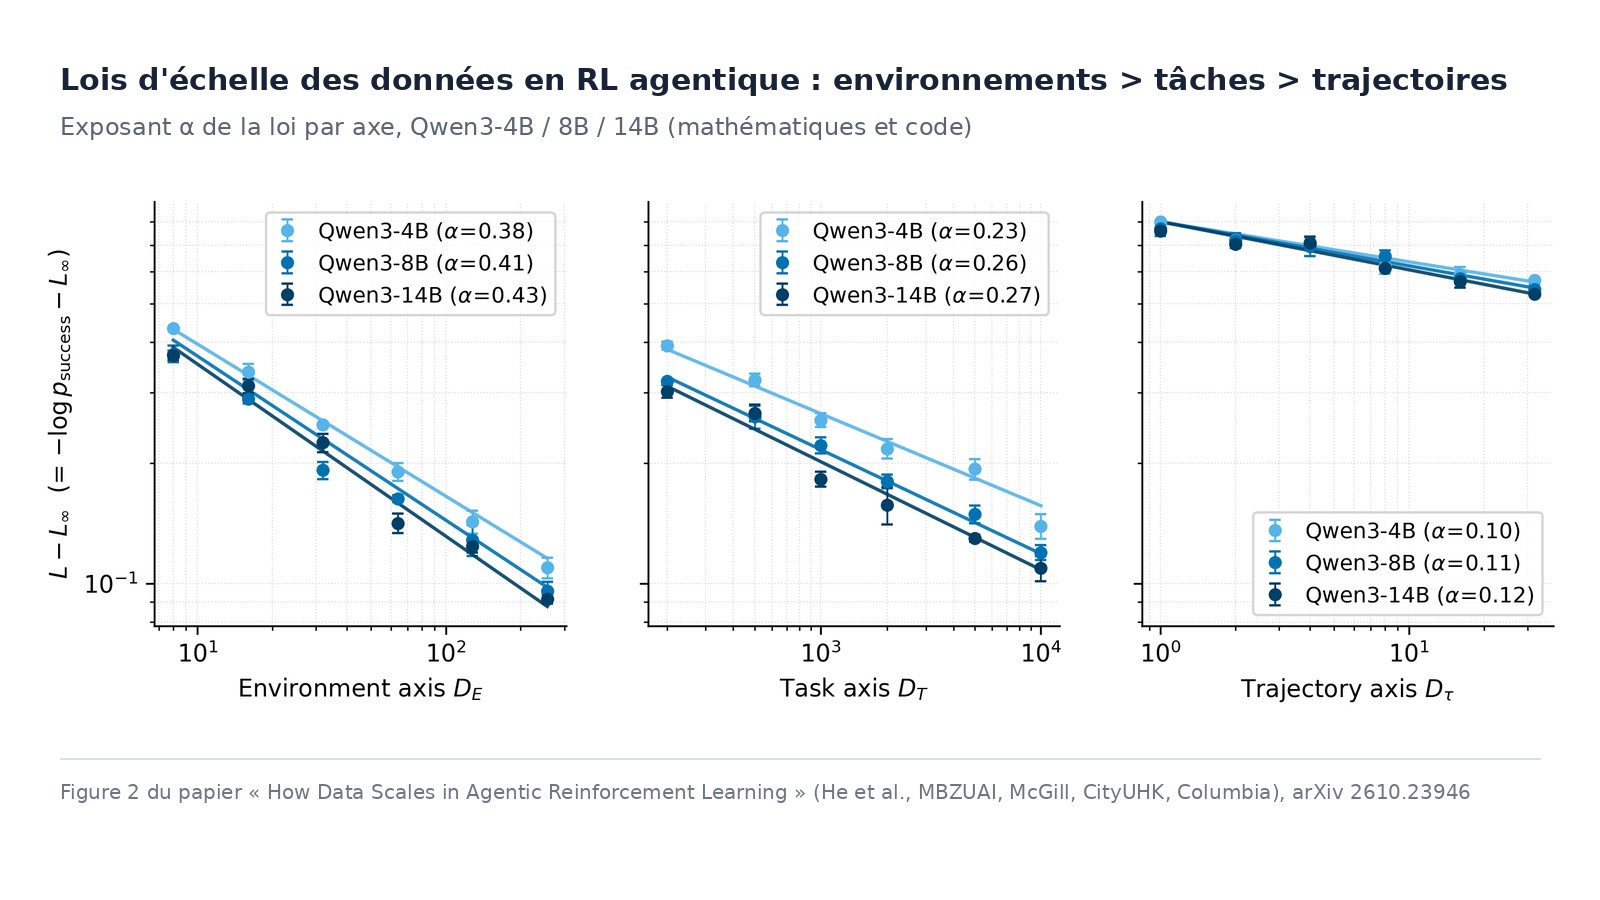
Pour entraîner un agent par apprentissage par renforcement (reinforcement learning, RL : le modèle agit, reçoit une récompense et s’ajuste), les données se fabriquent désormais à volonté ; la question devient où dépenser le budget de fabrication. Les auteurs séparent les données en trois axes, tâches (les consignes), environnements (les mondes outillés où l’agent agit) et trajectoires (les essais répétés), et mesurent une loi d’échelle pour chacun. Résultat constant : ajouter des environnements rapporte le plus, ajouter des tâches vient ensuite, et répéter des trajectoires, pourtant la pratique dominante, rapporte le moins.
Ce que montre le papier
Une loi par axe. En faisant varier un axe à la fois, les auteurs ajustent une loi de puissance sur un indicateur dérivé du taux de réussite. Sur Qwen3-8B (mathématiques et code), les exposants valent 0,41 pour les environnements, 0,26 pour les tâches et 0,11 pour les trajectoires (section 4.1) : plus l’exposant est élevé, plus l’axe fait progresser l’agent.
Un ordre qui tient partout où il a été mesuré. L’ordre environnements > tâches > trajectoires se retrouve dans 21 configurations : cinq modèles (Qwen3-4B, 8B, 14B, Llama-3.1-8B, Qwen2.5-7B), cinq domaines (mathématiques et code, correction de logiciel, web, applications et outils, recherche d’information) et deux algorithmes aux exposants proches (section 4.3) : PPO (Proximal Policy Optimization, qui s’appuie sur un second réseau, le « critique », chargé d’estimer la valeur de chaque situation) et GRPO (Group Relative Policy Optimization, qui compare plusieurs réponses à la même consigne, sans ce second réseau).
Ce sont les mondes qui comptent. Des mondes réellement différents (autre dépôt de code, autre application, autre site) donnent un exposant de 0,44 ; des variantes de structure d’un même monde (autres outils, autre format de sortie), 0,28, à peu près le niveau des tâches (section 4.4).
Une décote pour les données synthétiques. Chaque méthode de synthèse reçoit un facteur de décote (ce que vaut une donnée synthétique face à une donnée réelle) : 0,71 pour les environnements générés par AWM, 0,54 pour les tâches d’AutoPlay, 0,34 pour les trajectoires de SWiRL (tableau 3). Le ratio synthétique sur réel au-delà duquel la réussite passe 5 % sous la référence réelle vaut environ 9,4 pour les environnements, 3,4 pour les tâches et 1,4 pour les trajectoires (section 5.2, figure 4). Raison avancée : un environnement en code est vérifié à chaque pas par l’exécution, une trajectoire produite par le modèle reproduit ses biais.
Une recette de répartition. Lois, décotes et coûts donnent une répartition optimale du budget, dans l’esprit de la loi « Chinchilla » du préentraînement (le bon rapport entre taille du modèle et volume de données). Sur un point tenu à l’écart de l’ajustement (Qwen3-14B, plus gros budget), la réussite mesurée est de 51,3 % pour 51,7 % prédite, contre 47,3 % avec une répartition à la Chinchilla et 42,9 % en misant presque tout sur les trajectoires (section 6.3). Soit un gain d’efficacité de calcul de 1,4 fois face à Chinchilla et de 1,7 fois face à la pratique « tout sur les trajectoires ».
Les limites
Les auteurs en listent sept (annexe R), dont :
- Modèles de taille moyenne. Modèles ouverts de 4 à 14 milliards de paramètres, validation sur un seul point. Les auteurs revendiquent l’ordre des axes, pas la valeur des exposants.
- Axes imparfaitement indépendants. Tâches et environnements varient souvent ensemble ; la diversité des mondes ne porte que sur 1 à 11 mondes réels selon les expériences.
- Un seul indicateur, le taux de réussite, muet sur la robustesse, la latence ou la sûreté.
- Modèle de coût simplifié. Sur la correction de logiciel, environnements et tâches deviennent indiscernables dans la recette.
- Domaines balisés, à récompense claire, loin des tâches réelles ambiguës et longues.
Nos réserves : l’étude a demandé environ 61 000 heures de GPU H100 (annexe Q), ce qui rendra une vérification indépendante coûteuse. Et le dépôt GitHub ne contient, selon son propre README, que la mécanique d’ajustement des lois et un simulateur, sans la partie entraînement que l’annexe P annonce, ni licence déclarée.
Lecture Neurone21
Ce papier s’adresse aux équipes qui post-entraînent des modèles pour en faire des agents : laboratoires, éditeurs d’agents de code, intégrateurs qui adaptent un modèle ouvert à un métier. Il apporte une grille d’arbitrage chiffrée là où l’on décide surtout par habitude.
Pour une entreprise qui fabrique des agents, trois leçons :
- Diversifier les terrains avant de multiplier les essais. Mieux vaut des bacs à sable variés (applications, bases, outils métier) que davantage de relances sur les mêmes, qui saturent vite.
- Doser le synthétique axe par axe. Des environnements générés en code en supportent beaucoup ; des trajectoires produites par le modèle, guère plus que le volume de données réelles.
- Refaire le calcul avec ses propres coûts. Avec les leurs, les auteurs situent le point de bascule vers environ 40 dollars par monde réel ; au-delà, acquérir un nouveau monde cesse d’être l’achat le plus rentable.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.23946
- Le PDF : https://arxiv.org/pdf/2610.23946
- Le code des auteurs : https://github.com/BokwaiHo/AgentRL_Scaling
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2112527762212933819
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/how-data-scales-in-agentic-reinforcement-learning-laws-and-synthesis-strategies-2610.23946