Titre original : Agent Plasticity: Measuring Self-Improvement Through Experience
Auteurs : Harman Singh, Anton Bakhtin, Rulin Shao, Gabriel Synnaeve, Ilia Kulikov, Rob Fergus, Sanjeev Arora, Kurt Keutzer, Jason Weston, Anuj Mahajan, Anirudh Goyal
Affiliations : UC Berkeley, Meta Superintelligence Labs, Université de Washington, Université de Princeton.
Publication : déposé sur arXiv le 6 octobre 2026 (version 1), 43 pages.
Liens : page arXiv, PDF. Aucun dépôt de code n’est indiqué dans le papier.
L’idée en bref
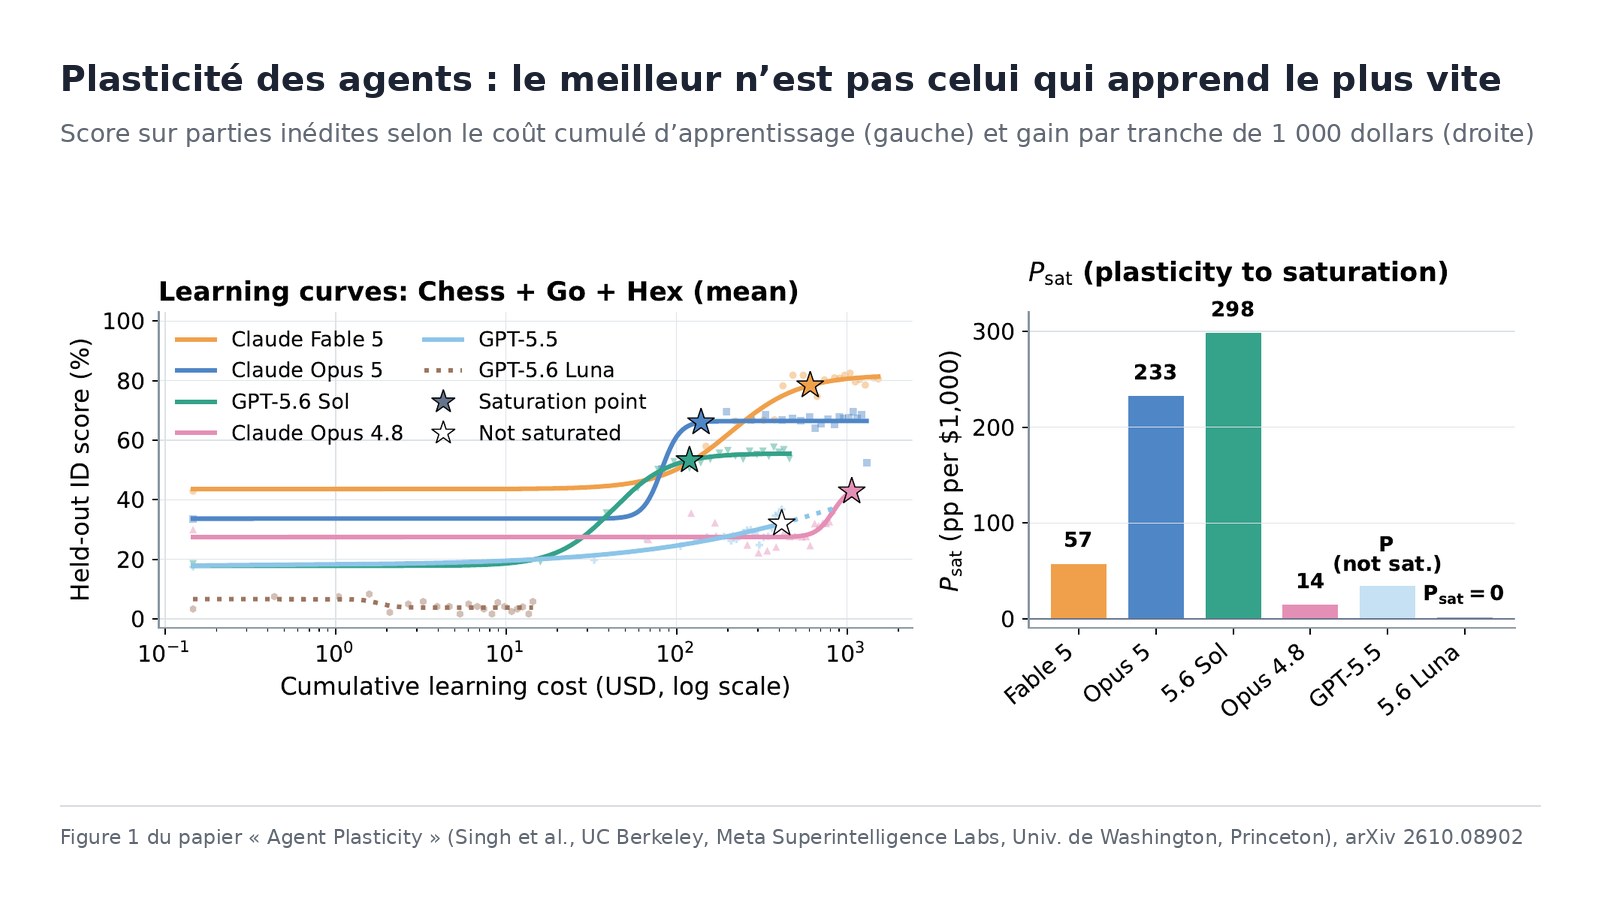
Les évaluations d’agents mesurent ce qu’un agent sait faire à un instant donné. Or un agent peut aussi progresser : analyser ses échecs, écrire des outils, rédiger des notes, des « skills » (fiches de savoir-faire réutilisables) ou des stratégies. Les auteurs veulent mesurer cette progression elle-même. Leur protocole fige les poids du modèle et fait démarrer chaque partie dans un contexte vierge : le seul moyen de progresser est de laisser des « artefacts » (outils, notes, consignes) dont hériteront les instances suivantes. Ils définissent la plasticité d’un agent comme le gain de score sur des parties jamais vues pendant l’apprentissage, rapporté au coût de cet apprentissage, exprimé en points par tranche de 1 000 dollars.
Ce que montre le papier
Des trajectoires très différentes. Les modèles testés jouent aux échecs, au go (5×5), au hex (6×6) et à NetHack, un jeu d’exploration de donjons long et partiellement observé. Aux échecs en version difficile, Claude Fable 5 passe de 37,5 % à 73,3 % sur des parties inédites, Claude Opus 5 de 25,0 % à 66,4 %. GPT-5.6 Sol part de presque zéro et gagne à peu près autant (jusqu’à 36,9 %). D’autres modèles stagnent ou reculent malgré les mêmes occasions d’apprendre.
Capacité finale et efficacité divergent. Sur la courbe combinée échecs, go et hex, GPT-5.6 Sol affiche la meilleure plasticité estimée (298 points par 1 000 dollars), devant Claude Opus 5 (233), Claude Fable 5 (57) et Claude Opus 4.8 (14). Pourtant, Claude Fable 5 atteint le niveau final le plus élevé. C’est le constat que résume Elvis Saravia : le meilleur à l’arrivée n’est pas celui qui apprend le plus efficacement.
NetHack, un cas à part. Seul Claude Opus 5.5 progresse nettement : son score moyen passe d’environ 2 000 à environ 6 000. L’ajustement donne un gain de 66,25 points normalisés pour 1 072,73 dollars d’apprentissage, ce qui correspond aux chiffres du post (« 66 points pour environ 1 073 dollars »). GPT-5.6 Sol, champion de la plasticité sur les jeux de plateau, recule ici : le classement dépend de la tâche.
Où ça casse. Les agents peu plastiques ignorent souvent les artefacts pertinents qu’ils ont eux-mêmes écrits. Les agents plus plastiques les réutilisent, mais échouent quand ces artefacts sont de mauvaise qualité ou mal appliqués. Les progrès obtenus contre les adversaires d’entraînement se transfèrent aussi moins bien face à des adversaires plus forts.
Les limites
- Une mesure liée au protocole. Les auteurs le disent : la plasticité est une propriété d’un agent dans un protocole donné, pas une note universelle du modèle. Elle dépend des tarifs des fournisseurs, de la marge de progression, de la durée d’apprentissage et des hypothèses de l’ajustement.
- Des analyses d’échec observationnelles, et non causales : aucune expérience ne retire ou ne remplace les artefacts pour le prouver.
- Expérience et calcul confondus : le protocole ne sépare pas l’apport du retour de l’environnement du calcul supplémentaire consacré à la réflexion.
- Des environnements de jeu, à l’évaluation finie et donc bruitée ; aucun transfert d’une tâche à l’autre n’est établi.
- Des modèles non vérifiables : plusieurs noms de modèles cités (Claude Fable 5, GPT-5.6 Sol et Luna) n’ont pas été recoupés au-delà du papier.
Lecture Neurone21
Pour une entreprise qui déploie un agent appelé à « apprendre sur le tas », ce papier déplace la question. Le meilleur score le jour de l’achat ne dit rien de la vitesse de progression ni de son coût. Mesurer la plasticité revient à suivre une courbe d’apprentissage dans la durée, sur des cas jamais vus, en comptant la facture.
Le constat sur les artefacts est très concret : un agent qui rédige des notes et des outils sans les relire, ou en produit de mauvais, n’apprend pas. Contrôler la qualité de cette mémoire écrite devient un sujet d’ingénierie à part entière. Les auteurs suggèrent enfin que la plasticité pourrait devenir un objectif d’entraînement des futurs modèles.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.08902
- Le PDF : https://arxiv.org/pdf/2610.08902
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2108580251127439710
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/agent-plasticity-measuring-self-improvement-through-experience-2610.08902