Titre original : Pro² Agent: Scientific Problem Probing for Autonomous AI R&D
Auteurs : Yixiong Chen, Liqian Peng, Tian Tan, Ziqian Lin, Blake Jianhang Chen, Chao Zhao, Yaojie Liu, Alec Go et Alan Yuille.
Affiliations : Google ; université Johns Hopkins (Alan Yuille, et Yixiong Chen, auteur principal, dont le travail a été fait pendant un stage chez Google).
Publication : prépublication déposée sur arXiv le 19 novembre 2026 (2611.25357v1, 20 pages). Le papier n’annonce ni dépôt de code ni publication des notes de recherche produites par l’agent.
Liens : page arXiv, PDF, version HTML.
L’idée en bref
Les agents qui mènent seuls des projets d’apprentissage automatique (préparer les données, entraîner, évaluer, soumettre) procèdent le plus souvent par optimisation du code : ils proposent une modification, la testent, gardent la meilleure version, recommencent. Leur état de travail, c’est la base de code, son score et l’historique des changements. Sur les problèmes difficiles, cette approche reste souvent coincée dans une mauvaise région de solutions, parce que l’agent ne représente jamais explicitement ce qu’il a compris du problème.
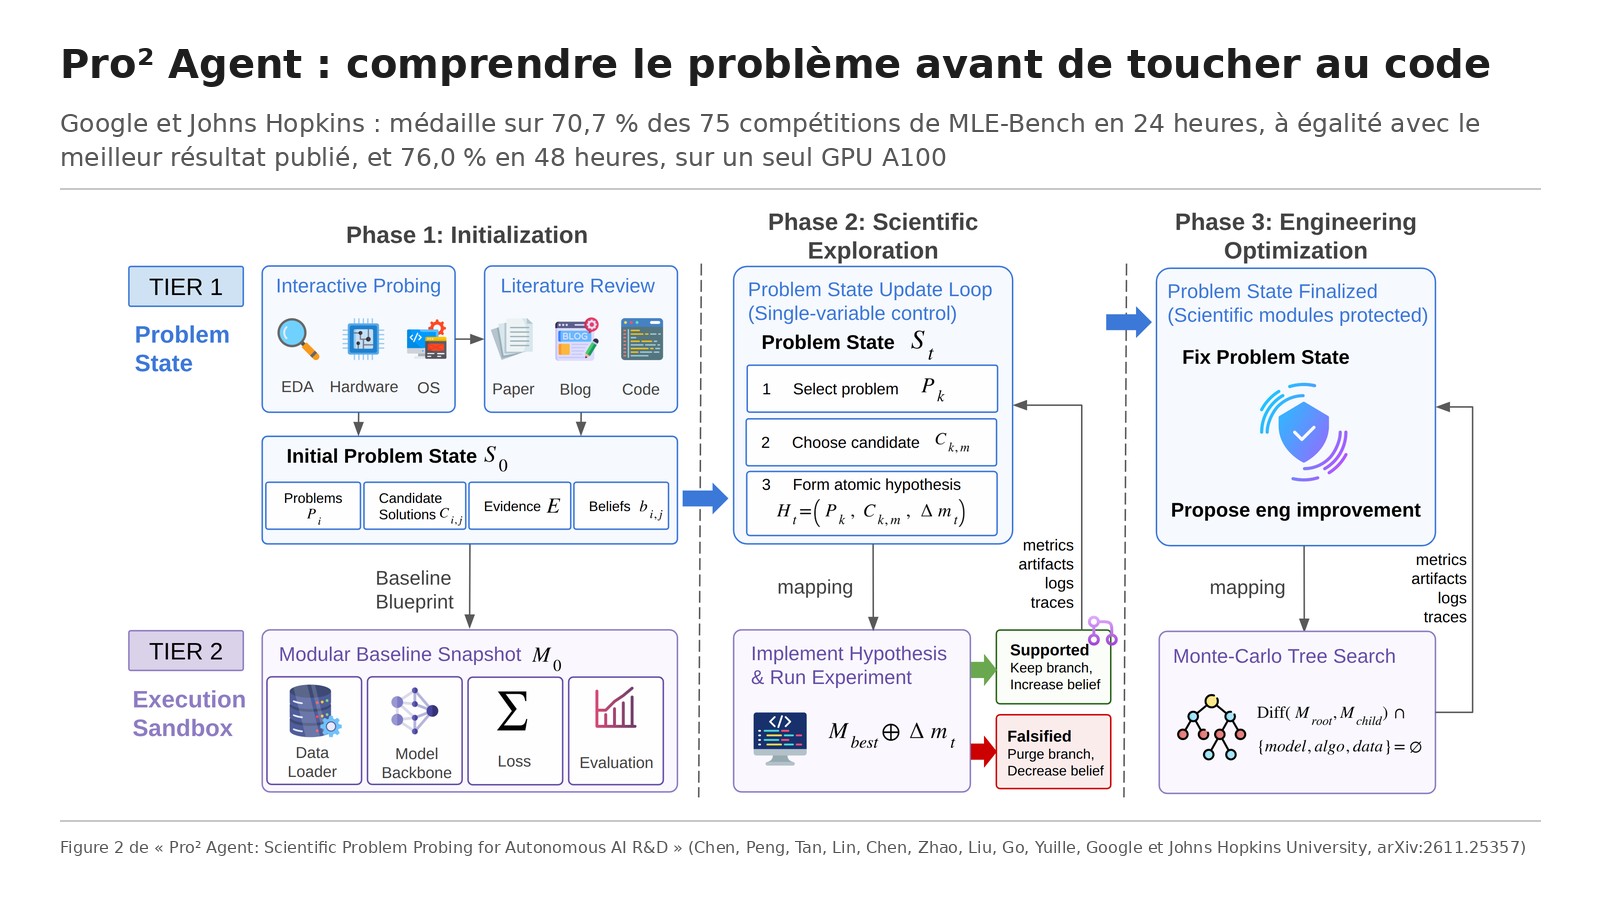
Pro² Agent (pour Problem Probing, « sonder le problème ») fait de cette compréhension son état principal. L’« état du problème » liste ce qui empêche de réussir, les preuves de chaque blocage, les solutions candidates, et un score de confiance pour chacune, tiré de la littérature ou des expériences. Les expériences ne servent plus seulement à choisir entre deux versions du code : elles testent une explication et la renforcent ou l’affaiblissent.
Ce que montre le papier
Trois phases et trois agents
L’initialisation commence par des sondages dans le bac à sable : petits scripts qui mesurent temps de traitement, mémoire et signaux propres aux données, puis extrapolent à l’échelle du jeu complet pour repérer les blocages (risque de saturation mémoire, lecture des données trop lente). En parallèle, l’agent cherche dans la littérature et sur le web des solutions à ces blocages, et en tire des hypothèses notées. Il construit alors une première solution modulaire, vérifiée sur de petits lots avant d’être lancée en entier. L’évaluation se fait hors du bac à sable, par un service séparé qui détient les vraies étiquettes, pour empêcher l’agent de tricher.
L’exploration scientifique teste ensuite une hypothèse à la fois, sur une branche Git isolée, en ne changeant qu’une seule variable. Les hypothèses sont classées par leur score de confiance, divisé par le nombre de tentatives déjà faites sur le même problème, pour éviter de s’acharner. Si le gain atteint la cible fixée à l’avance, la branche est gardée et la confiance augmente ; sinon, la branche est effacée et la confiance baisse. Une dernière phase règle les hyperparamètres et les ensembles de modèles par recherche arborescente Monte-Carlo, avec une pénalité sur le temps de calcul et l’interdiction de toucher au modèle, à l’algorithme ou aux données.
Le travail est réparti entre trois agents : un « chercheur principal » (Gemini 3.1 Pro) qui tient l’état du problème, fixe les objectifs et contrôle l’exécution toutes les 10 étapes, un agent d’implémentation et un agent relecteur (tous deux Gemini 3.5 Flash), qui vérifie notamment qu’une seule variable change. Une banque d’expériences garde les erreurs déjà rencontrées et leurs corrections.
MLE-Bench complet : 70,7 % en 24 heures, 76,0 % en 48 heures
MLE-Bench réunit 75 compétitions Kaggle (vision, langue, données tabulaires, séries temporelles, signal). Pro² Agent les traite toutes avec un GPU A100 par tâche, une fois avec 24 heures et une fois avec 48 heures. En 24 heures, il obtient une médaille sur 70,7 % des tâches, autant qu’AIBuildAI-2 (Claude Opus 4.7), le meilleur résultat publié. En 48 heures, il atteint 76,0 % : 57 médailles, dont 22 de bronze, 16 d’argent et 19 d’or, soit 5,3 points de plus qu’AIBuildAI-2 et 13,3 de plus que MARS+. Il rend une soumission valide sur toutes les tâches et dépasse la médiane du classement humain sur 84,0 % d’entre elles.
Le gain porte sur l’étendue plus que sur les premières places : MARS+ obtient davantage d’or (33,8 % contre 25,3 %), mais seulement 28,8 % de bronze et d’argent, contre 50,7 % pour Pro² Agent. Les auteurs y voient la conversion de tâches que les autres agents ratent en médailles de bronze ou d’argent.
PostTrainBench : au niveau de Claude Code avec Opus 4.7
Sur PostTrainBench, où l’agent doit post-entraîner un petit modèle de langage pour une tâche (28 combinaisons de quatre modèles et sept bancs), Pro² Agent obtient une moyenne pondérée de 30,69, contre 28,56 pour Claude Code avec Opus 4.7, 27,23 pour Codex avec GPT 5.5 et 21,99 pour OpenCode avec Gemini 3.1 Pro. Il reste loin derrière le meilleur agent publié (Fable 5 avec Claude Code, 41,79) et des modèles « instruct » officiels (51,14).
Des tests contrôlés sur MLE-Bench Lite
Sur les 22 tâches de MLE-Bench Lite (trois passages de 24 heures), les auteurs comparent Pro² Agent à deux variantes qui utilisent les mêmes modèles, outils et budgets, et à MARS. La première solution complète de Pro² Agent décroche déjà une médaille sur 57,6 % des tâches, contre 28,8 % pour MARS et pour un agent qui cherche des méthodes sans les organiser autour de problèmes, et 12,1 % pour une boucle de code directe. Après cinq solutions évaluées, il est à 66,7 % contre 39,4 % pour MARS. Les chiffres de MARS sont recalculés à partir des trajectoires publiées par ses auteurs, obtenues avec leur propre configuration (Gemini 3 Pro Preview) : ce n’est pas une comparaison à armes égales. L’ablation montre ce que chaque élément apporte : remplacer l’état du problème par un simple état du code fait tomber le taux final de médaille de 89,4 % à 56,1 %, retirer l’appui sur des preuves le ramène à 77,3 %, et un état du problème figé après l’initialisation à 83,3 %.
Des notes de recherche lisibles
Pour chaque tâche, l’agent consigne les blocages diagnostiqués, les hypothèses testées et leur issue, en distinguant les blocages résolus, ceux limités par le calcul disponible et ceux non résolus. Les auteurs détaillent quatre cas : une médaille de bronze sur la traduction de formules chimiques BMS, où aucun des systèmes AIRA et MARS examinés n’en avait obtenu ; un échec sur le dépistage du cancer du sein par mammographie, où le modèle plus gros n’a pas tenu dans le budget de calcul ; une réussite sur GSM8K avec Gemma3-4B (de 0 % à 56,50 %) ; et un échec sur AIME 2025 avec Qwen3-1.7B, où l’apprentissage par renforcement n’a reçu aucun signal parce que le modèle ne trouvait jamais la bonne réponse.
Les limites
Le papier ne comporte pas de section consacrée aux limites. À la lecture, plusieurs points tempèrent les résultats. Les scores sur MLE-Bench complet viennent d’un seul passage par budget, sans mesure de la variance. Le tableau de comparaison mêle des systèmes qui n’utilisent ni les mêmes modèles, ni le même matériel, ni la même durée (de 12 à 48 heures) ; les auteurs le reconnaissent, et le résultat à 76,0 % est obtenu avec deux fois plus de temps que les 24 heures standard. Sur PostTrainBench, les résultats publiés des autres agents ont été obtenus en 10 heures sur un H100, contre 24 heures sur un A100 pour Pro² Agent. Le système utilise deux modèles Gemini récents, dont un plus fort pour la supervision : le coût en tokens n’est pas indiqué. Le code n’est pas publié et les notes de recherche, présentées comme un atout, ne sont pas mises à disposition : rien n’est reproductible en l’état. Enfin, le meilleur résultat repose surtout sur des médailles de bronze et d’argent ; sur l’or, d’autres systèmes font mieux.
Lecture Neurone21
Pour une entreprise qui voudrait confier à un agent des projets de modélisation (prévision, classement, détection), ce papier dit surtout comment organiser le travail, plus que quel modèle acheter. Les ingrédients sont transposables : faire d’abord un diagnostic écrit de ce qui limite la performance, chercher des solutions connues pour chaque blocage, tester une seule chose à la fois avec un objectif chiffré fixé à l’avance, effacer ce qui ne marche pas, et évaluer hors de portée de l’agent. C’est la discipline d’une bonne équipe de data science, appliquée à un agent. Le partage du travail entre un modèle fort qui supervise et un modèle léger qui code est aussi une piste d’économie. Le journal des hypothèses testées et de leur issue a un intérêt direct pour une équipe humaine qui doit relire, auditer ou reprendre le travail. Mais les chiffres viennent d’une seule exécution, sur des compétitions Kaggle aux données propres : un projet réel, avec des données incomplètes et un objectif flou, reste à tester.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.25357v1. Les chiffres principaux sont conformes au papier : 76,0 % de taux de médaille sur MLE-Bench complet en 48 heures, 70,7 % en 24 heures (à égalité avec le meilleur résultat publié, celui d’AIBuildAI-2), l’« état du problème » comme état central de l’agent, des notes de recherche produites pour chaque tâche. Trois précisions. Ces taux viennent d’un seul passage par budget, avec un GPU A100 par tâche, et le résultat à 76,0 % double le temps standard de 24 heures. Le papier est cosigné par l’université Johns Hopkins, pas seulement par Google. Les notes de recherche sont décrites et illustrées par quatre cas, mais ni elles ni le code ne sont publiés.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.25357
- Le PDF : https://arxiv.org/pdf/2611.25357
- Notre fiche sur RSI-Dojo, un modèle qui apprend à post-entraîner d’autres modèles sur PostTrainBench : /p/rsi-dojo-agents-post-entrainement-modeles
- Notre fiche sur un agent de code simple face aux systèmes multi-agents sur MLE-Bench chez Apple : /p/apple-ml-agents-coding-simples-vs-multi
- Notre fiche sur les agents de recherche de bout en bout de Sakana AI : /p/sakana-scientifique-agentique
- Notre page Google Gemini : /wiki/google-gemini