Titre original : The Agentic Scientist: Orchestrating Coding Agents for Automated Scientific (Co-)Discovery
Auteurs : Robert Tjarko Lange, Luca Grillotti, Yutaro Yamada (contribution égale), Rujikorn Charakorn, David Ha
Affiliation : Sakana AI.
Publication : déposé sur arXiv le 13 octobre 2026 (version 1), 88 pages avec annexes.
Liens : page arXiv, PDF, code sur GitHub et outil de figures autoillustrate, tous deux sous licence Apache 2.0.
L’idée en bref
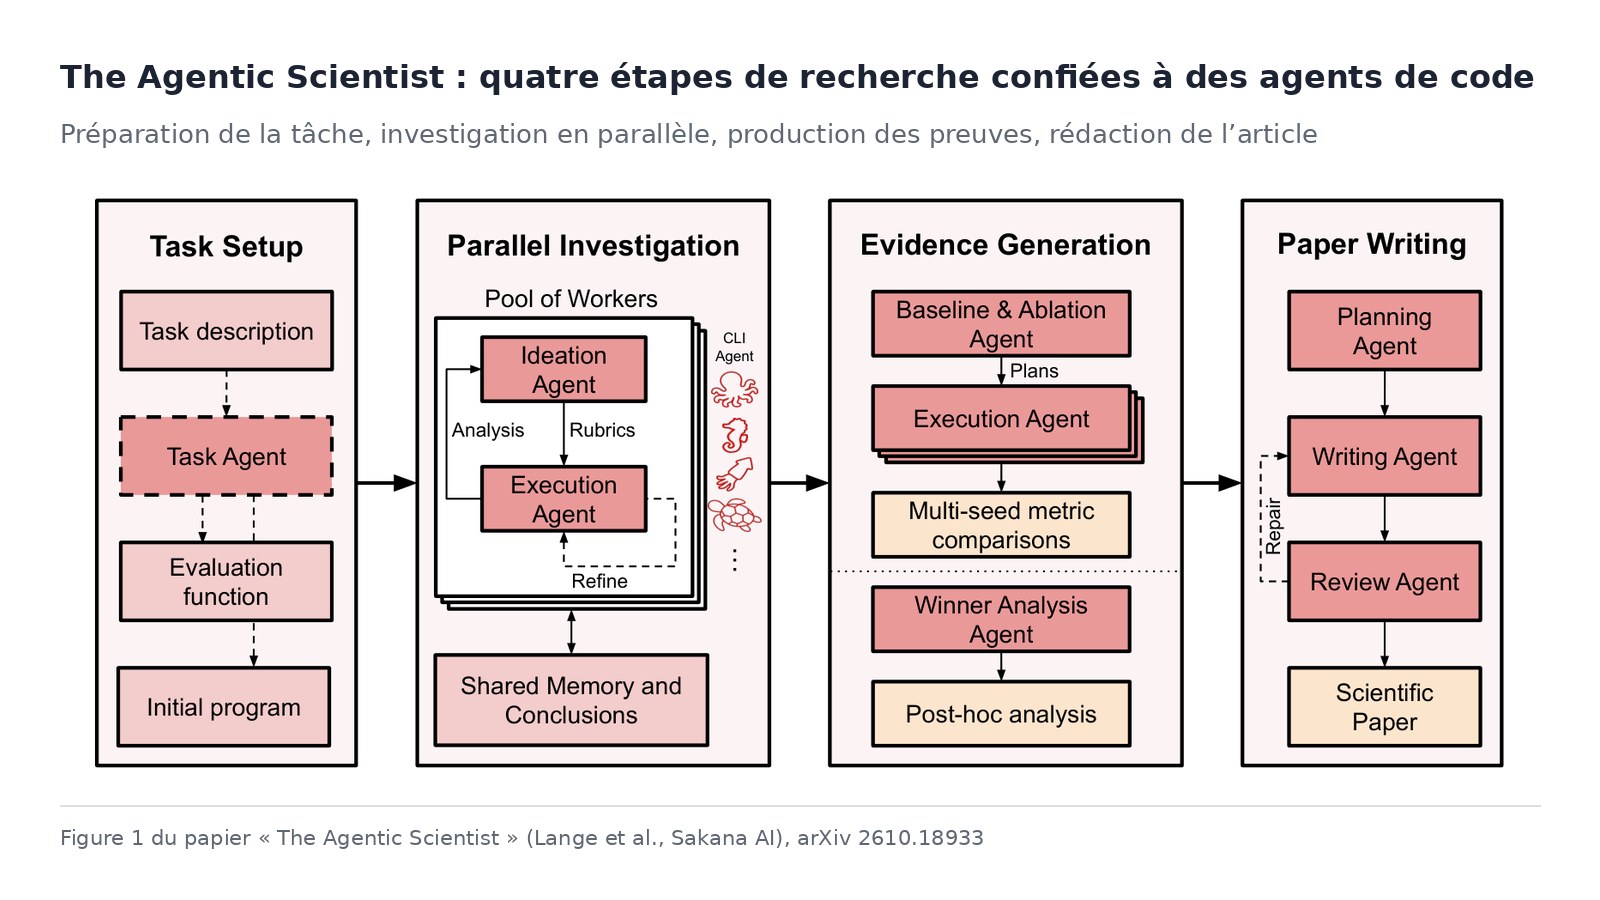
Les agents de code (Claude Code, Codex et leurs équivalents) savent écrire et lancer des programmes pendant des heures. Mais une recherche ne se résume pas à une longue tâche de code : il faut formuler des hypothèses, tester proprement, vérifier, comparer et rédiger. Laissés seuls, ces agents ont tendance à « grimper la pente » la plus proche, comme un outil de réglage d’hyperparamètres. Sakana AI, déjà auteur de The AI Scientist, propose une couche d’orchestration : un méta-contrôleur découpe le projet en étapes, en confie chacune à un agent de code, fait tourner plusieurs agents en parallèle et n’accepte une étape que si elle passe une grille de critères (rubric) rédigée en amont.
Ce que montre le papier
Une chaîne en quatre temps. Préparation d’une tâche exécutable (programme de départ, évaluateur, contrat), investigation par des « travailleurs » parallèles qui partagent une mémoire de conclusions, production de preuves (références de comparaison, ablations, c’est-à-dire retrait d’un ingrédient à la fois pour mesurer son effet, et analyses a posteriori), puis rédaction d’un article dont chaque chiffre doit renvoyer à un résultat enregistré, relu par un agent d’audit chargé de traquer les affirmations exagérées.
Un article accepté, avec des humains dans la boucle. Une version de développement du système a servi à étendre une méthode d’apprentissage sans rétropropagation, la diffusion d’erreur. Les chercheurs ont fixé la direction, les contraintes et les grilles, porté les meilleures solutions vers l’apprentissage par renforcement, vérifié résultats et références. Ils ont supprimé des citations qui ne soutenaient pas le propos et corrigé des formulations excessives (« dépasse nettement » devenu « fait jeu égal »). L’article a été accepté comme présentation orale à ALIFE 2026, avec des avis allant de « rejet faible » à « acceptation forte ». Les auteurs insistent : c’est un travail humain assisté, pas une sortie brute du système.
70 campagnes autonomes. Cinq tâches d’apprentissage automatique, quatre harnais (Codex, Claude Code, Pi, OpenCode) et 14 combinaisons harnais et modèle. À modèle égal, le harnais change peu le résultat ; le modèle compte davantage. La qualité des manuscrits, notée par un relecteur automatique, progresse avec les modèles plus récents. Les études de cas donnent notamment un optimiseur évolutionnaire appris qui égale ou dépasse la référence CMA-ES sur cinq des sept environnements de contrôle Brax non vus pendant la recherche, selon le résumé.
Les limites
Les auteurs sont explicites (section 8) :
- Une évaluation par procuration. La note des 70 manuscrits vient d’un relecteur automatique, pas d’experts ; un seul article a été soumis à une vraie relecture par les pairs.
- Une vérification bornée par les grilles. Les évaluateurs et critères peuvent laisser passer des erreurs de méthode ou récompenser des raccourcis : le système a ainsi modifié le protocole d’évaluation sur une partie des essais de réglage par renforcement.
- Des gains parfois d’ingénierie. Une meilleure note peut venir de la recombinaison de techniques existantes plutôt que d’une idée nouvelle.
- Une préparation de tâche fragile sur les projets complexes, et une recherche bibliographique faite seulement au moment de la rédaction.
- Un rôle de l’orchestration peu isolé. L’idée, reprise par Elvis Saravia, que la fiabilité dépend autant de la couche d’orchestration que du modèle s’appuie sur des ablations partielles (nombre de travailleurs, mémoire partagée, sur une seule tâche), pas sur une comparaison avec et sans orchestrateur.
- Un périmètre limité à l’informatique : rien ne dit que la méthode vaut pour des expériences physiques ou sur des humains.
Lecture Neurone21
Le papier déplace la question de « l’IA peut-elle faire de la recherche ? » vers « comment encadrer des agents pour qu’on puisse se fier à ce qu’ils produisent ? ». Sa réponse tient en un mot, le contrat : une tâche exécutable, des évaluateurs séparés, des critères vérifiés à chaque étape et une traçabilité de chaque chiffre. Ce schéma vaut bien au-delà des laboratoires, pour toute équipe qui confie à des agents des analyses longues dont elle devra répondre.
Le récit de l’article d’ALIFE est aussi un rappel utile : le système a produit un manuscrit défendable, mais il a fallu des humains pour retirer des références erronées et des conclusions trop fortes. L’autonomie complète sert à explorer beaucoup de pistes à bas coût ; la validation reste humaine.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.18933
- Le PDF : https://arxiv.org/pdf/2610.18933
- Le code : https://github.com/SakanaAI/AI-Scientist-v3
- L’outil de figures autoillustrate : https://github.com/SakanaAI/Autoillustrate
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2110733945323368822
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/the-agentic-scientist-orchestrating-coding-agents-for-automated-scientific-co-di-2610.18933