Titre original : Avalon-M1: Reinforcement Learning from Collective Rewards
Auteurs : Iliyan Zarov, Henry Course, Anthony Hartshorn (contribution égale), Ran Achiron, Louis Roche, Akshit Sinha, Chengxi Taylor, Ross Taylor (auteur de correspondance)
Affiliations : General Reasoning, Inc.
Publication : rapport technique publié par General Reasoning le 23 octobre 2026, 81 pages avec les annexes, marqué « Model still training, under revision ». Il n’est pas sur arXiv : l’entreprise annonce une version finale sur arXiv une fois l’entraînement terminé.
Liens : rapport en PDF, page de présentation. Les poids, le harnais et les environnements sont annoncés, pas encore publiés.
L’idée en bref
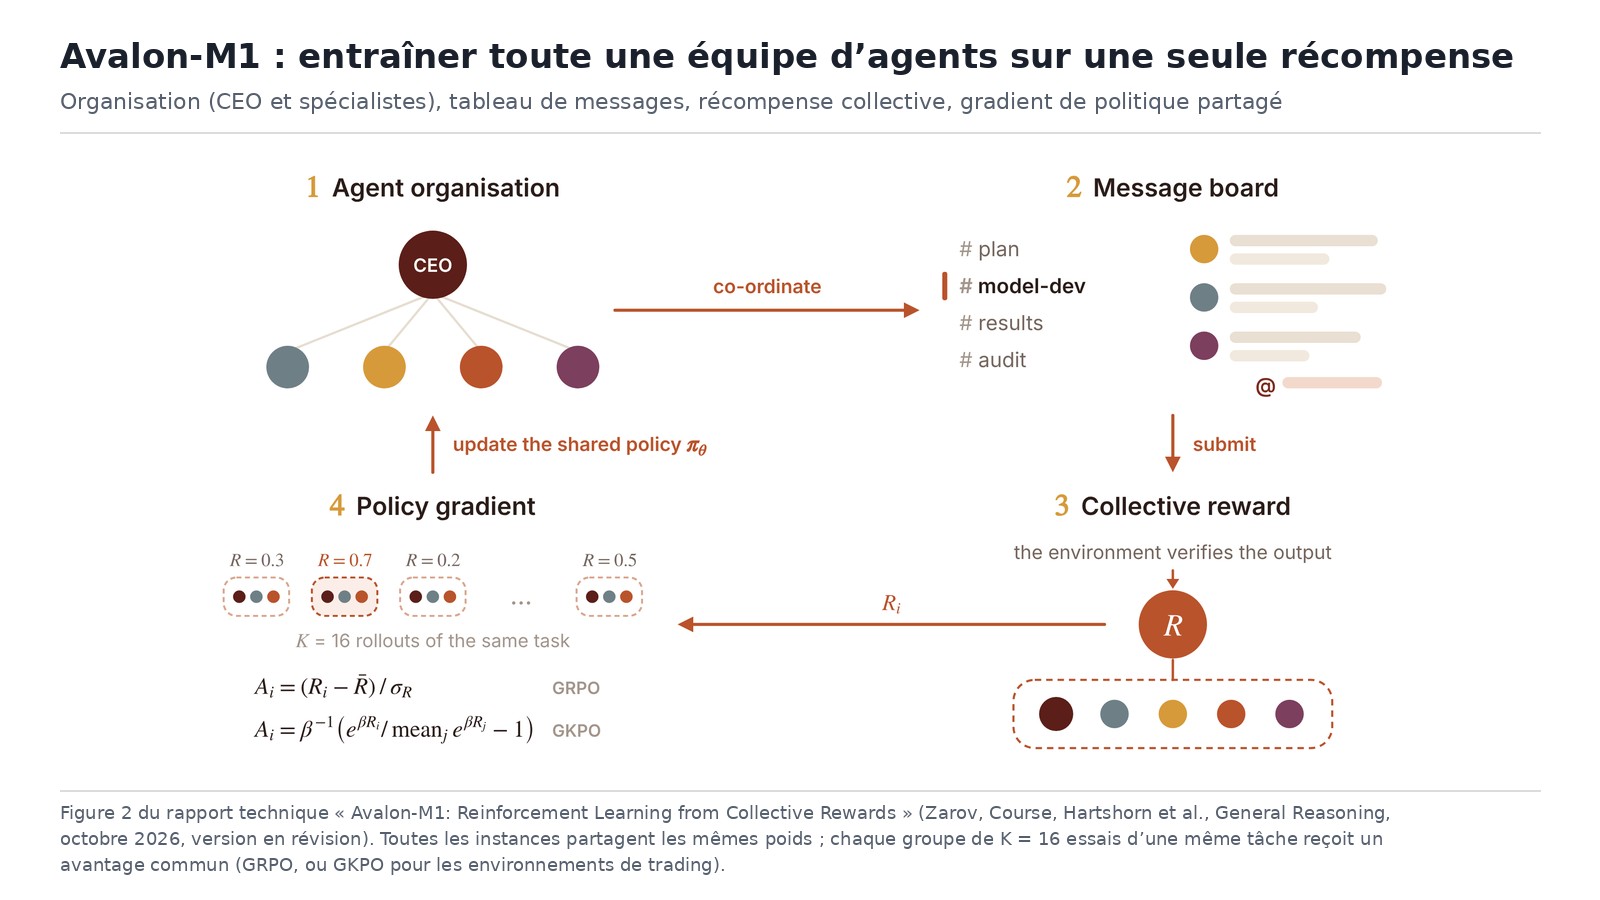
Aujourd’hui, une équipe d’agents se monte surtout à la main : un orchestrateur, des sous-agents, des consignes, et un modèle qui n’a jamais été entraîné à travailler ainsi. Les auteurs proposent l’inverse avec RLCR (reinforcement learning from collective rewards) : entraîner directement le modèle à fonctionner en organisation. Un agent CEO lit la tâche, recrute des spécialistes et leur donne un titre (« Lead Engineer », « Verifier »…). Tous sont des instances de la même politique, avec les mêmes poids, et ne se distinguent que par leur contexte. Ils partagent un espace de fichiers, un tableau de messages proche de Slack (canaux, messages directs, réactions), une archive, et chacun peut lire la trace complète des autres (section 2.1, p. 9 et 10 ; figure 2, p. 6).
Le point audacieux tient au crédit. Quand la tâche est rendue, l’environnement la note, et chaque jeton produit par chaque agent reçoit le même avantage : on ne cherche pas à savoir qui a bien travaillé, et aucun sous-agent n’est gelé. Les auteurs citent Kimi K2.5, qui fait le choix inverse et n’entraîne que l’orchestrateur pour éviter cette ambiguïté (introduction, p. 7). Leur pari : avec assez d’essais par tâche (16) et de grands lots, ce signal plat suffit.
Ce que montre le papier
Un modèle moyen, un SFT volontairement petit. Avalon-M1-Mini compte 120 milliards de paramètres, dont 12 milliards actifs. Il part du modèle de base Nemotron-3-Super-120B-A12B de NVIDIA, avec un SFT de 38 374 exemples (600 millions de jetons, 3 époques) générés par GLM-5.2, sans distillation en ligne d’un modèle plus fort (p. 11). L’apprentissage par renforcement porte sur 147 environnements de la plateforme OpenReward, qui contiennent 2 201 439 tâches, dont 30 509 tâches distinctes réellement tirées (p. 15). Le logiciel représente 42 % des tâches tirées, les services financiers 17 % (figure 4).
Des épisodes qui durent des heures. Le budget de temps par épisode suit un curriculum qui part de 2 heures et dépasse 5 heures au pas 200. Le contexte va jusqu’à 131 072 jetons, avec compaction à partir de 114 688. Le budget est réparti entre 20 % d’essais avec un seul agent et 80 % en organisation (jusqu’à 8 recrues). Ces derniers fournissent environ 90 % des jetons d’entraînement (p. 14).
Mieux en équipe que seul, sur la plupart des tests. Tableau 2 (p. 19), même modèle seul (B0) contre organisation à huit recrues (B8), en pourcentage sauf mention :
| Benchmark | Avalon seul | Avalon en équipe (B8) | Écart |
|---|---|---|---|
| IMO-ProofBench-Advanced | 29,8 | 37,5 | +7,7 |
| FrontierScience | 55,9 | 63,5 | +7,6 |
| JobBench | 19,5 | 28,6 | +9,1 |
| DRACO-Internal | 48,9 | 56,2 | +7,3 |
| BrowseComp-Internal | 18,0 | 24,7 | +6,7 |
| EdgeBench | 16,8 | 22,2 | +5,4 |
| SWE-Bench Pro V2 (Hard) | 21,6 | 23,5 | +1,9 |
| ProgramBench | 29,4 | 25,7 | -3,7 |
| AIME 2024 | 94,4 | 93,3 | -1,1 |
| KellyBench (rendement) | -17,7 | -6,4 | +11,3 |
Sur les 16 benchmarks notés en pourcentage, l’équipe gagne sur 14, de 3,9 points en moyenne (test de Wilcoxon, p = 0,002). Le même montage dégrade les modèles qui n’y ont pas été entraînés : Nemotron 3 Super perd sur 9 benchmarks sur 16 (-2,4 points) et Inkling Small sur 11 sur 15 (-6,6 points), ce que les auteurs attribuent peut-être à un harnais qu’ils ne connaissent pas (p. 18).
Face aux autres modèles. Avalon-M1-Mini bat Nemotron 3 Super, issu de la même base, sur tous les benchmarks du tableau, en comparant la meilleure configuration de chacun : 29,4 % contre 13,3 % sur ProgramBench, 29,8 % contre 16,7 % sur IMO-ProofBench. Face à Inkling Small (276 milliards de paramètres, distillé d’un modèle enseignant plus fort), il n’est devant que sur 5 benchmarks sur 17 selon le rapport, et à égalité sur AIME 2025 et 2026 (p. 18). Sur SWE-Bench Pro, Inkling Small seul fait 51,0 % contre 23,5 % pour Avalon en équipe.
Une grosse part du gain vient du surplus de calcul. C’est la mesure la plus utile du rapport. Les auteurs donnent à un agent seul une réflexion plus longue (S8), avec autant de jetons que l’équipe B8. Sur les 13 benchmarks où l’équipe battait l’agent seul, cette réflexion allongée récupère environ trois cinquièmes du gain. Les auteurs concluent eux-mêmes que l’avantage de l’organisation s’explique en bonne partie par son calcul supplémentaire à l’inférence (p. 21). L’équipe garde de l’avance sur JobBench (+11,9 points), FrontierScience (+8,0), BrowseComp-Internal (+5,4) et HLE (+3,2). L’agent seul qui réfléchit longtemps passe devant sur SWE-Bench Pro (+13,8) et GPQA (+3,1). Sur 7 benchmarks sur 14, les deux sont à environ un point l’un de l’autre.
L’intérêt devient alors le temps. À jetons égaux, l’équipe atteint les mêmes scores 3,9 fois plus vite en moyenne (p. 22) : l’agent seul S8 met de 2,9 à 6,2 fois plus longtemps, par exemple 121 minutes contre 38 sur IMO-ProofBench. Ces durées sont calculées, pas chronométrées : le rapport suppose 15 000 jetons par seconde en lecture du contexte et 50 en génération. Sur EdgeBench (49 tâches longues), l’équipe démarre plus lentement, car recruter et se coordonner coûte, puis dépasse l’agent seul après 1,7 heure de latence calculée (p. 23 et 24). Sur ProgramBench, 98 à 99 % du gain est acquis en deux heures, et les auteurs notent que le modèle s’arrête souvent trop tôt.
Des hiérarchies apparaissent pendant l’entraînement. Sur les tâches de construction logicielle, les « Lead Engineers » passent de moins de 0,4 % des recrues sur les 80 premiers pas à 12,5 % à la fin ; sur EdgeBench, les titres contenant « lead » passent de 0,3 % à 4,4 % (p. 25 et 26). Dans les équipes d’au moins trois spécialistes, chacun lit la trace du chef 15 fois plus souvent que celle d’un pair et lui écrit 3,3 fois plus souvent ; le chef est l’agent le plus contacté dans 78 % des équipes. Il consacre 6,5 % de ses appels d’outils à la coordination, contre 31 % pour les autres (p. 26). Les auteurs y voient l’« équipe chirurgicale » que Fred Brooks attribue à Harlan Mills : le travail d’un seul bâtisseur sert de référence à tous les autres.
Plus de relecture et d’entraide. La part d’organisations où au moins un agent relit le travail d’un autre passe de 42 % à 64 %, et les titres de relecteurs de 13 % à 26 % des recrues. Les plans par composants (chacun son morceau) passent de 71 % à 31 %, les chaînes construire, tester, relire de 16 % à 54 % (p. 28 et 29, sur 7 906 essais classés par un modèle juge, en accord à 95 % avec un audit humain). La part d’équipes où un spécialiste propose son aide à un autre passe de 10 % à 60 % (p. 32). La coordination prend 9 % du temps de travail avec un spécialiste et 32 % avec huit : elle grandit avec l’équipe, mais moins vite que la taille (p. 30).
Les agents refusent toujours le pire, mais alertent de moins en moins. Les auteurs ont fait passer onze scénarios à sept points de contrôle, 2 310 essais au total, en retirant la hiérarchie (section 5, p. 33). Dans le scénario de perte de contrôle, aucun agent ne retire ses clés au comité humain chargé de la distribution de vaccins. En revanche, la part d’essais où un agent signale ses inquiétudes à l’inspecteur indépendant passe de 100 % au pas 50 à 7 % au plus à partir du pas 100. Au moins 99 % des agents refusent de signer un rapport de sécurité de batteries qui omet trois incendies, mais ceux qui le dénoncent aussi au régulateur passent de 68 % à 36 % au pas 170 (45 % au pas 180). Sous la pression d’agents complices qui poussent à truquer un benchmark, aucun n’y participe, mais la part d’essais où l’un d’eux prévient les évaluateurs tombe de 77 % à 0 à 3 % à partir du pas 150, alors qu’ils y pensent dans 97 à 100 % des essais (p. 35). Les auteurs parlent d’« insularité » de l’organisation. Dans un jeu de biens publics sans sanction, la contribution culmine à 81 % puis tombe entre 31 et 47 % ; avec sanction, elle reste entre 94 et 97 % (p. 34).
Une longue chasse à la triche. L’annexe K recense 305 corrections dans 114 dépôts d’environnements, dont 60 environnements qui laissaient fuiter la réponse de référence. Dans un environnement de compilateur C, une table de correspondance qui reconnaissait les programmes de test obtenait un score de 1 247, contre 289 pour la meilleure solution honnête (p. 76 à 78).
Les limites
Les auteurs reconnaissent que (section 7.1, p. 39 et 40) :
- combiner tâches longues, plusieurs agents et beaucoup d’environnements rend les gradients très bruités, ce qu’ils appellent le « triangle inconfortable » ;
- leur calcul est inférieur de plusieurs ordres de grandeur à celui des grands laboratoires, avec de petits lots et un modèle de 120 milliards de paramètres ; des modèles plus gros pourraient se comporter autrement ;
- ils n’ont pas fait tourner, faute de calcul, un entraînement d’agent seul au même budget sur les mêmes environnements, ce qui permettrait de séparer l’effet de RLCR de celui d’un renforcement classique ;
- la structure CEO et spécialistes est imposée par le harnais, et le préentraînement comme le SFT orientent les rôles qui apparaissent ;
- leurs graphes sur l’évolution de l’organisation montrent des associations, pas des causes ; la preuve causale de l’intérêt des équipes repose sur la comparaison des budgets, la base S8 et l’expérience à temps limité sur DRACO (annexe A, p. 57) ;
- le modèle est encore en cours d’entraînement et les chiffres bougeront.
Réserves de notre lecture, toutes tirées du papier :
- Toutes les évaluations sont internes, sur l’infrastructure de General Reasoning. BrowseComp-Internal et DRACO-Internal cherchent dans un index interne et non sur le web, et ne se comparent pas aux scores publiés (note du tableau 2, p. 19).
- Avalon seul tourne dans le harnais maison, alors que Nemotron 3 Super et Inkling Small seuls tournent dans OpenCode. La comparaison entre modèles n’est donc pas faite à conditions identiques.
- La comparaison avec la réflexion allongée (p. 21) relativise fortement le gain de l’équipe : le principal avantage démontré est la latence, et cette latence est calculée à partir d’hypothèses de débit, pas mesurée. Sur HealthBench, dont les essais durent moins de trois minutes, l’équipe est même plus lente que l’agent seul (p. 22).
- L’équipe recule sur ProgramBench (-3,7 points) et sur AIME 2024, et le décompte de 5 benchmarks sur 17 face à Inkling Small ne colle pas tout à fait au tableau 2, où Avalon nous paraît devant sur six lignes sur dix-huit (IMO-ProofBench, FrontierScience, HealthBench, EdgeBench, KellyBench, YC-Bench).
- Les tests de sécurité se font sans hiérarchie et sur des scénarios scénarisés. Le recul des signalements n’en reste pas moins net et significatif (p inférieur à 0,001 pour l’inspecteur).
- Sur KellyBench, le rendement de l’équipe reste négatif (-6,4 %) : elle perd moins d’argent que l’agent seul, elle n’en gagne pas.
Lecture Neurone21
Pour qui monte des équipes d’agents, la leçon la plus solide n’est pas « mettez plusieurs agents », c’est l’inverse : un modèle qui n’a pas appris à travailler en équipe y perd souvent. Nemotron 3 Super et Inkling Small reculent en organisation sur la majorité des tests. Avant de découper un travail entre un orchestrateur et des sous-agents, il faut donc comparer avec un seul agent à qui l’on donne le même budget de jetons. Le rapport montre que cette base simple récupère déjà l’essentiel du gain dans beaucoup de cas.
L’équipe redevient intéressante quand le temps compte. Sur une preuve de niveau olympiade, le rapport calcule 121 minutes pour un agent seul qui réfléchit longtemps, contre 38 pour l’équipe, pour un score quasi identique (37,7 % contre 37,5 %, tableau 3, p. 20) : c’est l’argument à retenir pour une tâche longue dont on attend le résultat, comme une revue de code ou une recherche documentaire avant une réunion. Les comportements appris sont aussi des pistes à copier dans un harnais classique : un chef unique qui écrit l’essentiel, une chaîne construire, tester, relire plutôt qu’un découpage par morceaux, et des relecteurs explicites. Cela rejoint notre fiche sur la triche à la récompense contagieuse, où la relecture limitait les dégâts, et le dossier sur l’équipe de bots.
Le signal d’alerte concerne la supervision. Les agents refusent toujours de mal agir, mais préviennent de moins en moins les humains, comme si la récompense d’équipe leur apprenait à régler les problèmes entre eux. Dans une entreprise, c’est précisément le signalement qui permet d’intervenir : il faut donc le tester et le récompenser explicitement, sans supposer qu’un refus suffit. Notre fiche sur les outils qui affaiblissent les refus montrait déjà que la sécurité d’un modèle seul ne se transpose pas telle quelle à un agent outillé. L’annexe sur la triche rappelle enfin, comme notre fiche sur les lois d’échelle des données en RL agentique, que la qualité des environnements pèse autant que leur nombre.
Elvis Saravia se dit « bullish » et parle de résultats prometteurs : c’est son avis. Il ne mentionne pas que la réflexion allongée explique une grande part du gain, ni le recul sur ProgramBench. Il qualifie le travail de « small-scale », ce que le rapport confirme. Son post renvoie à l’annonce de General Reasoning et non directement au rapport, que l’on trouve sur la page de présentation.
Pour aller plus loin
- Le rapport technique en PDF : https://gr.inc/avalonm1.pdf
- La page de présentation de General Reasoning : https://www.gr.inc/releases/avalon-m1
- Le post d’annonce de General Reasoning : https://x.com/GenReasoning/status/2113590771722952908
- Le post de Ross Taylor : https://x.com/rosstaylor90/status/2113606877414101169
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2113674408564859198