Titre original : The First Few Tokens Matter: Understanding Chain-of-Thought Controllability
Auteurs : Hugh Van Deventer (Harvard University et Cambridge Boston Alignment Initiative, auteur de correspondance), Dmitrii Troitskii (Cambridge Boston Alignment Initiative) et Laura Ruis (MIT).
Publication : prépublication arXiv 2610.40939v1 (cs.AI), déposée le 29 octobre 2026, 20 pages et 15 figures. Le papier n’indique pas de relecture par un comité.
Liens : page arXiv, PDF, code sur GitHub.
L’idée en bref
Les modèles de raisonnement écrivent leurs réflexions en langage naturel avant de répondre, ce qu’on appelle la chaîne de pensée (CoT, pour chain of thought). Surveiller cette chaîne est devenu un moyen de contrôler des agents : on y lit parfois un plan de contournement ou une triche sur la récompense. Cette surveillance marche en partie parce que les modèles actuels contrôlent mal ce qu’ils écrivent dans leur raisonnement. Si on leur demande de raisonner en majuscules ou sans utiliser un mot précis, ils échouent le plus souvent, alors qu’ils obéissent sans peine dans leur réponse finale. On parle de contrôlabilité de la chaîne de pensée.
Les auteurs se demandent pourquoi ce contrôle est si faible, et si un modèle plus contrôlable serait forcément moins surveillable. Ils trouvent qu’une bonne part de l’échec se joue dès les premiers mots du raisonnement.
Ce que montre le papier
Les premiers mots sont presque toujours les mêmes
Les auteurs testent huit consignes de contrôle réparties en trois familles : supprimer une information (éviter la première personne, omettre un mot), en ajouter (préfixer ou terminer chaque phrase par un marqueur, numéroter les phrases) et changer le style (écrire en espagnol, en leetspeak ou en majuscules). Les consignes sont ajoutées à des questions tirées de CommonsenseQA, ARC-Challenge, GPQA, MMLU-Pro et Humanity’s Last Exam. Les expériences d’intervention portent sur Qwen3-14B, Qwen3-32B, OLMo-3.1-32B-Think et GLM-5.2, et un panel de douze modèles, de 14 à 753 milliards de paramètres, sert aux corrélations.
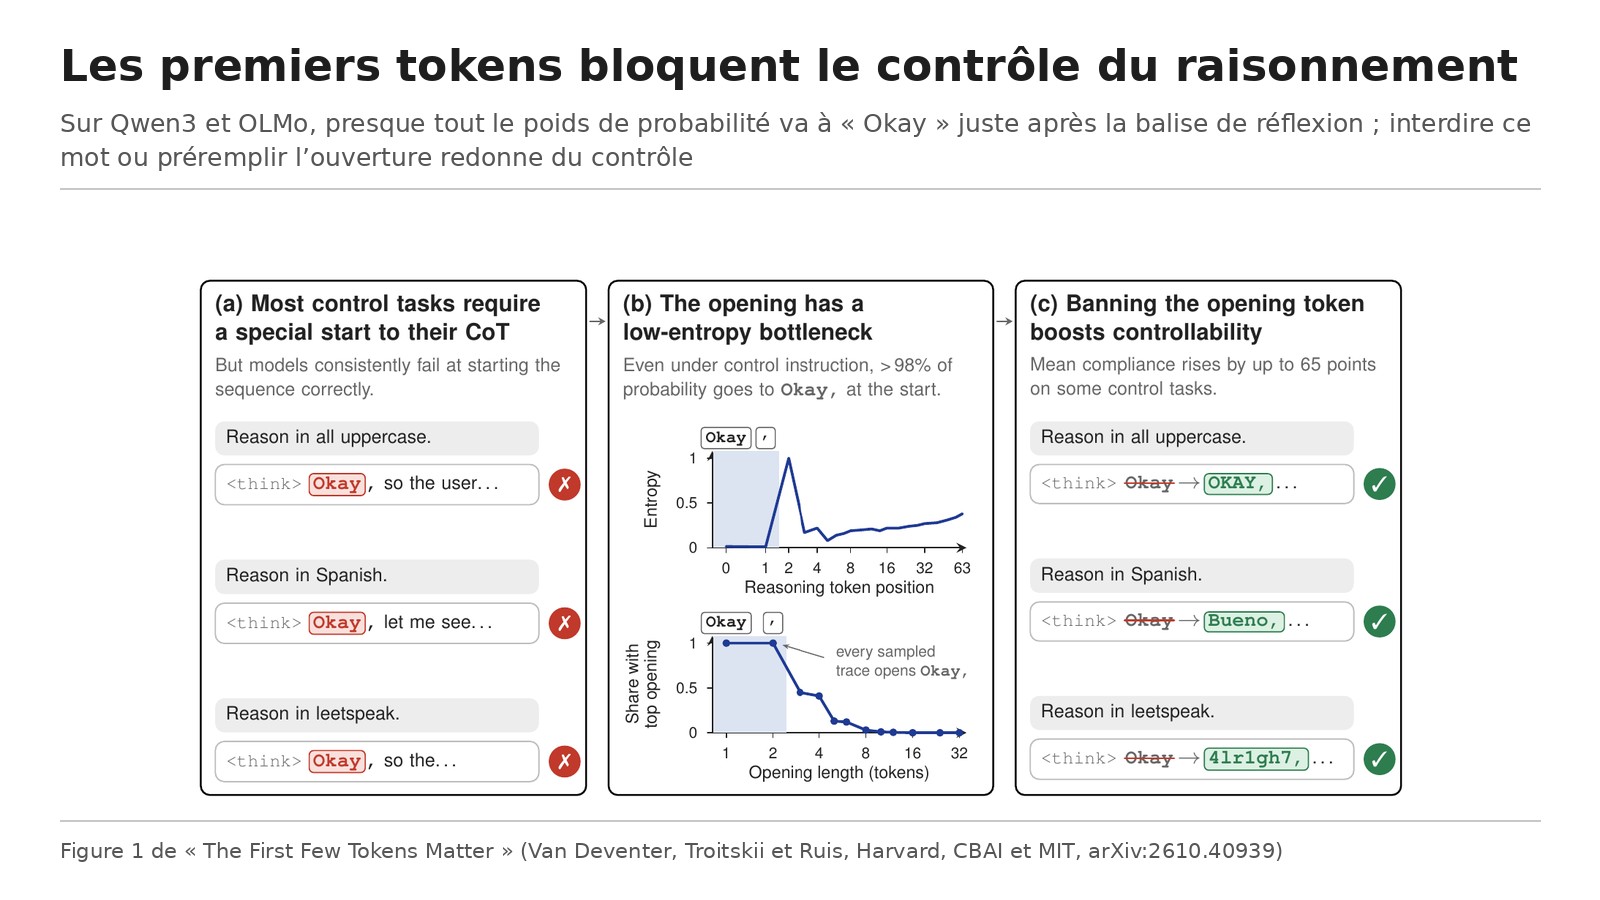
Premier constat : quand une réponse échoue, c’est presque toujours au tout premier token. Sur quatre tâches testables au niveau du token, 97,9 % à 98,9 % des réponses ratées violent la consigne dès leur premier token non vide (section 3.2). Et pour toutes les stratégies de prompt, plus de 63 % des réponses notées sous 0,5 échouent à ce premier token.
La raison tient à une concentration extrême. Sans consigne, le mot « Okay » reçoit 99,89 % de la probabilité au début du raisonnement de Qwen3-32B et 99,52 % pour OLMo-3.1-32B-Think. Avec la consigne, il en reçoit encore 99,40 % et 98,48 %. La séquence « Okay, » apparaît dans toutes les réponses sans consigne. GLM-5.2 est plus varié : « The question, » tombe de 77,7 % à 30,0 % avec la consigne. L’entropie du modèle, c’est-à-dire son incertitude sur le mot suivant, est quasi nulle sur les deux premières positions, puis remonte (figure 4).
La consigne n’est pas ignorée pour autant : elle augmente la probabilité des tokens conformes dans chaque couple modèle-tâche. Mais cette probabilité totale reste sous 0,25 % : le modèle a « entendu » la demande, il ne lui laisse pas assez de place pour commencer autrement.
Deux petites interventions redonnent du contrôle
La première consiste à préremplir le début du raisonnement avec des tokens conformes. Dès un seul token fourni, la conformité moyenne bondit nettement ; les tokens suivants n’ajoutent qu’un gain marginal (figure 5, section 3.3). La seconde consiste à interdire le mot d’ouverture, « Okay » et « Alright », au premier emplacement du raisonnement, éventuellement avec des exemples dans le prompt.
Sur Qwen3-32B, interdire l’ouverture fait passer la conformité moyenne de 0,078 à 0,254 ; avec en plus des exemples, elle atteint 0,490. Sur OLMo-3.1-32B-Think, on passe de 0,029 à 0,225, puis 0,374 avec les exemples (figure 6). Cela fait 41,2 et 34,5 points de plus que la consigne seule, ce que le résumé du papier arrondit en « 34 à 41 points ». Pour Qwen, la majuscule monte à 0,775 et le leetspeak à 0,652 alors qu’ils restaient proches de zéro avec les seuls exemples. GLM-5.2 est déjà assez contrôlable : avec un exemple complet de conversation, sa conformité de base passe de 50,0 % à 64,4 % (figure 2).
Ajouter ou transformer, ce n’est pas supprimer
Les interventions aident surtout les tâches d’ajout et de style. Les tâches de suppression réagissent de façon plus irrégulière : le préremplissage change peu l’omission d’un mot, alors que les exemples dans le prompt aident surtout les suppressions.
Les corrélations entre les douze modèles confirment cette séparation. Entre les six tâches d’ajout et de style, elles sont toutes positives, de 0,13 à 0,88, avec une moyenne de 0,61. Entre les deux tâches de suppression, elle vaut 0,74. Entre les deux familles, elle va de moins 0,66 à 0,05, avec une moyenne de moins 0,29 (figure 7). Un modèle bon pour l’une est donc plutôt moins bon pour l’autre : ce sont deux aptitudes distinctes.
Plus de contrôle ne veut pas toujours dire moins de surveillabilité
Les auteurs comparent aussi la contrôlabilité à la surveillabilité du raisonnement, mesurée par six évaluations reprises de Guan et al. (2025), « Monitoring monitorability » : un moniteur doit retrouver, depuis la seule chaîne de pensée, une influence extérieure, les étapes de résolution ou une propriété de la réponse. Surprise : une contrôlabilité plus forte ne rime pas systématiquement avec une surveillabilité plus faible.
Le contraste le plus net vient de GPQA Physique. Les six tâches d’ajout et de style y sont corrélées positivement à la surveillabilité (de 0,29 à 0,74), alors que l’omission d’un mot et l’évitement de la première personne le sont négativement (moins 0,55 et moins 0,37). Sur l’évaluation d’intervention de GPQA, le même contraste est plus faible, de 0,01 à 0,43 d’un côté, moins 0,35 et moins 0,13 de l’autre (figure 8). Pour les autres évaluations, les liens sont faibles ou mélangés.
Les limites
Les auteurs reconnaissent que (sections 3.3, 4 et 5) :
- les expériences d’interventions ne couvrent que quelques modèles, et l’analyse de l’entropie exclut GLM-5.2, dont l’interface ne renvoie pas les probabilités des tokens de raisonnement ;
- les corrélations reposent sur douze modèles seulement et sont à lire comme descriptives, d’autant que plusieurs évaluations de surveillabilité sont bruitées ou collées au plafond ou au plancher ;
- ils ne testent pas une dissimulation délibérée : leurs mesures sont des approximations (suivre une consigne de forme dans le raisonnement), pas une mesure de la capacité à tromper un moniteur ;
- ils n’établissent pas que le goulot d’ouverture explique les corrélations observées.
Réserves de notre lecture :
- le papier est une prépublication sans relecture annoncée ;
- l’interdiction du mot d’ouverture n’a pu être appliquée qu’à Qwen et OLMo, car l’interface de GLM ne le permet pas : l’effet de 34 à 41 points ne repose donc que sur deux modèles ouverts de taille moyenne ;
- les évaluations d’intervention utilisent 30 questions par tâche et 3 à 5 échantillons, ce qui laisse de la marge d’incertitude sur chaque tâche prise isolément.
Lecture Neurone21
Le message utile pour une entreprise qui déploie des agents tient en une phrase : un faible score de contrôlabilité ne suffit pas à se rassurer sur la surveillance du raisonnement. Une grande partie de l’échec mesuré vient d’un réflexe de départ (toujours commencer par « Okay »), pas d’une incapacité profonde à agir sur le contenu. Or, selon les auteurs, une tentative de contournement n’a pas besoin de changer cette ouverture : un agent qui voudrait glisser une information trompeuse ou en taire une autre n’est pas gêné par ce goulot. Les évaluations actuelles risquent donc de sous-estimer ce que les modèles peuvent faire plus loin dans leur raisonnement.
La conséquence pratique est prudente. Il ne faut pas fonder un contrôle de sécurité sur la seule lecture de la trace de raisonnement, et il faut séparer les scores d’ajout, de style et de suppression au lieu d’en faire une moyenne. Pour un agent qui agit sur des données ou des outils, mieux vaut vérifier l’action elle-même, comme nous le décrivions dans notre fiche sur le contrôle juste avant l’action et sur la vérification dans les harnais d’agents. Le résultat rejoint celui de notre fiche sur les symboles visuels qui orientent un modèle : ce que le modèle affiche de son raisonnement n’est pas un compte rendu fiable de ce qui le guide.
Le résumé d’Elvis Saravia est fidèle sur les principaux résultats. Trois nuances : la plage de 34 à 41 points correspond à deux modèles seulement, Qwen3-32B et OLMo-3.1-32B-Think, et à la combinaison interdiction et exemples ; le post ne parle pas de la partie sur la surveillabilité, qui est l’autre moitié du papier ; et il ne précise pas que les auteurs ne testent aucune dissimulation délibérée.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.40939
- Le PDF : https://arxiv.org/pdf/2610.40939
- Le code des auteurs : https://github.com/hughvd/CoT-controllability-bottleneck
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2117277307866063107
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/the-first-few-tokens-matter-understanding-chain-of-thought-controllability-2610.40939