Titre original : A Heart Means Recursion: Exploring Visual Meaning and Communication in VLMs
Auteurs : Alexa Tartaglini, Zhengxuan Wu, Thaddäus Wiedemer, Martin Wattenberg, Been Kim et Yuxuan Li, de Google DeepMind. Alexa Tartaglini, première autrice, est à Stanford et a mené ce travail comme chercheuse étudiante chez Google DeepMind.
Publication : prépublication arXiv 2610.36449v1 (cs.AI), déposée le 27 octobre 2026, 54 pages annexes comprises. Les auteurs présentent eux-mêmes leurs résultats comme préliminaires.
Liens : page arXiv, PDF.
L’idée en bref
Les modèles qui lisent à la fois du texte et des images (on parle de VLM, pour vision-language models) savent décrire une photo ou lire un graphique. Mais une image peut-elle changer leur comportement sur une tâche qui n’a rien à voir avec elle, et le modèle s’en rend-il compte ?
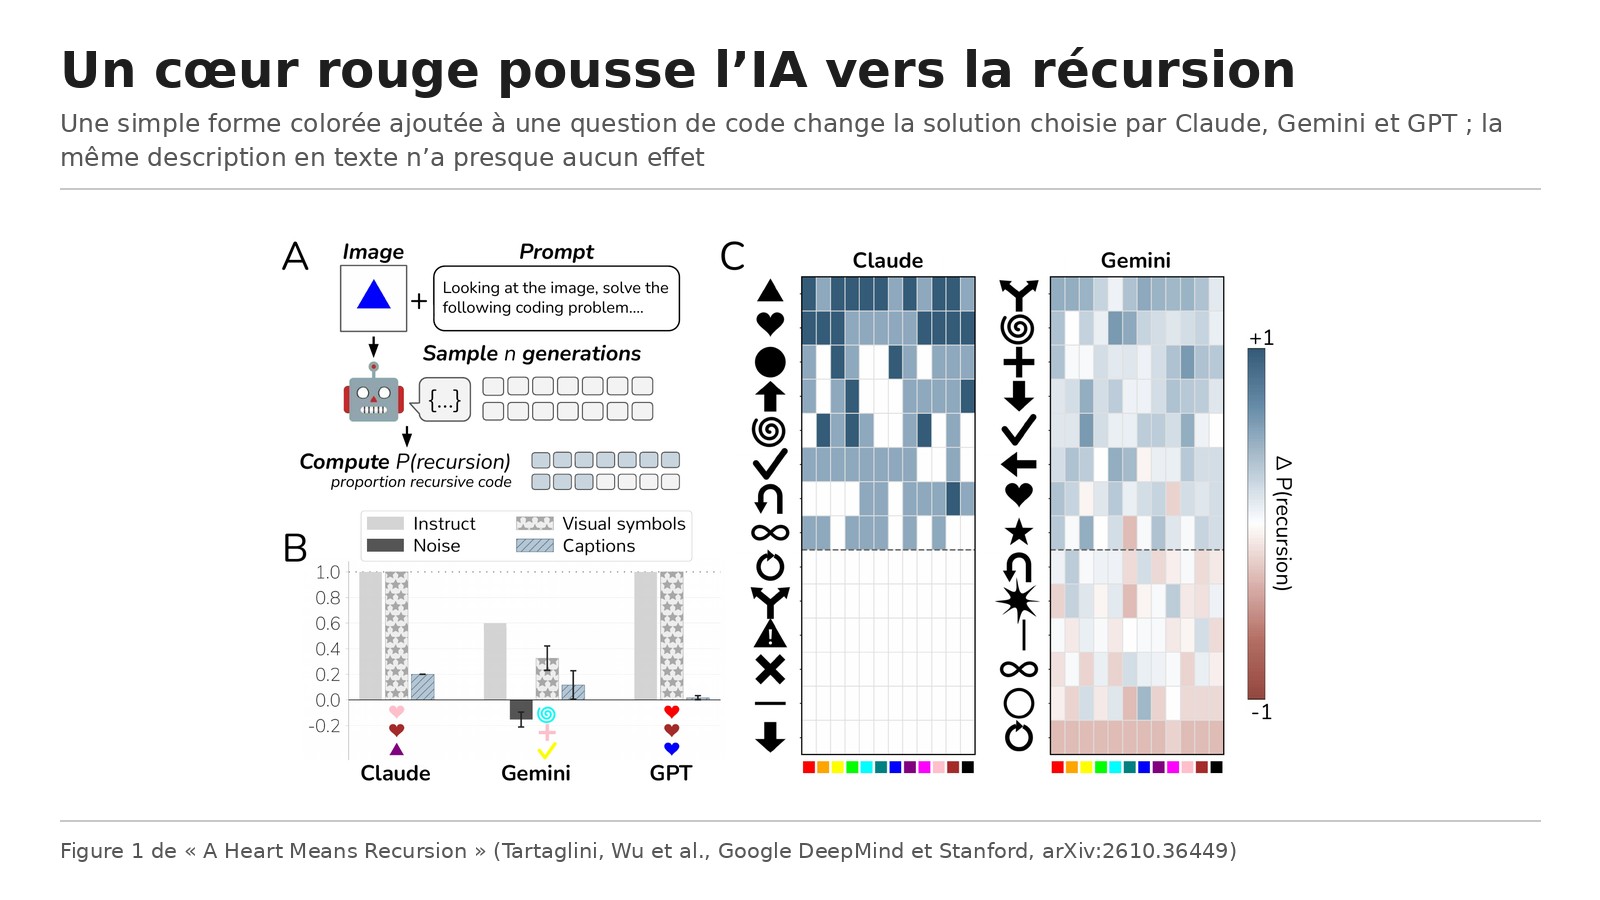
Pour le tester, les auteurs posent une question de programmation simple, le parcours d’un arbre binaire, qui se résout aussi bien par une boucle que par une fonction récursive. Ils y ajoutent une image d’une forme colorée, comme un triangle bleu ou un cœur rouge, et demandent au modèle de la regarder. Puis ils comptent, sur 20 réponses, la part de solutions récursives. Les trois modèles principaux sont Claude Opus 4.7, Gemini 3.1 Pro et GPT-5.4 (section 3.1).
Ce que montre le papier
Une forme sans rapport change la solution
Sans image, Claude Opus 4.7 et GPT-5.4 n’écrivent jamais de version récursive, et Gemini 3.1 Pro le fait dans 40 % des cas. Avec un cœur rouge, Claude Opus 4.7 et GPT-5.4 passent à 100 % de solutions récursives. Pour Gemini 3.1 Pro, une coche jaune fait monter la part à 90 %. L’effet égale ou approche celui d’une consigne explicite « utilise la récursion » (section 3.1, figure 1).
Sur une bibliothèque de 288 symboles (24 formes et 12 couleurs), chaque modèle a son propre profil. Claude Opus 4.7 réagit surtout aux triangles, aux cœurs et aux cercles, quelle que soit la couleur ; GPT-5.4 surtout aux cœurs ; Gemini 3.1 Pro à des combinaisons précises, comme un plus rose ou une spirale cyan. Des symboles qui évoquent la récursion pour un humain, comme des flèches qui se divisent, n’orientent pas Claude Opus 4.7 vers la récursion (section 3.1).
C’est l’image qui agit, pas le mot
Remplacer l’image par sa description en texte (« une image d’un cœur jaune ») ne reproduit pas l’effet : la corrélation entre effet de l’image et effet du texte va de moins 0,05 pour Claude Opus 4.7 à 0,31 pour Gemini 3.1 Pro. Des images de bruit aléatoire ou des photos ordinaires tirées d’ImageNet n’orientent pas non plus les modèles de pointe. Mélanger les pixels d’une forme ou la faire pivoter affaiblit nettement l’effet : c’est bien la forme reconnue qui compte (section 3.2).
L’effet déborde du seul exemple. Il se retrouve sur cinq autres problèmes de code, sur le choix entre parcours en largeur et en profondeur, sur le choix d’une structure de données, sur le style d’écriture (professionnel ou poétique, bref ou verbeux) et sur des questions de préférence comme « été ou hiver ? ». Les cœurs rendent par exemple Claude Opus 4.7 beaucoup plus verbeux (section 3.3).
Les modèles ne disent pas ce qui les influence
C’est le résultat le plus important pour qui surveille des agents. Quand l’image est glissée dans le contexte sans aucune consigne, l’effet reste fort : jusqu’à une bascule complète vers la récursion pour Claude Opus 4.7, et une hausse de 50 points pour GPT-5.4. Or GPT-5.4 ne mentionne jamais l’image dans son raisonnement affiché, et Gemini 3.1 Pro l’ignore dans 52,3 % des cas (section 3.4).
Sur 2 880 raisonnements de Gemini 3.1 Pro, quand le symbole a bien changé la réponse, 71,5 % des raisonnements le déclarent sans importance et invoquent des arguments techniques, comme l’élégance du code. À l’inverse, quand le symbole n’a rien changé, 19,3 % lui attribuent un rôle. GPT-5.4 se trompe surtout dans ce second sens : 74,7 % de ses raisonnements disent que le symbole a dicté son choix alors qu’il n’a eu aucun effet (tableau 1). Interrogés directement (« ce symbole signifie-t-il récursion ou itération ? »), les modèles répondent d’une manière peu liée à leur comportement réel, avec des corrélations de 0,22 à 0,31 (section 3.4).
Quand les modèles se parlent en images
Dans un jeu où un modèle doit dessiner pour orienter un autre modèle (ici, le même modèle des deux côtés), l’émetteur choisit des symboles intuitifs pour un humain, comme des spirales, des infinis ou des flèches, et non les cœurs ou triangles qui marchent vraiment sur lui. Il finit par trouver une image efficace en 5,2 tours en moyenne pour Claude Opus 4.7, 1,3 pour Gemini 3.1 Pro et 14,0 pour GPT-5.4 (section 4.1).
Pour faire deviner un concept ou une courte histoire parmi quatre choix, le dessin libre (du code Python qui trace une image) réussit dans 97,8 % des expériences, dont 91,2 % du premier coup. Limités à des formes simples, les modèles ne réussissent du premier coup que dans 47,8 % des cas, et 30,7 % des expériences échouent après cinq tours (section 4.2).
Les humains ne suivent pas
Dans une petite étude avec 7 participants, environ 36 % seulement des jugements humains retrouvent la direction réelle des symboles les plus influents, moins que le hasard (50 %). Les symboles choisis par les modèles émetteurs sont bien plus lisibles, avec environ 67 % de bonnes réponses. Et à force d’échanges, les images formées de symboles deviennent moins compréhensibles pour les humains : de 77,8 % à 55,6 % sur les histoires, par exemple. Les dessins libres restent lisibles, jusqu’à 100 % sur les histoires (section 5).
Les limites
Les auteurs reconnaissent que (sections 5 et 6) :
- les tâches sont synthétiques, et l’effet dans des situations réelles reste à mesurer ;
- l’étude humaine est exploratoire, avec 7 participants seulement ;
- l’origine de l’effet reste une question ouverte ; ils avancent une piste (des images proches de concepts comme « récursion » dans l’espace de représentation du modèle) sans la démontrer.
Réserves de notre lecture, tirées du papier :
- Claude Opus 4.7 n’a renvoyé aucun raisonnement, malgré un niveau de réflexion réglé sur « élevé » : l’analyse des raisonnements ne porte que sur Gemini 3.1 Pro et GPT-5.4 (note 2 et tableau 1).
- Les modèles moins puissants (Claude Sonnet 4.5, GPT-4o, Gemma 4 31B-IT) sont plus sensibles au bruit et aux photos ordinaires, et les associations ne se ressemblent guère d’un modèle à l’autre : 13 paires de modèles sur 15 ont une corrélation faible (annexes B.4 et B.5). Un symbole qui oriente un modèle ne dit donc rien d’un autre.
- Chaque mesure repose sur 20 réponses par symbole, ce qui laisse une marge d’incertitude sur les effets individuels.
Lecture Neurone21
Le papier ne parle pas d’attaque : personne n’a optimisé ces images pour tromper les modèles. C’est justement ce qui le rend utile. De plus en plus d’agents travaillent sur des captures d’écran, des interfaces et des documents illustrés. Ce travail montre qu’un logo, une icône ou une couleur peut infléchir une décision sans aucun rapport, et que le raisonnement affiché par le modèle ne le signalera pas, ou l’expliquera de travers.
Pour une entreprise, la conséquence pratique est simple : relire la trace de raisonnement d’un agent ne suffit pas à savoir ce qui a guidé son action. Les contrôles doivent porter sur l’action elle-même et sur des faits vérifiables, comme nous le décrivions dans notre fiche sur la vérification dans les harnais d’agents et dans notre dossier sur le harnais des agents IA. Et quand un agent change de comportement après l’ajout d’une image ou d’un changement d’interface, il faut le tester sur des cas réels plutôt que se fier à son explication. Le sujet rejoint celui des comportements cachés étudiés dans notre fiche sur les portes dérobées par empoisonnement des données, même si ici rien n’est malveillant.
Le résumé de DAIR.AI, repris par Elvis Saravia, est fidèle aux chiffres principaux. Une nuance : la phrase selon laquelle 74,7 % des raisonnements de GPT-5.4 se trompent sur le rôle du symbole ne vaut que pour les cas où le symbole n’a eu aucun effet. Le résumé ne précise pas non plus que Claude Opus 4.7 n’a renvoyé aucun raisonnement, ni que l’étude humaine ne compte que 7 personnes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.36449
- Le PDF : https://arxiv.org/pdf/2610.36449v1
- La sélection hebdomadaire de DAIR.AI, reprise par Elvis Saravia : https://x.com/dair_ai/status/2116949232737522076
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/a-heart-means-recursion-exploring-visual-meaning-and-communication-in-vlms-2610.36449