Titre original : Context Language Models
Auteurs : Rulin Shao, Shannon Zejiang Shen, Junjie Oscar Yin, Yuetai Li, Minheng Wang, Hamish Ivison, Radha Poovendran, Nathan Lambert, Teng Xiao, Mike Lewis, Wen-tau Yih, Luke Zettlemoyer, Pang Wei Koh
Affiliations : Université de Washington, Meta Superintelligence Labs, MIT, Trillium Labs.
Publication : déposé sur arXiv le 29 septembre 2026 (version 1), 27 pages.
Liens : page arXiv, PDF, code.
L’idée en bref
Le « contexte » d’un modèle de langage est tout ce qu’il a sous les yeux à un instant donné : consignes, échanges, résultats d’outils. Dans un agent qui travaille longtemps, ce contexte déborde, et c’est en général le logiciel d’encadrement (le « harnais ») qui décide quoi résumer ou supprimer, selon des règles écrites par des humains.
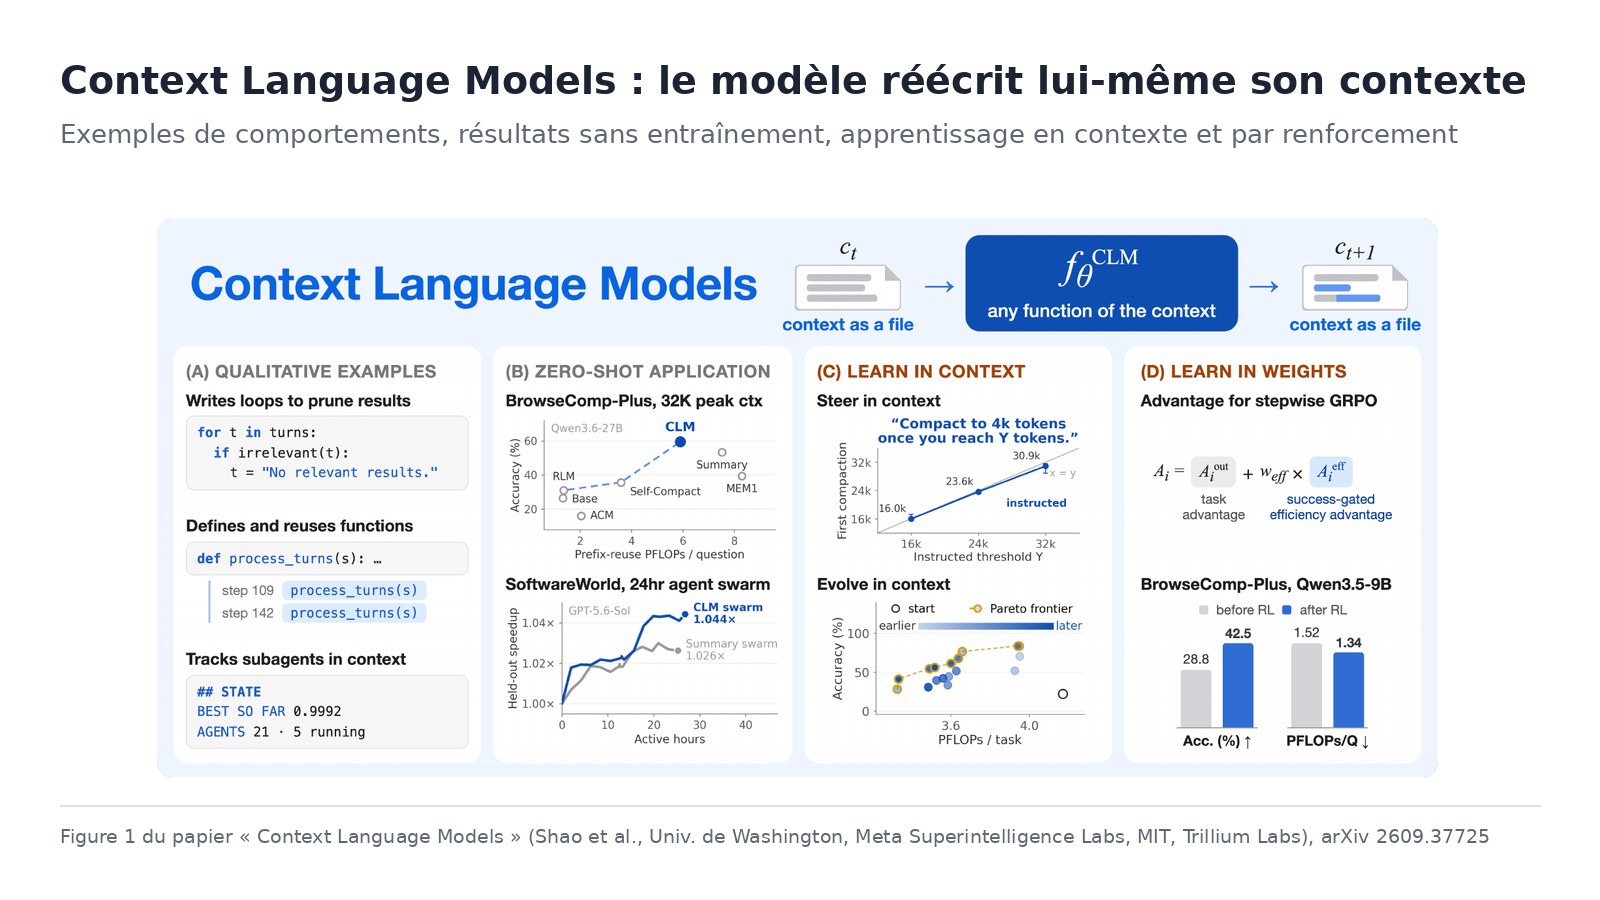
Les auteurs inversent la logique. Leurs Context Language Models (CLM) voient leur contexte comme un fichier qu’ils peuvent modifier librement avec Bash, l’interpréteur de commandes Unix : garder, réécrire, effacer. Chaque modification est répercutée dans le contexte réel au tour suivant. Elvis Saravia souligne la différence avec les « modèles de langage récursifs » (RLM), qui placent une grosse entrée dans une variable externe lisible, sans permettre d’éditer le contexte vivant.
Ce que montre le papier
Sans entraînement. Appliqué tel quel à des modèles existants (Qwen3.6-27B, GPT-5.6 Sol, Claude 4.6 Sonnet), le CLM atteint 59,4 % sur BrowseComp-Plus, un test de recherche documentaire approfondie, avec un contexte limité à 32 000 jetons. C’est 11,4 % de mieux, en valeur relative, que la meilleure méthode de référence (un résumé à la manière de Codex), pour 21,5 % de calcul en moins. Sur un test de programmation en terminal (TerminalBench 2.1), il égale cette référence avec 29,5 % de calcul en moins. Sur EdgeBench, une optimisation logicielle de 12 heures (sous-ensemble de 10 tâches), il fait 5 % de mieux avec 59 % de calcul en moins.
L’essaim de 24 heures. Six agents optimisent ensemble six dépôts de code interdépendants, puis sont évalués sur des paquets non vus. À dépense égale, le CLM obtient une accélération supérieure de 65 % à celle d’un essaim à base de résumés. Précision utile : la figure du papier montre une accélération finale de 1,044 contre 1,026, soit 4,4 % contre 2,6 % de gain. Le « 65 % » porte sur ces gains, pas sur la vitesse elle-même.
Apprendre à gérer son contexte. On peut piloter la stratégie par une simple consigne en langage naturel, ou la faire évoluer via une fiche de savoir-faire réutilisable : jusqu’à 35,9 points de mieux sur ContextBench, un test créé par les auteurs. Par apprentissage par renforcement (le modèle est récompensé quand il réussit, avec un bonus pour l’efficacité), Qwen3.5-9B passe de 28,8 % à 42,5 % sur BrowseComp-Plus, soit les +47,6 % relatifs cités dans le post, avec 12 % de calcul en moins. Mais face à un harnais à résumés entraîné avec la même recette, l’écart n’est que de 0,4 point, avec 38,8 % de calcul en moins.
Le coût côté serveur. Modifier le milieu du contexte casse la mise en cache habituelle, qui ne réutilise que le début inchangé. Les auteurs proposent Suffix Cache Reuse, qui réutilise aussi les états mémorisés de la fin du texte : 35 % de calcul serveur en moins par rapport au moteur SGLang standard, à performance égale. Ces états restent calculés sur l’ancien début : c’est une approximation, validée seulement de manière empirique.
Les limites
- Une nouvelle surface d’attaque, reconnue par les auteurs : un contexte modifiable peut faire persister une injection d’instructions malveillantes ou des consignes que le modèle s’est données lui-même.
- Des gains relatifs souvent modestes en absolu, comme sur l’essaim de 24 heures ou face au harnais entraîné.
- Des tests en partie maison (ContextBench, Software World) et des sous-ensembles de tâches.
- Pas de section dédiée aux limites ; celles-ci sont tirées de la discussion et du protocole.
Lecture Neurone21
C’est une pièce de plus dans le débat entre harnais conçus à la main et compétences apprises par le modèle. Les auteurs parient, dans l’esprit de la « leçon amère » de Rich Sutton, que le modèle trouvera de meilleures stratégies que les règles humaines. Pour les entreprises, l’intérêt immédiat est économique : moins de calcul pour des agents qui travaillent des heures.
Le revers est un sujet de gouvernance : si l’agent réécrit sa propre mémoire de travail, il faut pouvoir auditer ces réécritures. Le code étant publié, ce point peut être examiné de près.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2609.37725
- Le PDF : https://arxiv.org/pdf/2609.37725
- Le code : https://github.com/facebookresearch/context-language-models
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2105690460429996366
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/context-language-models-2609.37725