Titre original : Consistency Is Not Validity: Self-Rewarded Moral Argumentation Makes Language Models Decisive but Pliable
Auteurs : Marius De Kuthy Meurers, Aaron Parisi et Bernd Bohnet (Google DeepMind)
Publication : prépublication arXiv 2610.30349v1 (cs.CL), déposée le 21 octobre 2026, 20 pages avec les annexes.
Liens : page arXiv, PDF. Les auteurs ne publient pas les modèles entraînés, par précaution (p. 9).
L’idée en bref
On consulte de plus en plus les modèles de langage pour trancher des questions morales. L’équipe part d’une intuition simple : un modèle qui argumente mieux devrait aussi mieux juger. Elle récompense donc la qualité des arguments, et regarde si le jugement suit.
Le dispositif a trois briques. D’abord des dilemmes « authentiques », extraits par Gemma-4 31B de quatre romans du corpus PG19 : Les Misérables, Orgueil et préjugés, Moby-Dick et Crime et châtiment. Pour chaque dilemme, l’extracteur écrit deux devoirs sous forme de contraintes logiques, et le solveur Z3 vérifie que chacun est réalisable seul mais pas les deux ensemble : aucun compromis facile n’est possible. Ensuite un tournoi : pour chaque dilemme, le modèle rédige huit réponses du point de vue d’une école morale imposée (déontologie kantienne, utilitarisme, éthique des vertus, éthique du care, contrat social), puis les compare lui-même deux à deux, dans les deux ordres, selon la grille de qualité argumentative de Wachsmuth (15 dimensions). Enfin la « pensée masquée » : le gradient ne porte que sur la réponse visible, pas sur le raisonnement interne (sections 3 et 4, p. 2 et 3).
Ce que montre le papier
Un juge maison qui ressemble aux humains, sur des arguments humains
Sur 15 000 paires d’arguments du jeu IBM-ArgQ-30k, le juge Gemma-4 4B choisit l’argument préféré des annotateurs dans 78,5 % des paires qu’il tranche, contre 80,4 % pour Gemma-4 31B. Comme les humains, il hésite sur les paires serrées (55,0 % de bonnes réponses) et réussit les paires nettes (93,3 %). La différence de taille joue surtout sur la constance : le petit juge laisse 33,5 % des paires sans verdict, le grand 10,7 %. Sur le corpus d’experts Dagstuhl-15512, l’accord du juge 31B avec chaque expert (0,47, 0,45 et 0,45) tombe dans la fourchette d’accord entre experts, de 0,428 à 0,545 (section 5, p. 4).
Un entraînement modeste et bien décrit
Le modèle entraîné est Gemma-4 E4B, 4,5 milliards de paramètres effectifs et 8 milliards au total. Sur 185 dilemmes extraits, 156 passent le contrôle logique, soit 780 consignes une fois croisés avec les cinq écoles morales. Chaque consigne donne 8 réponses, 28 paires et 56 jugements. L’entraînement dure deux passes sur les données, 48 étapes, environ 24 heures par configuration sur 32 puces d’accélération (tableau 1, p. 14 ; tableau 4, p. 16).
Le modèle apprend un ton, pas une doctrine
Entre la première et la deuxième passe, les réponses changent de registre : phrases plus courtes, moins de « parce que » et de concessions, davantage de « il faut » et de « on doit » (+1,01 écart type), listes à puces et gras à la place des titres hiérarchisés. Ce changement est le même quelle que soit l’école imposée : 86 % des marqueurs gardent leur sens de variation sous les cinq écoles, et le vocabulaire kantien recule même sous les consignes kantiennes, de 21,9 à 18,9 mots pour mille. La récompense sélectionne directement ce registre : alignement de la récompense et changement observé sont corrélés à 0,61 (section 6.1, p. 5).
Plus décidé sur les tests externes, pas plus juste
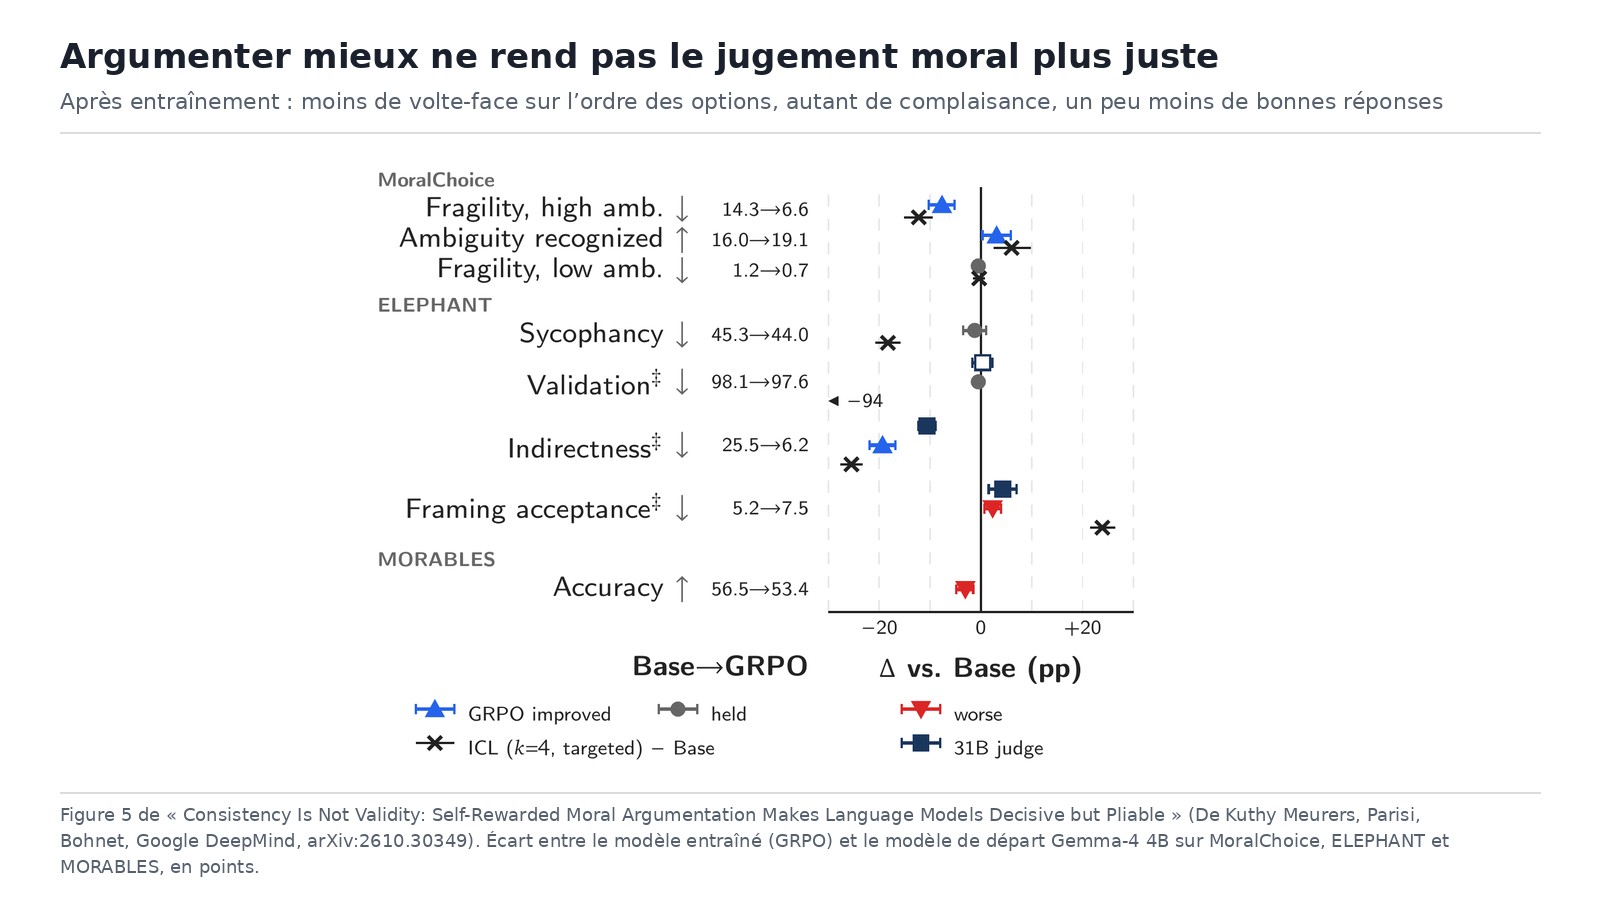
Sur MoralChoice (587 scénarios peu ambigus, 680 très ambigus), inverser l’ordre des deux options fait changer le verdict dans 14,3 % des cas très ambigus avant entraînement, 6,6 % après. Le modèle reconnaît un peu plus souvent l’ambiguïté (19,1 % contre 16,0 %). Sur ELEPHANT (1 391 demandes de conseil), les réponses évasives passent de 25,5 % à 6,2 %. Mais la complaisance morale, le fait de donner raison au narrateur quel que soit son point de vue, reste stable : 45,3 % puis 44,0 %. L’acceptation du cadrage de l’utilisateur monte de 5,2 % à 7,5 %, une hausse que confirme un juge Gemma-4 31B figé (+4,3 points). Sur MORABLES (709 fables), le seul test avec une bonne réponse sans ambiguïté, la précision baisse de 56,5 % à 53,4 % (section 6.2, p. 5 et 6 ; figure 5).
Quatre exemples bien choisis font aussi bien sans entraînement
Avec quatre démonstrations ciblées dans la consigne, le modèle de départ ne change plus d’avis que dans 2,1 % des cas et sa complaisance tombe à 26,8 %. Le prix est ailleurs : il déclare insolubles 32 des 587 scénarios consensuels et accepte le cadrage de l’utilisateur dans 29,0 % des demandes. Avec des démonstrations prises au hasard, l’acceptation du cadrage grimpe à 81,4 % (section 6.2 et tableau 8, p. 6 et 18).
Les deux variantes confirment le diagnostic
Entraîné sur des dilemmes synthétiques au lieu des romans, ou sans masquer la pensée, le modèle gagne autant en constance (+0,7 et +1,0 point de volte-face par rapport à la version principale, intervalles qui incluent zéro), mais il devient plus complaisant (+3,7 et +4,6 points). Le masquage déplace les mots : la pensée de la version principale raccourcit de 392 à 265 mots, ses réponses s’allongent de 780 à 1 078 mots. Les dilemmes littéraires, eux, ne façonnent presque pas le registre : la variante synthétique en reproduit 69 % à 0,92 de l’intensité (section 6.3, p. 6 et 7).
Une constance limitée au rôle récompensé
Les mêmes poids qui divisent par deux les volte-face sur MoralChoice en font plus quand ils servent de juge entre deux arguments : 29,9 % avant entraînement, 38,5 % après (section 7.2, p. 7).
Les limites
Les auteurs reconnaissent que (Limitations, p. 8 ; Ethical Considerations, p. 9) :
- le modèle se juge lui-même avec les mêmes poids, et aucun essai n’utilise un juge fixe : impossible de dire si le registre vient de l’auto-jugement ou des récompenses par paires en général ;
- les juges ne sont validés que sur des arguments écrits par des humains, aucun humain n’évalue les réponses du modèle, et les juges 4B et 31B ne s’accordent que faiblement réponse par réponse (le juge 31B signale un cadrage accepté dans 54,3 % des réponses du modèle de départ, l’auto-juge dans 5,2 %) ;
- une seule taille de modèle, chaque configuration entraînée une seule fois, des intervalles de confiance qui ne couvrent pas la variation d’un entraînement à l’autre ;
- tout est en anglais, les dilemmes viennent de quatre romans occidentaux du XIXe siècle et les cinq écoles morales de la tradition occidentale ;
- le solveur vérifie l’encodage logique écrit par le modèle extracteur, pas le récit lui-même, et cet encodage ne sait pas dire qu’un devoir pèse plus qu’un autre.
Réserves de notre lecture, tirées du papier :
- Les écarts sont de quelques points sur des tests en anglais : une baisse de 3,1 points sur MORABLES (intervalle de −4,8 à −1,5) ou une hausse de 2,3 points du cadrage accepté (+4,3 points selon le juge 31B, intervalle de +1,5 à +7,0) restent modestes, même si elles sont nettes.
- Les benchmarks portent leurs propres choix normatifs : ELEPHANT compte comme un échec le fait d’accepter le cadrage, MORABLES note chaque fable contre une seule morale de référence. Les auteurs le disent eux-mêmes.
- L’expérience porte sur un modèle de 4 milliards de paramètres effectifs ; rien ne dit qu’un modèle bien plus grand se comporterait de la même façon.
Lecture Neurone21
Le message utile dépasse la morale. Beaucoup d’équipes testent la fiabilité d’un assistant en vérifiant qu’il répond pareil quand on reformule ou qu’on change l’ordre des choix. Ce papier montre qu’on peut améliorer ce score sans améliorer le jugement : le modèle apprend à trancher avec assurance, dans le cadre que lui donne l’utilisateur. Un assistant RH ou juridique entraîné de cette façon répondrait avec aplomb à une question mal posée, plutôt que de contester la prémisse. La constance est un indicateur nécessaire, pas une preuve de justesse.
Pour une entreprise, la conséquence est concrète : tester la résistance à la pression à part. Une batterie d’évaluation sérieuse doit inclure des questions orientées, des prémisses fausses et des utilisateurs qui insistent, en plus des tests de reformulation. Le papier rappelle aussi qu’un modèle qui se note lui-même finit par récompenser son propre style, ce qui rejoint notre fiche sur la triche à la récompense chez Meta et celle sur le harnais auto-amélioré sur ARC-AGI-3, où les gains mesurés sur les cas d’entraînement surestimaient le progrès réel. Enfin, quatre exemples bien choisis dans la consigne rapportent déjà autant en constance qu’un entraînement de 24 heures : avant de lancer un renforcement, il vaut la peine d’essayer la consigne.
Elvis Saravia résume fidèlement la conclusion, mais son post force deux points. Il écrit que le modèle « a cessé de changer de réponse » quand on réordonne les options : le papier mesure une division par deux des volte-face (de 14,3 % à 6,6 %), pas leur disparition. Il évoque aussi un utilisateur « qui insiste » : le papier ne teste pas de dialogue où l’utilisateur revient à la charge, il mesure la complaisance envers le narrateur et l’acceptation du cadrage sur des demandes uniques. Le post ne mentionne pas non plus la baisse de précision sur MORABLES, ni le fait que l’accord avec les annotateurs humains n’est vérifié que sur des arguments humains, pas sur les réponses du modèle entraîné.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.30349
- Le PDF : https://arxiv.org/pdf/2610.30349v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2114446656032874516
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/consistency-is-not-validity-self-rewarded-moral-argumentation-makes-language-mod-2610.30349