Titre original : Route to Remember: Adaptive Memory Selection for LLM Agents
Auteurs : Zeyu Fang, Jun Yin, Yongsheng Mei, Xu Han, Chaitali Joshi, Zhongkai Sun, Jie Hao, Bin Guo, Chengyuan Ma, Benjamin Yao et Chenlei Guo.
Affiliations : George Washington University, Amazon.
Publication : prépublication arXiv 2611.05636v1 (cs.AI), déposée le 3 novembre 2026, 18 pages ; papier d’atelier NeurIPS 2026 (mémoire personnalisée et long terme).
Liens : page arXiv, PDF. Aucun dépôt de code n’est annoncé dans le papier.
L’idée en bref
La mémoire des agents en production est presque toujours du texte : on extrait des points clés des conversations, on les stocke, puis on les réinjecte dans le contexte à chaque question. Chaque requête paie donc une lecture qui grossit avec l’historique. L’autre voie consiste à inscrire les faits dans les poids du modèle, qui répond alors sans aucun contexte. Les premières tentatives décevaient, surtout parce qu’elles utilisaient un fine-tuning supervisé classique.
Les auteurs utilisent l’autodistillation on-policy (OPSD). Un « enseignant », le même modèle qui lit la mémoire de l’utilisateur dans son contexte, entraîne un « élève », un adaptateur LoRA propre à l’utilisateur, qui doit donner la même réponse sans ce contexte. Un routeur « vérifier puis régénérer » (VtR) contrôle ensuite la réponse de l’élève contre la mémoire texte et ne la refait avec les preuves récupérées qu’en cas de conflit.
Ce que montre le papier
Le choix de l’objectif d’entraînement fait la différence
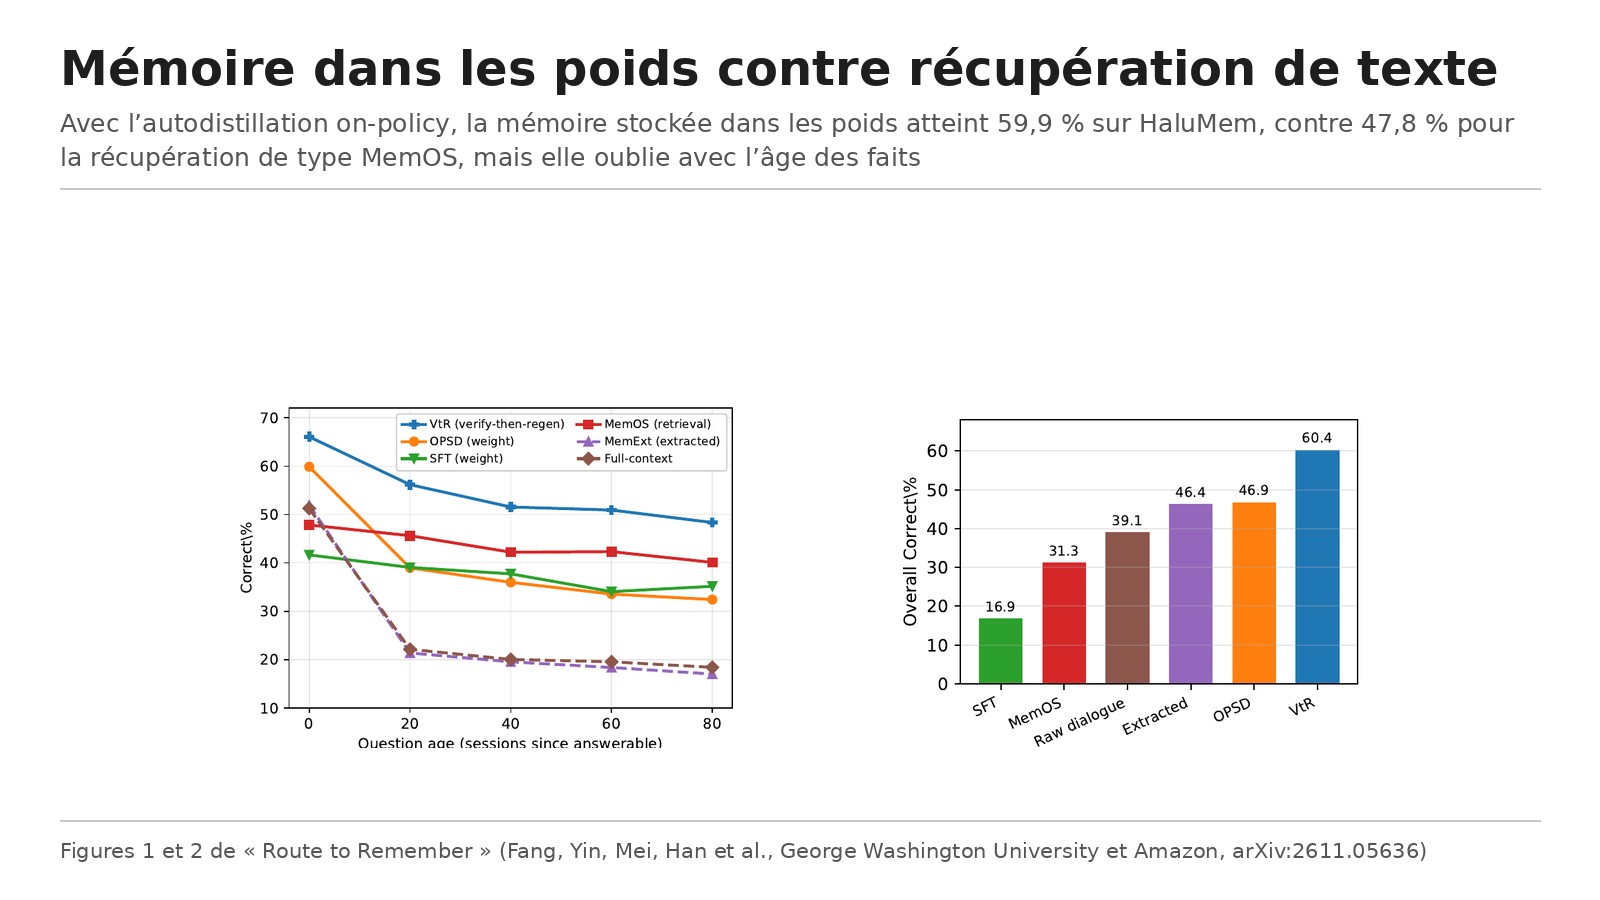
Sur les 1 438 questions natives de HaluMem pour huit utilisateurs HaluMem-Long, avec Qwen3.5-9B, OPSD atteint 59,9 % de bonnes réponses. La récupération de type MemOS fait 47,8 %, la mémoire extraite placée en entier dans le contexte 51,9 %, le dialogue brut 51,3 %. Un fine-tuning supervisé sur exactement les mêmes données ne fait que 36,9 %, sous toutes les bases texte. L’écart avec la récupération est de 12,1 points, positif pour chacun des huit utilisateurs (de 7,1 à 18,1 points), et l’avantage tient à 4B et 27B. Le juge est Claude Sonnet 4.6, sans note partielle.
Cher à écrire, presque gratuit à lire
La mémoire dans les poids reporte le coût sur l’écriture : extraction, augmentation en questions-réponses, passe de distillation. Ensuite, chaque requête ne lit que la question. Face au contexte complet, le surcoût d’écriture d’environ 150 millions de jetons est remboursé après à peu près 600 requêtes par mémoire stockée. Face à la récupération, déjà économe en lecture, le point d’équilibre est de l’ordre de 100 000 requêtes.
Elle oublie et ne sait pas dire « je ne sais pas »
La précision d’OPSD baisse avec l’âge du fait : de 59,9 % à 32,4 % quand la question porte sur une session vieille de 80 sessions. La récupération reste presque stable (de 47,8 % à 40,1 %) et repasse devant au-delà d’une vingtaine de sessions. Sur la catégorie « limite de la mémoire », où la bonne réponse est de s’abstenir, OPSD fait 81,7 % contre 89,1 % pour MemOS : le modèle invente au lieu de dire que l’information n’a jamais été donnée. Le routeur VtR ajoute 6,2 points (66,1 % au total) et améliore cinq catégories sur six, mais baisse sur les conflits de mémoire. Le classement se reproduit sur LoCoMo (60,4 % pour VtR, 46,9 % pour OPSD).
Les limites
- Huit utilisateurs seulement dans l’évaluation principale, même si chaque comparaison est donnée utilisateur par utilisateur ;
- un adaptateur par utilisateur et une passe d’entraînement à chaque écriture de mémoire, dont le coût GPU n’est pas facturé en jetons dans le tableau ;
- oubli des faits anciens et confabulation sur les faits absents, reconnus par les auteurs ;
- juge automatique unique sans note partielle, ce qui pénalise les réponses courtes ;
- papier d’atelier, sans code publié.
Lecture Neurone21
Le message pratique est une architecture hybride. Les connaissances stables et partagées par beaucoup d’utilisateurs vont dans les poids ; les faits récents et ceux qu’on n’a jamais reçus restent dans une mémoire texte ; et on vérifie la réponse plutôt que d’essayer de deviner à l’avance quelle mémoire utiliser. Les auteurs le disent eux-mêmes : la mémoire dans les poids rapporte surtout quand le même savoir est interrogé des milliers de fois.
Pour une PME, ce n’est pas encore un produit sur étagère. Mais pour un assistant interne interrogé tous les jours sur les mêmes procédures, distiller ces procédures dans un petit adaptateur tout en gardant un journal texte pour le reste est une piste sérieuse à tester.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 6 novembre 2026 (14:43 UTC, 15:43 heure de Paris), puis l’a republié le 7 novembre. Nous avons lu la version officielle arXiv 2611.05636v1. Écarts avec le post :
Le post présente un travail « d’Amazon » : il est cosigné par la George Washington University, dont vient l’auteur principal. Le post ne dit pas que les résultats principaux reposent sur huit utilisateurs ni que la récupération reprend l’avantage sur les faits de plus d’une vingtaine de sessions. Les chiffres cités (36,9 %, 59,9 %, 47,8 %, 51,9 %, 51,3 %, 6,2 points, tailles 4B, 9B et 27B) correspondent au papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.05636
- Le PDF : https://arxiv.org/pdf/2611.05636
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2118715786152001580
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/route-to-remember-adaptive-memory-selection-for-llm-agents-2611.05636