Titre original : EmbeddingGemma 2: Unified and Efficient Multimodal Representations
Auteurs : EmbeddingGemma Team, Google. Henrique Schechter Vera et Sahil Dua sont co-premiers auteurs, parmi plusieurs dizaines de contributeurs de Google ; Henrique Schechter Vera est l’auteur correspondant.
Publication : rapport technique déposé sur arXiv sous la référence 2610.37364v1 (cs.LG) le 27 octobre 2026, 28 pages avec les annexes.
Liens : page arXiv, PDF, documentation du modèle.
L’idée en bref
Un modèle d’embeddings transforme un contenu en vecteur de nombres, de sorte que deux contenus proches par le sens aient des vecteurs proches. C’est la brique de base de la recherche documentaire et du RAG. Jusqu’ici, pour chercher dans des images, des vidéos ou des enregistrements, il fallait souvent passer par une transcription ou une description textuelle, avec un coût de calcul et une perte d’information.
EmbeddingGemma 2 place directement texte, images, vidéo, audio et leurs combinaisons dans un même espace. Nous avions couvert l’annonce du modèle dans une actualité ; le rapport technique détaille désormais l’architecture, l’entraînement et les résultats chiffrés.
Ce que montre le rapport
Un modèle modulaire de 744 millions de paramètres
Le modèle compte 744 millions de paramètres : un tronc transformeur bidirectionnel de 271 millions (couche d’entrée comprise), un encodeur visuel de 167 millions et un encodeur audio de 305 millions. Les encodeurs se chargent séparément : 271 millions de paramètres suffisent pour le texte seul, 439 millions pour le texte et l’image, 577 millions pour le texte et l’audio. Le modèle reprend l’architecture et les poids de la famille Gemma 4 et apprend du modèle Gemini Embedding 2, plus grand (section 1). Il accepte des séquences jusqu’à 8 192 jetons à l’entraînement, produit des vecteurs de 768 dimensions que l’on peut tronquer à 512, 256 ou 128, et existe en versions quantifiées sur 4 bits (section 2).
Un entraînement en trois étapes
L’entraînement voit environ 2 900 milliards de jetons : environ 300 milliards en préparation sur le texte seul, environ 2 000 milliards en préparation multimodale, puis environ 600 milliards en affinage multimodal. Les auteurs séparent le texte des autres modalités, et la distillation depuis Gemini Embedding 2 de l’apprentissage contrastif, pour construire progressivement l’espace commun (section 2.4).
Les résultats chiffrés
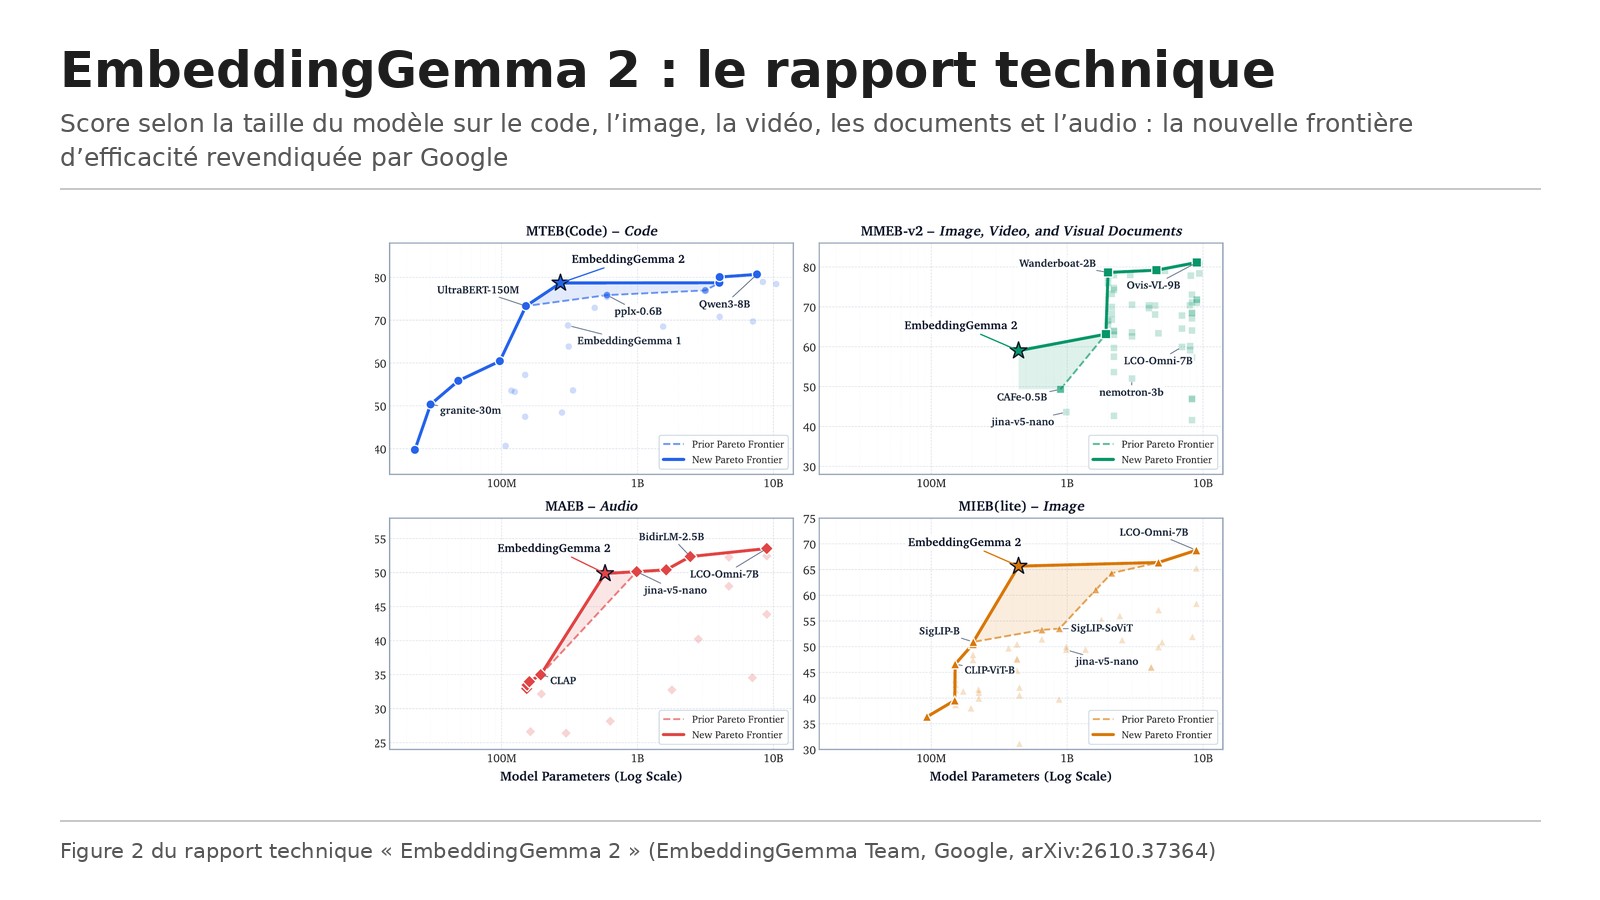
Sur le code, le résultat est net : 78,68 sur MTEB(Code), contre 68,76 pour la première version. Le modèle dépasse tous les modèles de moins de 4 milliards de paramètres du classement et se place à moins de 2 points du premier, 28 fois plus gros (section 4.2 et tableau 7).
Sur le texte, le gain est faible en multilingue (61,36 sur MTEB multilingue, contre 61,15 pour la première version) et il y a un recul en anglais (68,46 contre 69,67). Les auteurs le reconnaissent : deux modèles plus petits le dépassent en multilingue et un en anglais, tous spécialisés dans le texte (section 4.2 et annexe B).
Sur l’image, la vidéo et les documents, il obtient 59,0 sur MMEB-v2 (le plus petit modèle de ce classement) et 60,17 sur MIEB(lite), au-dessus des modèles de moins d’un milliard de paramètres. Des modèles de 2 milliards de paramètres et plus restent nettement devant sur MMEB-v2 (figure 2 et tableaux 6, 8 et 9).
Sur l’audio, il obtient 49,9 sur MAEB, juste derrière jina-embeddings-v5-omni-nano (50,1, 986 millions de paramètres). Sur la recherche de passages à partir de questions parlées (MSEB), l’audio natif atteint 69,54, contre 57,59 en passant par une transcription automatique, et 50,95 pour la première version avec transcription (tableaux 10 et 11).
Pensé pour tourner sur l’appareil
Sur un Google Pixel 11 Pro, la mémoire utilisée en inférence descend à 191 Mo pour le texte seul, 447 Mo pour le texte et l’image, et 567 Mo pour l’ensemble. La quantification sur 4 bits coûte peu sur le texte (60,96 contre 61,36 en multilingue), un peu plus sur le code (76,85 contre 78,68) et davantage sur l’image (56,59 contre 60,17 sur MIEB(lite)) (section 2.4 et tableau 1).
Quelques choix validés par les ablations
Entraîner l’encodeur visuel avec le reste du modèle plutôt que le figer fait passer le score MMEB-v2 de 48,18 à 52,27 (section 3.3 et tableau 4). Simplifier les embeddings par couche hérités de Gemma, sans table de correspondance dédiée, réduit le coût et améliore légèrement le score (55,46 contre 55,07, section 3.1 et tableau 2).
Les limites
Le rapport ne contient pas de section consacrée aux limites. La partie « Future Work » (section 5) indique que la longueur de contexte pourrait être étendue pour indexer des médias longs, et que de nouveaux cadres d’évaluation seront nécessaires pour la recherche multimodale mélangée.
Réserves de notre lecture, tirées du rapport :
- La « nouvelle frontière de Pareto » signifie le meilleur score pour une taille donnée, pas la première place : des modèles plus gros restent devant sur MMEB-v2, MAEB et le texte.
- Le recul en anglais face à la première version est réel (68,46 contre 69,67), même si le rapport le qualifie de modeste.
- Les comparaisons utilisent le nombre de paramètres réellement chargés pour chaque modalité (271, 439 ou 577 millions), ce qui est cohérent avec l’usage modulaire mais avantage le modèle face à des concurrents comptés en entier.
- Les ablations sont menées sur des versions intermédiaires du modèle, et les scores des concurrents viennent en grande partie des classements publics.
Lecture Neurone21
Pour une entreprise, l’intérêt est concret : un seul modèle ouvert, assez petit pour tourner sur un poste ou un serveur modeste, permet d’indexer dans le même moteur des documents, des photos de chantier, des captures d’écran, des vidéos de formation ou des messages vocaux, sans passer par une transcription. C’est exactement le type de brique utile pour une IA locale qui ne fait sortir aucune donnée de l’entreprise.
Il faut néanmoins tester sur ses propres données avant de remplacer un modèle texte qui fonctionne : sur l’anglais, la première version reste légèrement meilleure, et des modèles texte spécialisés font mieux. Le modèle prend tout son sens lorsque les contenus sont réellement mélangés, ou pour la recherche dans du code.
Le post de DAIR.AI repartagé par Elvis Saravia annonce un modèle qui bat les modèles spécialisés et des modèles 2 à 12 fois plus gros sur sept bancs d’essai. C’est la formule du résumé du rapport, mais elle est plus forte que les tableaux : le modèle est le meilleur pour sa taille, pas premier partout. Il recule en anglais face à la première version, et il est devancé sur MAEB et MMEB-v2 par des modèles plus gros. Le chiffre de 744 millions de paramètres est celui du rapport ; la page du modèle chez Google indique 740 millions.
Pour aller plus loin
- Le rapport sur arXiv : https://arxiv.org/abs/2610.37364
- Le PDF : https://arxiv.org/pdf/2610.37364v1
- Le post de DAIR.AI repartagé par Elvis Saravia : https://x.com/dair_ai/status/2115439702572716129
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/embeddinggemma-2-unified-and-efficient-multimodal-representations-2610.37364
- La documentation du modèle : https://ai.google.dev/gemma/docs/embeddinggemma