Titre original : How Depth Growth and Looping Shape In-Context Learning in Language Models
Auteurs : Ferdinand Kapl (Technical University of Munich, Helmholtz AI Munich, Munich Center for Machine Learning), Kaitlin Maile (Google, Paradigms of Intelligence Team), Stefan Bauer (Technical University of Munich, Helmholtz AI Munich, Munich Center for Machine Learning) et Johannes von Oswald (Google, Paradigms of Intelligence Team). Les trois derniers ont encadré le travail à parts égales.
Publication : prépublication arXiv 2610.31421v1 (cs.CL), déposée le 22 octobre 2026, 38 pages avec les annexes. Calculs réalisés notamment sur le supercalculateur JUPITER de Jülich.
Liens : page arXiv, PDF
L’idée en bref
Deux façons d’obtenir un modèle profond sans payer le plein tarif sont à la mode. La première fait grandir le réseau : on entraîne d’abord quelques couches, puis on les duplique par blocs au fil de l’entraînement (méthode LIDAS). La seconde fait tourner en boucle un même bloc de couches, ce qui donne la profondeur d’un grand modèle avec moins de paramètres. On savait que ces deux familles raisonnent plutôt bien. Les auteurs posent une autre question : se servent-elles différemment du contexte, c’est-à-dire des exemples et du texte fournis dans la consigne ?
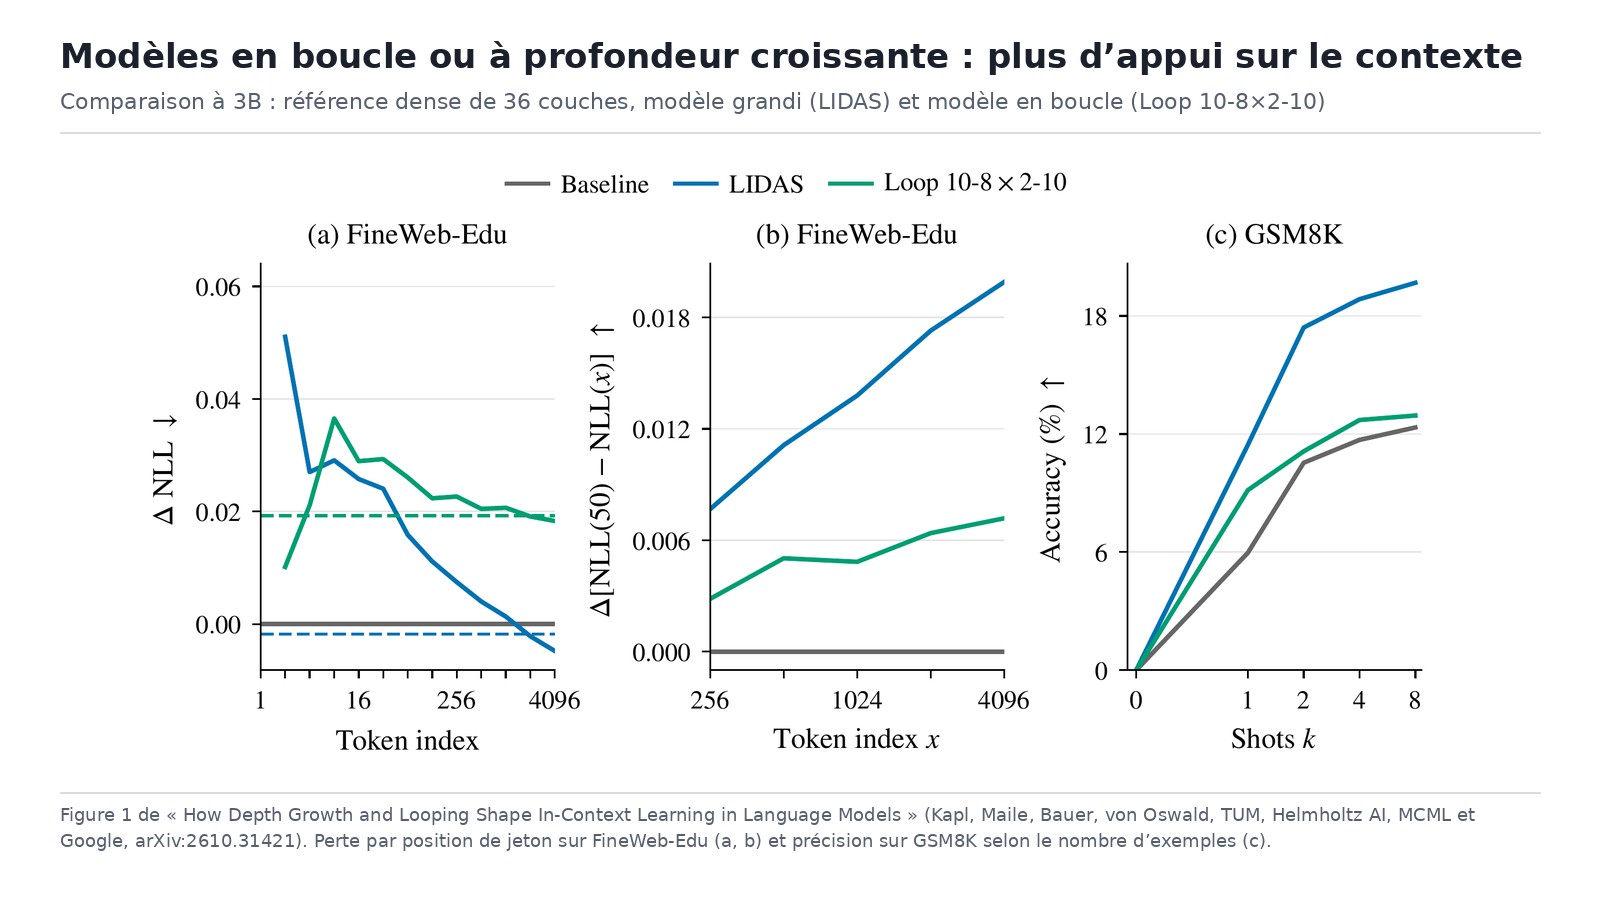
La comparaison principale porte sur trois modèles de 3 milliards de paramètres : une référence dense de 36 couches (configuration SmolLM3), un modèle LIDAS qui part de 4 couches et grandit par blocs de 4 jusqu’à 36, et un modèle en boucle « Loop 10-8×2-10 » qui applique 36 couches dont 28 uniques, soit environ 2,45 milliards de paramètres. Les trois voient les mêmes 100 milliards de jetons dans le même ordre, avec le même nombre d’étapes et le même coût de calcul final à l’inférence. La croissance économise environ 26 % du calcul d’entraînement à 3B, 22 % à 360M et 1,7B (section 3.1, p. 3 et 4 ; annexe A).
Ce que montre le papier
Moins bons au début du texte, meilleurs ensuite
Mesurée position par position sur 10 000 documents FineWeb-Edu, la perte des deux variantes est plus élevée que celle de la référence sur les premiers jetons, puis baisse davantage quand le contexte s’allonge. Le modèle LIDAS rejoint la référence vers la position 1 000 et fait mieux ensuite, y compris en moyenne sur tout le texte. Le modèle en boucle gagne aussi plus avec le contexte, mais sa perte reste au-dessus de celle de la référence jusqu’au bout (section 3.2 et figure 1, p. 4).
Un avantage net sur GSM8K avec exemples
Sur les problèmes de mathématiques de GSM8K, avec de 0 à 8 exemples dans la consigne, les deux variantes dépassent la référence. Le modèle grandi creuse l’écart à mesure qu’on ajoute des exemples et finit, selon le texte, « autour de +7 % » au-dessus de la référence : sur la figure, environ 20 % de bonnes réponses à huit exemples contre environ 12 %. Le modèle en boucle garde un avantage, mais la référence le rattrape presque à huit exemples (section 3.2, p. 4 ; figure 8, p. 19).
Des scores généraux proches
Sur la moyenne de neuf tests à choix multiples à 3B, LIDAS obtient 62,89, la référence 61,33 et le modèle en boucle 60,53. Sur MMLU, les trois sont serrés : 39,28, 39,15 et 38,32 (tableau 2, p. 16). L’avantage tient donc surtout à l’usage du contexte, pas à un niveau général plus élevé.
Des langues formelles inconnues apprises plus vite, sur de petits modèles
Sur RegBench, où il faut deviner les règles d’une langue artificielle jamais vue à partir de quelques chaînes, des modèles de 12 couches grandis ou en boucle prédisent mieux les symboles légaux que le modèle dense. L’avantage culmine vers la quatrième chaîne et apparaît dès la première, après une quinzaine de symboles. Attention : le modèle en boucle ne compte que 2 couches uniques et il est deux fois plus large (256 contre 128) ; la comparaison égalise les données et les étapes, pas la largeur ni le calcul (section 3.3, p. 5 ; annexe C, p. 23 et 24).
Plus de contexte, moins de mémoire dans les poids
Sur des images de caractères Omniglot, où un modèle peut soit lire les exemples du contexte, soit mémoriser les étiquettes, les modèles grandis et en boucle gardent davantage la capacité de lire le contexte, mais apprennent moins bien ce qui doit être stocké dans les poids que le modèle dense de 12 couches (quatre entraînements par configuration, 40 millions d’étapes). Le modèle grandi ressemble à son modèle de départ de 4 couches ; le modèle en boucle paie le plus cher côté mémoire. Quand seule la lecture du contexte permet de réussir, elle apparaît plus tôt chez le modèle en boucle, le modèle grandi et le modèle dense de 4 couches que chez le modèle dense de 12 couches, et les quatre atteignent presque 100 % à un million d’étapes (section 3.4 et figure 3, p. 6).
Des têtes d’induction héritées de quelques ancêtres
Le mécanisme passe par les têtes d’induction, ces têtes d’attention qui repèrent une séquence déjà vue pour prédire la suite. Dans le modèle LIDAS, les 12 têtes d’induction les plus fortes en fin d’entraînement descendent de seulement 4 têtes du modèle initial de 4 couches, et deux d’entre elles, L2H9 et L2H10, en fournissent 10 sur 12. Les têtes fortes se répètent à la même position toutes les quatre couches ; dans le modèle en boucle, elles se répètent d’un passage à l’autre du bloc de 8 couches. Rien de tel dans la référence dense. Les têtes qui encodent la tâche à accomplir (têtes « function vector ») suivent le même schéma : deux ancêtres en donnent 6 sur 12 (section 4.1 et figure 5, p. 7 et 8).
Une dépendance mesurée par ablation
En neutralisant de 1 % à 20 % des têtes, les auteurs montrent que retirer les têtes d’induction pénalise davantage les modèles grandis et en boucle que la référence, sur 19 tâches à exemples comme sur la prédiction des derniers jetons. Les têtes « function vector » restent toutefois les plus importantes pour les tâches à exemples dans les trois modèles (section 4.2 et figure 6, p. 8 et 9).
Les limites
Le papier n’a pas de section dédiée aux limites, mais il signale lui-même plusieurs réserves dans le texte et les annexes :
- chaque modèle de langage n’est entraîné qu’une fois, et les bandes d’erreur ne mesurent pas la variation d’un entraînement à l’autre (annexe A, p. 15) ;
- il n’y a pas de modèle MIDAS à 3B, seulement LIDAS ;
- sur RegBench, les modèles ont les mêmes données et les mêmes étapes, mais pas la même largeur ni le même calcul ;
- les sondes qui mesurent les têtes d’induction et les vecteurs de tâche sont descriptives : des scores élevés et des positions répétées ne prouvent pas à eux seuls une causalité, d’où les ablations.
Réserves de notre lecture, tirées du papier :
- Les scores absolus sur GSM8K restent faibles, autour de 20 % au mieux : ce sont des modèles de recherche entraînés sur 100 milliards de jetons, pas des assistants prêts à l’emploi.
- Le modèle en boucle a une perte plus élevée que la référence sur l’ensemble du texte et un MMLU un peu plus bas : son meilleur usage du contexte ne compense pas tout.
- L’étude s’arrête à 3 milliards de paramètres ; rien ne garantit que l’écart tienne pour des modèles dix ou cent fois plus grands.
Lecture Neurone21
Ce papier intéresse quiconque choisit un petit modèle à déployer en local. Les architectures en boucle reviennent en force parce qu’elles offrent la profondeur d’un gros modèle avec moins de paramètres, donc moins de mémoire. Le résultat dit que ce choix n’est pas neutre : ces modèles s’appuient davantage sur ce qu’on leur donne dans la consigne et moins sur ce qu’ils ont mémorisé. Pour un assistant interne nourri de documents de l’entreprise, c’est plutôt une bonne nouvelle. Pour un usage qui repose sur des connaissances générales sans contexte, c’est un handicap à tester.
En pratique, cela renforce une méthode simple : évaluer un modèle avec et sans exemples dans la consigne, et sur des documents longs, avant de le retenir. Deux modèles proches sur MMLU peuvent diverger nettement dès qu’on leur fournit huit exemples. Cela rejoint notre fiche sur la mémoire des agents, où relire l’historique brut suffisait souvent : la qualité de la lecture du contexte compte autant que la taille du modèle.
Elvis Saravia recommande la lecture et résume bien le mécanisme des têtes héritées, mais son post généralise sur trois points. Il présente le gain sur les langues formelles comme un résultat à 3B : il vient de petits modèles de 12 couches, avec un modèle en boucle deux fois plus large. Il écrit que les variantes acquièrent l’apprentissage en contexte « plus tôt » : c’est vrai face au modèle dense de 12 couches, mais le modèle dense de 4 couches est tout aussi précoce. Sur GSM8K, il parle d’un avantage « à chaque nombre d’exemples » : c’est exact, mais l’avance du modèle en boucle se réduit presque à rien à huit exemples. Le post ne dit pas non plus que chaque modèle n’a été entraîné qu’une fois, ni que le gain en contexte se paie par une mémoire plus faible dans les poids.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.31421
- Le PDF : https://arxiv.org/pdf/2610.31421v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2114404629064942018
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/how-depth-growth-and-looping-shape-in-context-learning-in-language-models-2610.31421