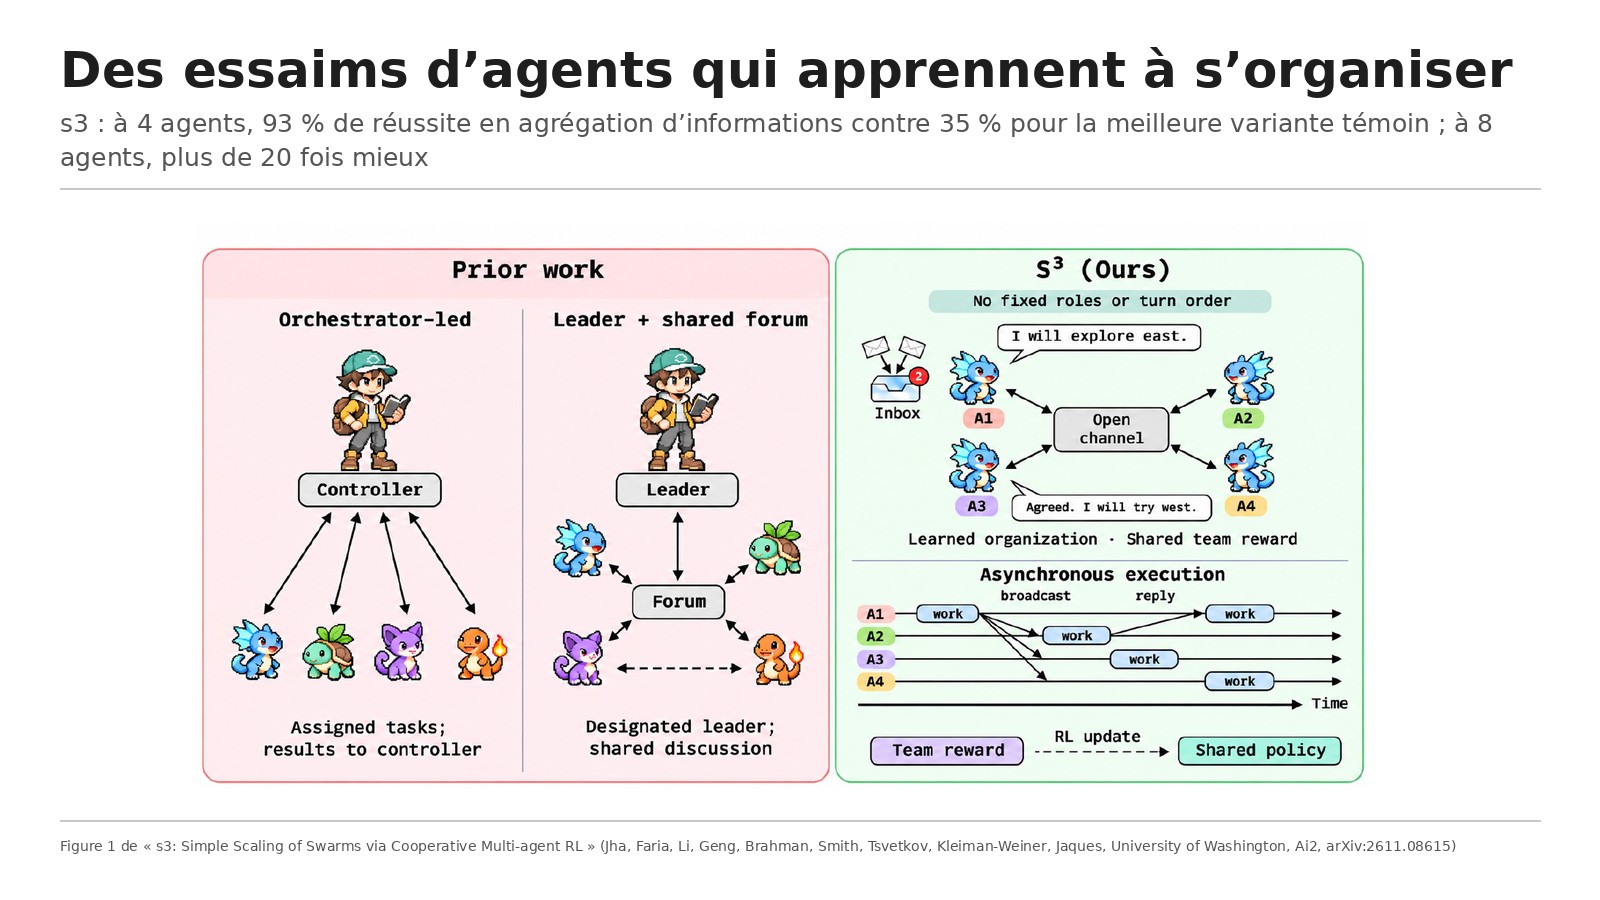
Titre original : s3: Simple Scaling of Swarms via Cooperative Multi-agent RL
Auteurs : Kunal Jha, Gonçalo Faria, Shuyue Stella Li, Scott Geng, Faeze Brahman, Noah A. Smith, Yulia Tsvetkov, Max Kleiman-Weiner et Natasha Jaques.
Affiliations : University of Washington et Allen Institute for Artificial Intelligence (Ai2).
Publication : prépublication arXiv 2611.08615v1 (cs.MA), déposée le 5 novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
La plupart des systèmes multi-agents suivent une organisation écrite à l’avance par leurs concepteurs : un orchestrateur qui découpe le travail, un chef qui anime un forum, des rôles attribués. Les auteurs estiment que ces plans figés cassent souvent (travail dupliqué, messages en avalanche, désaccords non résolus) et proposent de laisser l’organisation émerger de l’entraînement.
Dans s3, une équipe est formée de N copies d’un même modèle. Aucun agent n’est chef, aucun n’a de rôle, il n’y a pas de tour de parole. Chacun travaille sur sa propre copie de la tâche et peut, quand il le veut, envoyer un message à un coéquipier ou à tous, et lire ses messages. Toute l’équipe reçoit une seule récompense : réussite si au moins un agent trouve la bonne réponse, avec une pénalité légère sur le nombre de jetons consommés.
Ce que montre le papier
Une récompense d’équipe et un harnais asynchrone
L’entraînement reprend la logique de GRPO (comparer plusieurs essais sur le même problème), mais l’unité comparée est l’équipe, pas la réponse. Pour chaque problème, huit équipes indépendantes tentent leur chance ; chaque jeton produit par un membre reçoit l’avantage de son équipe. Les agents tournent en parallèle, avec des requêtes découpées en tranches de 1 024 jetons au plus, pour qu’un agent lent ne bloque pas les autres et qu’un message puisse arriver en cours de travail. Les modèles sont petits : Qwen3-0.6B pour la première tâche, Qwen3-1.7B pour la seconde, entraînés à quatre agents pendant 200 mises à jour.
Agréger des informations dispersées
Chaque agent reçoit un nombre secret entre 1 et 99, écrit en toutes lettres, et l’équipe doit rendre la liste complète triée. À quatre agents, s3 réussit 93 % des problèmes tenus à l’écart, contre 35 % pour une variante qui imite les équipes gagnantes et 13 % pour une variante où chaque agent n’est récompensé que pour sa propre réponse. À huit agents, deux fois la taille d’entraînement, s3 réussit plus de vingt fois plus souvent que la variante par imitation, et garde l’avantage jusqu’à douze agents. À seize, toutes les méthodes échouent.
Le dilemme de la récompense individuelle
Quand chaque agent n’est payé que pour lui-même, les auteurs observent un dilemme proche d’un bien public : donner son nombre n’aide que les autres, donc chacun attend que les autres parlent, et beaucoup finissent par ne rien envoyer. Avec la récompense d’équipe, l’essaim converge au contraire vers un protocole sobre : en fin d’entraînement, 80 % des équipes envoient un seul message collectif par agent, et les agents partagent avant de lire.
Explorer à plusieurs
Dans la seconde tâche, chaque agent explore un arbre de salles (391 salles à profondeur trois) pour trouver la sortie ; un agent seul peut réussir. Couper les messages fait perdre 19 points de réussite à quatre agents, et les agents qui communiquent visitent près de deux fois moins les mêmes salles. Face à des agents entraînés seuls puis lancés en parallèle (le « best-of-N »), s3 gagne 9,4 points à quatre agents et 7,3 points à six. Quatre agents s3 font presque aussi bien que six agents isolés.
Les limites
Les auteurs le disent eux-mêmes : deux tâches seulement, des petits modèles et un seul entraînement par condition, de sorte que de nouveaux essais pourraient modifier certains résultats. Les agents commettent encore des erreurs typiques : rendre une mauvaise réponse alors qu’ils ont toute l’information, refaire la recherche d’un coéquipier, croire un rapport non vérifié.
Nos réserves portent sur les tâches. Trier des nombres dispersés et explorer un arbre de salles sont des bancs d’essai très contrôlés, loin d’un vrai travail d’équipe sur du code ou des documents. En exploration, le gain de 9,4 points à quatre agents n’est significatif qu’avant correction statistique pour comparaisons multiples (Bonferroni), et il disparaît à huit agents et plus, où les agents isolés atteignent presque 100 %. À ces tailles, l’efficacité en jetons de s3 devient même inférieure à celle des agents isolés (tableau 8). Sans démonstrations initiales, l’essaim n’a plus d’avantage significatif. Le papier ne mentionne pas de publication du code.
Lecture Neurone21
Le message utile pour une entreprise qui assemble des équipes d’agents n’est pas « l’essaim bat toujours l’agent seul ». Il est plus précis : quand le travail exige de combiner des informations que chacun détient seul, une organisation apprise avec une récompense commune fait beaucoup mieux qu’une organisation imposée ; quand chaque agent peut réussir seul, lancer plusieurs agents indépendants reste une base solide et difficile à battre.
Le résultat sur la récompense individuelle se transpose sans rien entraîner. Un système où chaque agent est évalué sur sa propre sortie pousse à la rétention d’information. Mesurer la réussite de l’équipe, et pas de chaque agent, est une règle simple à appliquer dès la conception d’un système multi-agent, y compris avec des modèles du commerce.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté comme un papier à lire absolument le 9 novembre 2026 à 15:01 heure de Paris, puis l’a reposté le 10 novembre à 03:10 heure de Paris. Nous avons lu la version officielle arXiv 2611.08615v1. Écarts avec le post :
Les chiffres du post reprennent ceux de l’abstract : « plus de 25 fois » plus de problèmes de coordination résolus à deux fois la taille d’entraînement, près de 50 % de travail répété en moins, jusqu’à 9,4 points au-dessus du best-of-N. Le corps du papier écrit « plus de vingt fois » face à la variante par imitation à huit agents, sans donner le rapport exact. Le post ne précise pas que le gain de 9,4 points perd sa significativité après correction, qu’il s’annule au-delà de huit agents, ni que les modèles testés ont 0,6 et 1,7 milliard de paramètres.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.08615
- Le PDF : https://arxiv.org/pdf/2611.08615
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2119792446242718170
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/s-3-simple-scaling-of-swarms-via-cooperative-multi-agent-rl-2611.08615