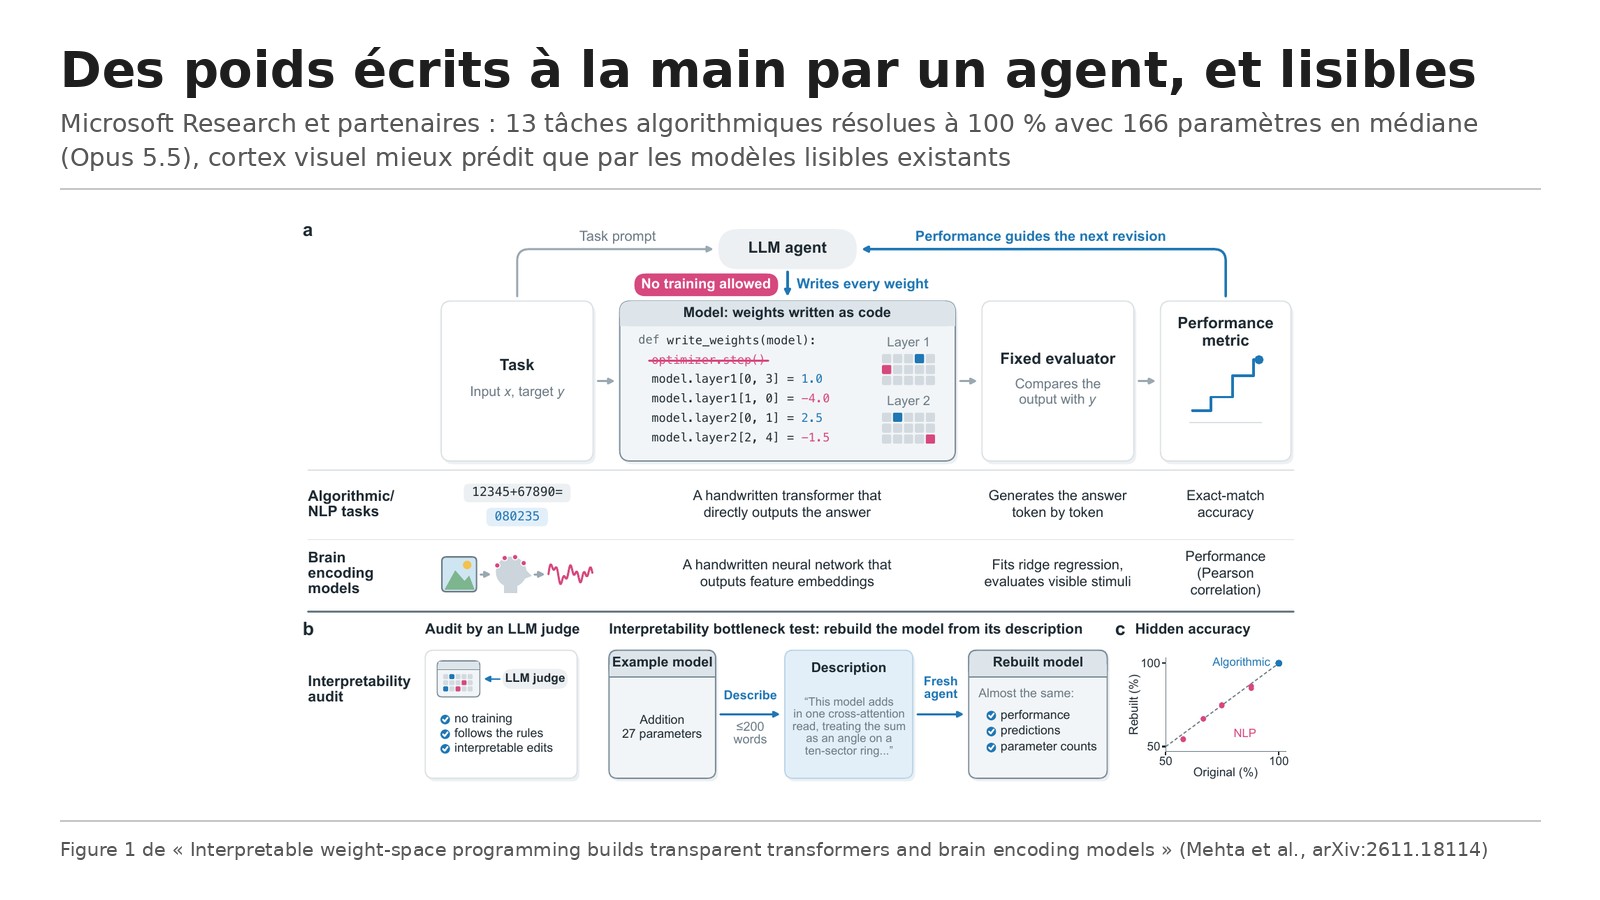
Titre original : Interpretable weight-space programming builds transparent transformers and brain encoding models
Auteurs : Yash Mehta, Chandan Singh, Weijia Xu, Richard J. Antonello, Adeen Flinker, Nima Mesgarani, Michael F. Bonner, Nebojsa Jojic et Jianfeng Gao.
Affiliations : Microsoft Research (Mehta, Singh, Xu, Jojic, Gao), Johns Hopkins University (Mehta, Bonner), Columbia University (Antonello, Mesgarani) et New York University (Flinker).
Publication : prépublication déposée sur arXiv le 13 novembre 2026 (2611.18114v1, 33 pages). Pas de relecture par des pairs à cette date.
Liens : page arXiv, PDF.
L’idée en bref
Les réseaux de neurones prédisent bien mais s’expliquent mal. En neurosciences, c’est un vrai obstacle : un réseau profond prédit très bien l’activité du cortex visuel face à une image, sans dire quelles caractéristiques de l’image comptent. Les modèles lisibles (filtres de Gabor, normalisation) s’expliquent, mais prédisent moins bien.
La méthode proposée, la programmation interprétable de l’espace des poids (iWSP), revient aux origines : écrire les poids à la main, comme McCulloch et Pitts dans les années 1940, mais en confiant la plume à un agent. L’agent (Claude Code avec Opus 5.5, Sonnet 5.5 ou Haiku 5.5) écrit un modèle dont tous les poids sont fixés dans le code, sans aucun entraînement par gradient. Un évaluateur fixe mesure le résultat, l’agent révise, sur 30 à 50 itérations par run. Faute de rétropropagation, chaque modification doit venir d’un raisonnement explicite, documenté par écrit. Ensuite, un juge LLM audite chaque modèle sauvegardé (pas d’entraînement caché, pas de règle violée), et un test vérifie la lisibilité : l’agent décrit son meilleur modèle en 200 mots au plus, et une session neuve doit le reconstruire à partir de ce seul texte.
Ce que montre le papier
Des transformers exacts et minuscules sur l’algorithmique
Sur 17 tâches (13 algorithmiques comme la multiplication, le tri, la distance d’édition ou la normalisation de dates, et quatre de langage : classement de questions TREC, sentiment SST-2, paraphrase MRPC, inférence SNLI), chaque LLM fait deux runs par tâche, soit 1 340 itérations environ par LLM. Avec Opus 5.5, les 26 runs algorithmiques atteignent 100 % sur l’ensemble visible et sur 2 000 exemples cachés, souvent en inscrivant dans les poids un algorithme connu : le plus grand commun diviseur, par exemple, est calculé par l’algorithme d’Euclide par soustraction, avec un bloc de neurones ReLU répété.
Le modèle devient d’abord exact (99 % en un dixième des itérations), puis l’agent le comprime, d’environ 3 400 paramètres à environ 200. Le plus petit modèle exact compte 166 paramètres en médiane avec Opus, 41 600 avec Sonnet et 100 000 avec Haiku : les trois atteignent presque tous 100 %, mais le plus grand modèle sait bien mieux compresser. Les reconstructions à partir de 200 mots ont en moyenne 1,74 fois plus de paramètres que l’original ; une session témoin sans description en écrit 2 043 fois plus.
Le langage résiste
Sur les tâches de langage, les modèles restent vers 190 000 paramètres et plafonnent après les trois quarts des itérations. Ils dépassent nettement la réponse majoritaire sur trois tâches sur quatre (TREC : 87,3 % avec Opus), mais restent sous elle sur la paraphrase. Le modèle de sentiment écrit par l’agent est un outil rudimentaire : repérer des mots, inverser le signe après une négation, additionner.
Cortex visuel : mieux que les modèles lisibles existants
Sur LAION-fMRI (IRM à 7 teslas, cinq sujets, 25 052 images), 600 itérations produisent un programme de 865 lignes qui calcule 9 996 caractéristiques à partir de 14 opérations explicites : énergie de Gabor, contrastes de couleur, géométrie locale des surfaces, courbure des contours, corrélations entre cartes. Testé sans réajustement sur un autre jeu (NSD, quatre sujets), il bat les sept modèles lisibles de référence chez chaque sujet : 0,443 de corrélation contre 0,400 dans le cortex visuel précoce, 0,317 contre 0,256 dans le cortex ventral. Il égale AlexNet, un réseau entraîné, dans le cortex précoce, mais reste derrière dans le ventral (0,391). Un résumé de 185 mots suffit à reconstruire un modèle à 0,451 (contre 0,488 pour l’original).
IRM du langage : un biais débusqué
Sur un jeu d’IRM où trois sujets écoutent des histoires (expérience menée avec Claude Opus 4.7), la performance progresse lentement, sous la référence GPT-2 XL (0,079), puis bondit en une étape de 0,067 à 0,104. Les caractéristiques ajoutées ne codent pas le sens des mots mais leur position dans l’histoire : seules, elles atteignent 0,090, au-dessus de GPT-2 XL. L’enquête montre que la réponse moyenne est anormalement haute en début de scan et basse en fin, chez les trois sujets, sans lien avec le contenu. Un effet de ce type était connu (d’où la convention d’ignorer les 100 premières secondes), mais la lisibilité du modèle a permis de le repérer immédiatement.
Audition : utile en complément de Whisper
Sur l’activité de 166 électrodes intracrâniennes, le modèle écrit (3 852 caractéristiques) reste sous Whisper sur les données cachées (0,065 contre 0,070), mais il capte une part de signal que Whisper manque : les combiner fait passer la prédiction de 0,070 à 0,075, avec 126 électrodes améliorées sur 166. Sur cinq autres patients, Whisper fait mieux à chaque fois, et l’apport propre du modèle écrit se retrouve chez quatre patients sur six.
Les limites
Les auteurs le disent : les agents n’inventent pas de principes de calcul nouveaux, ils combinent des motifs connus (algorithmes de manuel, filtres classiques du cortex). Les modèles restent peu profonds, ce qui explique sans doute le retard sur les réseaux entraînés dans le cortex ventral, le langage et la parole. La méthode suppose que les explications écrites de l’agent restent fidèles à ses modifications, ce qu’il faudra continuer de vérifier avec des agents plus forts. La recherche est lente et coûteuse (environ 17 500 dollars au prix catalogue des API pour l’ensemble du papier). Enfin, les expériences de neurosciences sont observationnelles, avec peu de sujets et sans intervention causale.
Nos réserves : sur le langage, la seule référence présentée est la réponse majoritaire, pas un classifieur entraîné, ce qui ne permet pas de mesurer le coût réel de la lisibilité. Les résultats algorithmiques portent sur des tâches dont la solution exacte est connue des manuels, donc probablement de l’agent. L’audit d’interprétabilité repose largement sur des LLM (le juge, le rédacteur de description, le reconstructeur), tous de la même famille Claude.
Lecture Neurone21
Pour une entreprise, l’intérêt n’est pas de remplacer ses modèles entraînés, mais de disposer d’un outil d’audit : un modèle dont chaque ligne s’explique peut révéler qu’un bon score repose sur un artefact des données, comme ici la position dans le scan. C’est exactement le risque d’un modèle qui « marche » pour de mauvaises raisons. Sur des problèmes à règles connues (formats, calculs, validations), faire écrire un petit modèle lisible par un agent est une piste sérieuse. Sur le langage naturel, les réseaux entraînés gardent l’avantage.
D’où vient ce papier
DAIR.AI (@dair_ai) l’a présenté le 16 novembre 2026 à 17:45 heure de Paris (16:45 UTC). Elvis Saravia (@omarsar0) a cité ce post à 17:59 heure de Paris le même jour, puis l’a reposté le 17 novembre 2026 à 02:53 heure de Paris. Nous avons lu la version officielle arXiv 2611.18114v1. Écarts avec les posts :
Les chiffres du post DAIR.AI sont ceux du papier (166 paramètres en médiane, 26 runs à 100 % sur données cachées, 30 à 50 itérations, 41 600 pour Sonnet et 100 000 pour Haiku, environ 190 000 pour le langage). Deux nuances : les 166 paramètres et les 26 runs concernent Opus 5.5 seul, et l’expérience d’IRM du langage a été faite avec Claude Opus 4.7. Surtout, le post écrit que les modèles de langage « perdent en précision face aux références apprises » : le papier ne compare qu’avec la réponse majoritaire, qu’il bat sur trois tâches sur quatre. Le commentaire d’Elvis (« les grands modèles font mieux et plus efficacement ») vaut pour la compression : sur la précision algorithmique, les trois modèles atteignent presque tous 100 %.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.18114
- Le PDF : https://arxiv.org/pdf/2611.18114
- Le post DAIR.AI : https://x.com/dair_ai/status/2122370369097277634
- La citation d’Elvis Saravia : https://x.com/omarsar0/status/2122374124601590078
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/interpretable-weight-space-programming-builds-transparent-transformers-and-brain-2611.18114
- Notre fiche sur les premiers travaux du MIT, où GPT-6 Astra lit et écrit des poids : /p/poids-reseau-ia-lit-ecrit-programmation-espace-poids