Titre original : Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights
Auteurs : Rikiya Takehi et Jayden Teoh (contribution égale, signalée par un astérisque), Alex Zhang et Omar Khattab.
Affiliations : MIT CSAIL pour les quatre auteurs.
Publication : billet de blog daté du 2 novembre 2026. Ce n’est pas une prépublication arXiv, et il n’a pas de relecture par des pairs ; les auteurs le présentent comme des « résultats très précoces ». Il n’existe pas, à notre connaissance, de version arXiv à la date de cette fiche.
Liens : billet de blog, journaux des expériences.
L’idée en bref
On optimise depuis des années du texte avec des LLM : des prompts, des programmes, des harnais d’agents, du code d’entraînement. Les poids d’un réseau de neurones, eux, restaient le domaine d’algorithmes symboliques comme Adam ou Muon, car aucun humain ne sait « éditer à la main » une matrice de nombres.
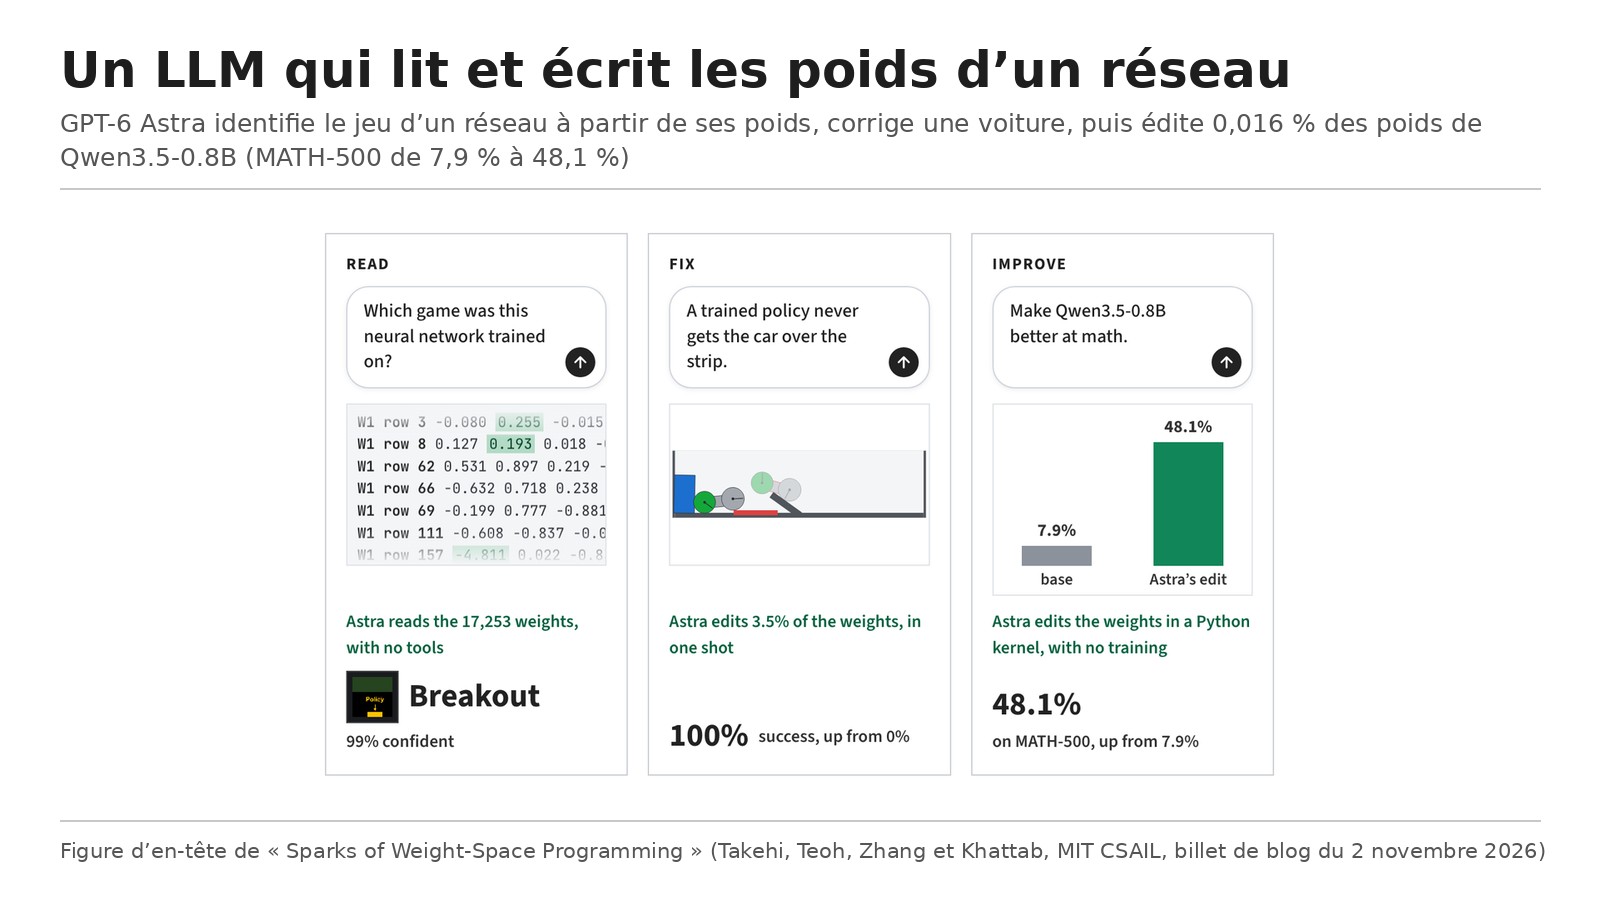
Les auteurs appellent Weight-Space Programming (programmation dans l’espace des poids) l’idée qu’un LLM généraliste lise et écrive directement les poids d’un réseau à partir d’une consigne en langage naturel, sans optimiseur ni descente de gradient. Ils testent GPT-6 Astra, un modèle fermé d’OpenAI, sur trois sortes de tâches : lire des poids pour deviner ce que fait le réseau, corriger un réseau défaillant, et en écrire un de zéro.
Ce que montre le papier
Lire : deviner un réseau d’après ses poids
Astra reçoit les 17 253 poids de réseaux entraînés par PPO sur quatre jeux de grille 10 par 10 (Breakout, Pong, Pac-Man, Freeway), tous de même taille et de mêmes entrées. Sans qu’on lui donne la liste des jeux, il nomme le bon jeu pour les quatre réseaux ; sur Breakout il se dit sûr à 99 %. Il s’appuie sur la répartition des poids de chaque canal d’entrée, par exemple une concentration sur la rangée du bas pour la raquette.
Il reconnaît aussi la forme que génère un petit modèle de diffusion (cercle, triangle, carré), sans outil et sans passe avant, mais en dessinant les formes en contour alors que le modèle les génère pleines. Enfin, sur trois petits modèles de langage de 7,2 millions de poids entraînés sur du Python, du japonais en romaji et de l’anglais, on lui retire la couche d’entrée et la couche de sortie. Astra donne la bonne langue pour les trois, dans ses deux essais, et il trouve toutes les têtes d’attention qui recopient du texte (figure 1), en accord avec les mesures faites en exécutant le modèle.
Corriger : réparer une politique de conduite
Dans un niveau de Kinetix, une voiture doit reculer avant d’accélérer pour franchir une rampe. Le réseau entraîné par PPO converge vers un mauvais optimum : il fonce droit et reste bloqué, avec 0 réussite sur 256 épisodes. Astra reçoit les poids, la description de la scène et un épisode enregistré. En une seule réponse, sans outil, il ajoute un petit chemin de quelques neurones par couche qui fait reculer la voiture puis se désactive, en changeant 3,5 % des poids. La voiture réussit les 1 024 épisodes.
Écrire : des réseaux de jeu faits d’un seul jet
Pour trois jeux MinAtar (Breakout, Seaquest, Asterix), Astra écrit des poids de zéro à partir des règles et du code, sans entraînement, sans données et sans jamais voir le réseau jouer. Voici les scores moyens sur 1 000 épisodes.
| Jeu | PPO 100 M de pas | PPO 500 M de pas | Astra, d’un seul jet |
|---|---|---|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Astra dépasse donc le PPO de 100 millions de pas dans les trois jeux, atteint 20 fois le score du PPO de 500 millions de pas sur Breakout, mais n’en atteint qu’environ 60 % sur Seaquest et à peine moins sur Asterix. Pour Breakout, il programme la première couche pour calculer où la balle va tomber et la deuxième pour amener la raquette à cet endroit.
Sur Go 9 par 9, avec un réseau de 1,48 million de poids qui ne tient plus dans le contexte, Astra dispose d’un bac à sable Python et d’un budget de passes avant. Sans aucune passe, il bat plus d’une fois sur deux deux petits réseaux PPO. Avec 50 passes, son réseau bat le PPO de même taille entraîné sur 20 millions de parties.
Améliorer : supprimer les boucles d’un petit modèle de langage
C’est le résultat le plus repris. Qwen3.5-0.8B, avec la réflexion activée, tourne en boucle : 93 % de ses réponses sur MATH-500 atteignent la limite de 32 768 tokens, et la fiche de modèle de Qwen met elle-même en garde contre ce défaut. Astra reçoit un bac à sable Python sur les poids, des exercices d’entraînement de GSM8K et de MATH (pas ceux de test) et un budget de 10, 25 ou 50 passes avant. Il trace les boucles jusqu’à une direction écrite par les couches MLP 15 et 19 et la soustrait de 64 colonnes de sortie dans chacune, soit 131 072 poids ou 0,016 % du modèle.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Réponses à la limite de tokens |
|---|---|---|---|---|
| Base | 7,9 % | 13,8 % | 21,0 % | 93,0 % |
| Édité, 10 passes | 12,3 % | 25,7 % | 49,0 % | 87,2 % |
| Édité, 25 passes | 14,1 % | 25,1 % | 39,9 % | 86,4 % |
| Édité, 50 passes | 48,1 % | 67,1 % | 62,3 % | 33,1 % |
Une seule direction supprimée fait ainsi passer MATH-500 de 7,9 % à 48,1 %, GSM8K de 13,8 % à 67,1 % et IFEval de 21,0 % à 62,3 %. Les gains sont faibles avec 10 et 25 passes, car les boucles disparaissent à peine ; seule l’édition faite avec 50 passes fait chuter la part de réponses bloquées de 93 % à 33 %. Le modèle édité est publié sur Hugging Face.
Les limites
Les auteurs reconnaissent plusieurs échecs et bornes :
- sur Gemma 3 270M, qui boucle rarement (8,5 % de réponses à la limite), Astra n’améliore pas les maths : aucune édition ne dépasse environ un point sur MATH-500, un gain qu’Astra juge lui-même non établi. Éditer des poids peut lever un obstacle qui masquait une capacité, pas en ajouter une ;
- pour repérer le modèle flagorneur entre deux copies de Gemma 3 270M, Astra échoue sur les seuls poids dans ses quatre essais. Il ne réussit, sur les trois paires, que lorsqu’on lui laisse regarder les motifs d’attention de chaque modèle sur des textes qu’il écrit lui-même ;
- les capacités sont encore limitées, notamment par la longueur de contexte et par les harnais, et un banc d’essai est annoncé pour mesurer les progrès ;
- ce sont des résultats précoces, et le billet ne présente aucune comparaison avec une méthode d’édition de poids classique.
Réserves de notre lecture :
- le modèle éditeur est fermé : seuls les journaux, les poids de Qwen édité et les tableaux sont publics, pas la façon dont Astra raisonne en interne, et des résultats sur un autre LLM restent à vérifier ;
- le billet n’est pas relu, et il compare une édition à un PPO dont les poids sont « le meilleur de 3 à 10 essais » : le comparatif est correct mais dépend de ce choix ;
- le gain de 6 fois sur MATH-500 vient d’un défaut connu du modèle de départ, qui rend le point de base très bas : la fin des boucles permet au modèle de finir des réponses qu’il savait déjà résoudre, elle ne lui apprend pas de nouvelle compétence, comme le billet le dit lui-même ;
- d’après les journaux, chaque budget de passes correspond à une seule exécution, sans répétition, et seul le résultat à 50 passes produit un gain net ;
- la partie sur l’auto-amélioration récursive (RSI) est présentée comme une perspective, sans expérience dans le billet.
Lecture Neurone21
Pour une entreprise, il n’y a rien à déployer ici : le résultat est un jalon de recherche. Il ouvre pourtant trois pistes à surveiller.
La première est l’audit sans évaluation : savoir ce qu’un modèle a appris, voire y trouver une porte dérobée, en lisant ses poids plutôt qu’en lançant des tests. Les expériences montrent que c’est possible sur de petits réseaux, mais l’échec sur le modèle flagorneur rappelle que la lecture reste fragile quand le comportement n’est pas visible dans des poids isolés. Nous avons déjà traité ce risque côté attaque avec la fiche sur la porte dérobée de pré-entraînement et celle sur le modèle altéré en mémoire chez NVIDIA et Eclypsium.
La deuxième est la réparation ciblée : un défaut précis, ici des boucles de raisonnement, supprimé en touchant 0,016 % des poids sans réentraînement. Si ce type d’édition se confirme sur d’autres modèles, cela réduirait le coût de correction d’un modèle ouvert déployé en interne. Pour l’instant, c’est une démonstration sur un modèle de 0,8 milliard de paramètres.
La troisième est l’auto-amélioration. Elvis Saravia y voit un chemin plus natif que les chaînes actuelles, où un modèle écrit du code qui lance un entraînement ; le billet l’évoque aussi. Nos fiches sur les agents auto-évolutifs et sur le harnais qu’un modèle améliore lui-même montrent que l’auto-amélioration a encore des limites nettes, ce qui incite à la prudence.
Le résumé d’Elvis Saravia est fidèle sur l’essentiel. Précisions : « surpasser un PPO de 100 millions de pas » est exact, mais face au PPO de 500 millions, Astra fait 53,1 contre 88,9 sur Seaquest et 53,2 contre 55,2 sur Asterix ; le gain sur les maths vient de la suppression de boucles, pas d’une capacité nouvelle ; et le rapprochement avec l’auto-amélioration récursive est un avis, présenté dans le billet comme une perspective non testée. Elvis parle d’un « rapport » : c’est un billet de blog.
Pour aller plus loin
- Le billet de blog : https://rikiyat.github.io/blog/weight-space-programming/
- Les journaux complets des expériences : https://github.com/RikiyaT/lm_understand-logs
- Le fil de Rikiya Takehi sur X : https://x.com/rikiyatakehi/status/2117313742891327994
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2117353828446060736