Titre original : Forget Freely, Grep Later: Lossless, Index-Free Memory for Long-Horizon LLM Agents
Auteurs : Ziyan Yang et Taiwei Shi (contribution égale), Jieyu Zhao.
Affiliation : Université de Californie du Sud (USC).
Publication : prépublication déposée sur arXiv le 18 novembre 2026 (2611.25123v1, 17 pages). Le code et les instructions de reproduction sont publiés sur GitHub sous licence MIT ; les poids entraînés ne le sont pas encore.
Liens : page arXiv, PDF, code sur GitHub.
L’idée en bref
Un agent qui travaille longtemps finit par dépasser sa fenêtre de contexte et doit jeter de l’information. Les méthodes courantes résument l’historique, masquent les anciennes sorties d’outils, ou rangent des souvenirs dans une mémoire structurée. Toutes obligent à décider à l’avance ce qui mérite d’être gardé, alors qu’un identifiant croisé au début peut ne devenir utile que bien plus tard.
GrepMem sépare le contexte de travail, qui reste borné, de l’historique, qui est conservé en entier. L’agent continue de résumer son contexte quand il approche de la limite, comme dans la méthode SUPO dont il reprend la boucle. Mais chaque message, appel d’outil, résultat et résumé est aussi ajouté à un journal texte qu’on ne modifie jamais. Après le premier résumé, l’agent dispose d’un seul outil supplémentaire, grep_history, qui cherche dans ce journal par expression régulière et rend les lignes trouvées, ou seulement leur nombre. Pas d’embeddings, pas d’index de recherche, pas d’extraction de souvenirs, pas de modèle supplémentaire.
Ce que montre le papier
Le dispositif
Les auteurs entraînent Qwen3.5-9B, avec raisonnement activé, sous cinq stratégies de gestion du contexte, avec la même recette d’apprentissage par renforcement (GRPO), les mêmes données et les mêmes outils : ReAct (tout garder jusqu’à saturation), masquage des anciennes sorties d’outils, résumé façon SUPO, mémoire façon MemGPT (bloc-notes, historique interrogeable et mémoire d’archive) et GrepMem. La fenêtre est de 32 768 tokens pour toutes. L’entraînement porte sur 4 000 épisodes : 70 % de questions de recherche simples, 15 % de sessions à trois questions, 15 % de flux synthétiques de type ContextBench. Chaque passage utilise 24 GPU H100, et l’ensemble de l’entraînement a demandé environ 6 000 heures-H100.
L’évaluation porte sur cinq tâches. BCP-Multi regroupe les questions de BrowseComp-Plus par trois, à résoudre ensemble en 60 tours sur un corpus de 100 000 documents. AMA-Bench pose des questions sur des trajectoires d’agents enregistrées, soit dans un fichier consultable, soit lues par morceaux. ContextBench fait défiler de longues séries d’enregistrements clé-valeur ou de journaux de service (de 33 000 à 968 000 tokens), puis pose 24 questions qui demandent des valeurs exactes ou des comptages.
Les résultats après entraînement
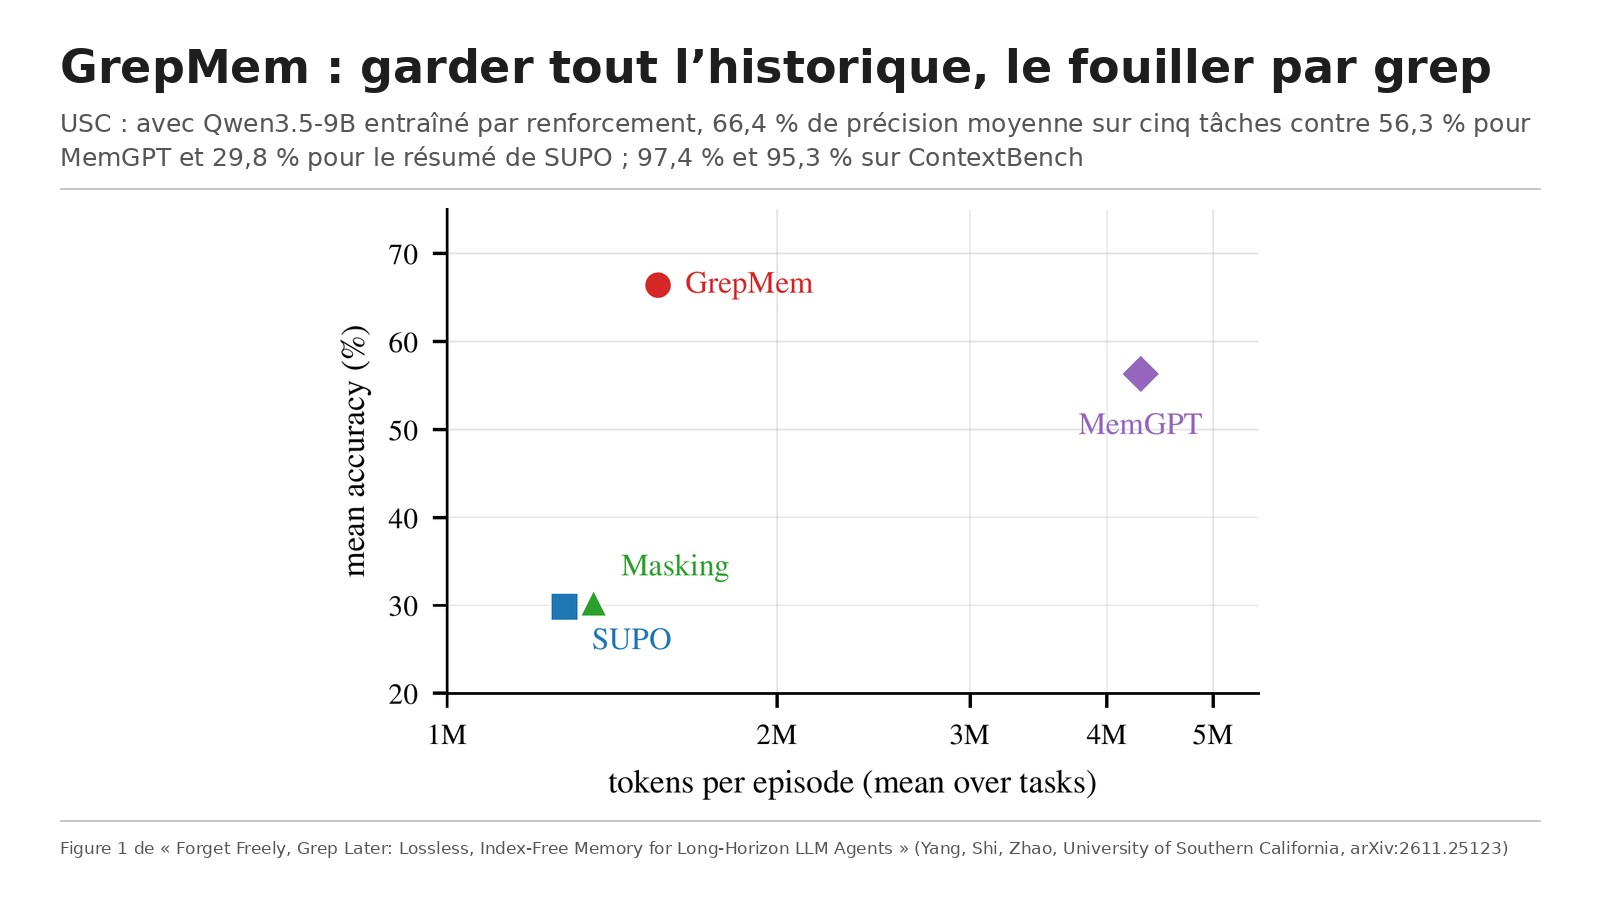
GrepMem obtient la meilleure moyenne sur les cinq tâches : 66,4 %, contre 56,3 % pour MemGPT, 30,3 % pour le masquage, 29,8 % pour SUPO et 13,0 % pour ReAct. L’avantage est le plus net quand il faut retrouver un détail exact sorti du contexte : sur ContextBench, GrepMem atteint 97,4 % sur les valeurs clé-valeur et 95,3 % sur le tri de journaux, contre 6,6 à 20,7 % pour SUPO et le masquage. MemGPT, qui garde lui aussi tout son historique, fait mieux sur les valeurs clé-valeur (99,9 %) mais plafonne à 50,0 % sur les journaux. Sur BCP-Multi, GrepMem atteint 46,9 %, soit 8,8 points de plus que SUPO et 7,0 de plus que MemGPT ; SUPO et GrepMem y font en moyenne 25 à 27 résumés par épisode.
Sur AMA-Bench, en revanche, presque rien ne sépare les stratégies hors ReAct : au plus 1,2 point d’écart sur la version par morceaux, et un écart non significatif même sur les trajectoires plus longues que la fenêtre. Les questions y portent souvent sur des causes ou des changements d’état, qu’un résumé conserve bien. Pour les auteurs, l’intérêt d’un rappel sans perte dépend de la nature de la question (un détail exact que le résumé a pu jeter) plus que du moment où elle est posée.
Ce que l’entraînement apporte
L’apprentissage par renforcement fait gagner 5,9 points en moyenne à GrepMem, surtout sur le tri de journaux (+20,3 points, de 75,0 % à 95,3 %) et sur BCP-Multi (+6,0 points). Les auteurs y voient de meilleures requêtes et une meilleure exploitation des résultats. Quand la longueur des flux ContextBench augmente, GrepMem garde sa précision, alors que SUPO et le masquage tombent près de zéro dans certains réglages.
Le coût
Aucune stratégie évaluée n’est à la fois moins chère et plus précise que GrepMem sur les cinq tâches : il est sur la frontière de Pareto entre précision et tokens consommés. Par rapport à SUPO, il consomme 6 % de tokens de plus sur BCP-Multi et 5 % de moins sur AMA-Bench en fichier ; sur ContextBench, 19 % de plus que SUPO et seulement 29 % des tokens de MemGPT (2,51 millions contre 8,60 millions par flux). L’exception est AMA-Bench par morceaux, où il consomme 2,3 fois plus de tokens que SUPO, avec environ 19 recherches par trajectoire, pour un gain minime. Sur ContextBench, il est aussi plus rapide que SUPO (38 contre 61 minutes par flux clé-valeur), car il écrit des résumés plus courts.
Les limites
Les auteurs reconnaissent une évaluation sur des bancs contrôlés et un seul modèle, ce qui laisse ouverte la généralisation à d’autres agents. La recherche est lexicale : elle marche mal si l’information utile ne peut pas être retrouvée par un motif explicite (nom, nombre, date, identifiant). Et quand un résumé suffit, la recherche ajoute un coût inutile, comme sur AMA-Bench. À la lecture, d’autres points tempèrent les résultats. L’avance de 8,8 points sur SUPO en recherche multi-questions se compare à un SUPO qui a reculé avec l’entraînement : avant entraînement, SUPO faisait 45,2 % et GrepMem 40,9 %, et le point de contrôle retenu pour SUPO était à 42,9 % une évaluation plus tôt, contre 38,1 % au final. Les auteurs signalent eux-mêmes que les points de contrôle isolés fluctuent de plusieurs points, et le dépôt indique que le point de contrôle final a été choisi après examen des courbes d’évaluation. Chaque stratégie n’a été entraînée qu’une fois ; les intervalles de confiance reflètent la variation entre questions, pas entre entraînements. Une erreur du premier harnais d’évaluation a obligé à réévaluer SUPO et GrepMem. Enfin, un journal qui garde tout garde aussi les données sensibles : les auteurs recommandent contrôle d’accès et politique de conservation.
Lecture Neurone21
Pour une entreprise qui construit des agents qui travaillent longtemps (recherche documentaire, analyse de journaux, support), ce papier rejoint un constat déjà fait sur Neurone21 : avant d’installer une base vectorielle et une mémoire structurée, il vaut la peine d’essayer la solution la plus simple, garder l’historique brut dans un fichier et laisser l’agent y chercher. GrepMem est facile à reproduire : un fichier texte en ajout seul et un outil de recherche par motif suffisent, et le code est publié. Le gain est réel quand l’agent doit retrouver une valeur exacte (un identifiant, un montant, une ligne de journal) ; il est nul quand la question porte sur le sens général, que le résumé capte déjà. Il faut aussi noter que ces gains ont été obtenus avec un modèle de 9 milliards de paramètres entraîné exprès à se servir de l’outil : sans entraînement, l’avance existe mais elle est plus faible. Enfin, garder tout l’historique d’un agent, c’est conserver tout ce qu’il a lu, données personnelles comprises : la question de la conservation et des droits d’accès doit être posée dès la conception.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.25123v1. Les chiffres principaux sont conformes au papier : Qwen3.5-9B entraîné par renforcement sous cinq stratégies, 95 à 97 % sur ContextBench (97,4 % et 95,3 %), 8,8 points de mieux que le résumé de SUPO sur BCP-Multi, frontière de Pareto entre précision et tokens sur les cinq tâches. Trois précisions. Le plafond de 21 % concerne les deux méthodes avec perte, SUPO et le masquage (20,7 % au mieux) ; MemGPT, qui conserve aussi son historique, atteint 99,9 % sur la tâche clé-valeur, au-dessus de GrepMem, mais 50,0 % sur les journaux. L’avance sur SUPO est mesurée après entraînement ; avant, SUPO était devant sur BCP-Multi (45,2 % contre 40,9 %). La frontière de Pareto est établie sur quatre stratégies, le coût de ReAct n’ayant pas pu être mesuré.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.25123
- Le PDF : https://arxiv.org/pdf/2611.25123
- Le code des auteurs : https://github.com/limenlp/GrepMem
- Notre fiche MemoryTax : avec un modèle fort, chercher dans l’historique brut suffit : /p/memoire-agents-memorytax
- Notre fiche sur la compaction du contexte des agents chez NVIDIA : /p/contexte-court-compaction-agents-nvidia
- Notre fiche sur les Context Language Models de Meta : /p/modeles-contexte-editable-meta
- Notre page Qwen : /wiki/qwen