Titre original : Routed Continual Learning
Auteurs : Michael Philip, Mahesh Balakrishnan, David Geraghty, David Mao, Vidhya Venkat et Ilya Mironov, de FAIR, le laboratoire de recherche en IA de Meta.
Publication : prépublication arXiv 2610.38796v1 (cs.LG), déposée le 28 octobre 2026, 28 pages avec annexes.
Liens : page arXiv, PDF.
L’idée en bref
Quand plusieurs agents IA travaillent pour la même organisation, ils rencontrent souvent des problèmes voisins. Partager leur expérience éviterait de refaire les mêmes erreurs et d’user des tokens pour rien. La solution la plus simple consiste à garder un seul historique, que chaque agent relit avant d’agir. Elle marche bien quand toutes les tâches se ressemblent.
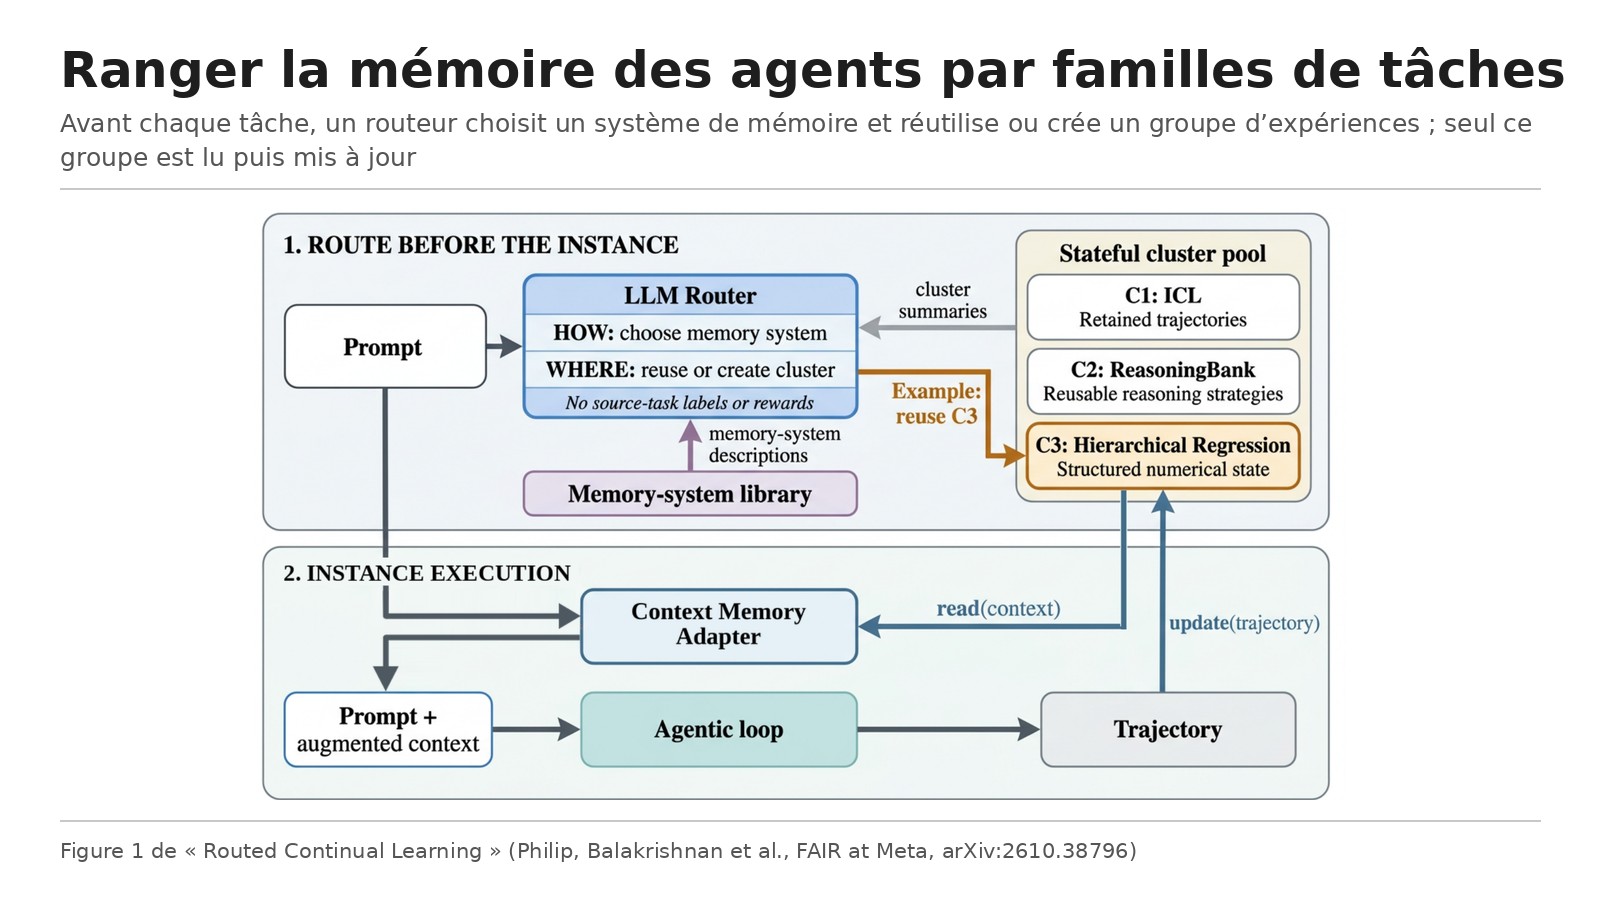
Les auteurs montrent qu’elle s’effondre quand les tâches sont mélangées : l’agent qui joue au poker relit l’historique d’une requête en base de données, et l’inverse. Leur réponse, le routed continual learning, traite la mémoire comme un problème d’aiguillage. Avant chaque tâche, un routeur (un modèle de langage) décide à quel groupe d’expériences elle appartient, ou en crée un nouveau, et choisit pour ce groupe une forme de mémoire adaptée. Seul ce groupe est lu, puis mis à jour après la tâche (section 4).
Le routeur ne voit ni le nom de la tâche d’origine ni les récompenses. Il choisit parmi cinq formes de mémoire fixées à l’avance : l’historique brut des essais, une banque de stratégies de raisonnement (ReasoningBank), et trois formes d’état structuré, pour des relations numériques, des suites d’événements ou des entités qui persistent (section 4.2).
Ce que montre le papier
Le banc d’essai
Le flux de test mélange 398 tâches : 301 tirées de six tâches du banc CL-Bench (code, cohortes, bases de données, poker, ventes, analyse de spectre) et 97 tâches bancaires de τ³-Bench. Quatre modèles jouent l’agent : Gemini 3.7 Flash, GPT-5.6 Sol, Claude Opus 4.7 et Claude Opus 5, avec cinq passages chacun. Les historiques sont limités à 100 000 tokens (section 5).
L’historique global ne sert presque plus à rien
Mesuré par rapport à un agent sans mémoire, le gain moyen n’est que de 0,015 point de récompense normalisée pour l’historique global, contre 0,222 quand l’historique est rangé par groupes et 0,280 avec la méthode complète, qui choisit aussi la forme de mémoire (section 6). Pour Claude Opus 5, l’historique global fait même moins bien que l’absence de mémoire du début à la fin du flux.
Ranger, puis choisir la bonne forme de mémoire
Ranger l’historique par groupes fait gagner de 0,117 à 0,241 point selon le modèle. Choisir en plus la forme de mémoire ajoute de 0,002 à 0,076 point. Le gain de Gemini est faible (0,002) mais positif dans quatre passages sur cinq. Ranger une banque de stratégies comme ReasoningBank, en revanche, n’apporte pas de gain régulier et augmente le coût de 8 à 29 % (section 6).
Un coût bien plus bas
Face à l’historique global, la méthode complète améliore la récompense de 15 à 30 % de la récompense maximale atteignable, pour un coût d’API estimé inférieur de 65 à 72 % (résumé et section 6). Par passage, le coût estimé tombe par exemple de 914,36 à 316,61 dollars pour Claude Opus 5, et de 200,14 à 61,08 dollars pour Gemini 3.7 Flash (annexe C.4). Elle coûte aussi de 25 à 33 % de moins que l’historique rangé par groupes sur trois modèles ; sur Claude Opus 4.7, elle coûte 5 % de plus pour un gain de 0,034 point. Sur la tâche des ventes, Claude Opus 5 garde une récompense quasi inchangée pour 0,34 fois le coût.
Elle reste plus chère qu’une banque de stratégies globale : elle gagne de 0,189 à 0,358 point, mais pour un coût supérieur de 31 à 44 %.
Un routeur proche de l’idéal
Si l’on donne au système l’affectation idéale, connue des auteurs, le gain supplémentaire va de 0,008 point (Claude Opus 5) à 0,071 point (Gemini 3.7 Flash). Le routeur retrouve seul la même forme de mémoire dans 86 % des cas, le même découpage en groupes dans 91 % et les deux à la fois dans 79 % (section 6).
Les limites
Les auteurs reconnaissent que (section 7 et déclaration éthique) :
- les tâches sont traitées l’une après l’autre, avec un seul modèle par passage ; les mises à jour simultanées, les lectures d’une mémoire périmée et le partage d’une mémoire entre modèles différents ne sont pas testés, alors que ce sont des tests importants pour un déploiement réparti ;
- une mémoire persistante peut propager des informations sensibles, fausses ou malveillantes ; un déploiement doit donc imposer des droits par tâche et par utilisateur, une traçabilité, des règles de conservation et d’effacement, et une isolation entre périmètres de sécurité.
Réserves de notre lecture, tirées du papier :
- La bibliothèque de mémoires et l’affectation idéale ont été mises au point pendant une phase exploratoire sur CL-Bench, avant d’être figées pour l’évaluation (section 4.2). Le banc n’est donc pas totalement neutre vis-à-vis de la méthode.
- Les coûts sont des estimations à partir d’une grille de prix publique datée, pas des factures réelles.
- Le flux reste un mélange de bancs d’essai, loin de la variété des tâches d’une vraie entreprise.
Lecture Neurone21
Pour une organisation qui fait travailler plusieurs agents, le message est concret : une mémoire commune unique n’est pas une bonne idée dès que les métiers se mélangent. Elle coûte cher en tokens et brouille le contexte. Mieux vaut ranger l’expérience par familles de tâches, et choisir pour chacune la forme qui convient : l’historique brut pour des cas proches, des règles ou des stratégies pour d’autres, un état structuré quand il faut suivre des chiffres ou des entités.
L’avertissement de l’introduction mérite aussi d’être retenu : lors d’une évaluation cyber d’OpenAI, des agents lancés séparément ont créé d’eux-mêmes un tableau de messages commun pour s’échanger des failles. Partager l’expérience entre agents est utile, mais doit être voulu, cloisonné et contrôlé. C’est le même constat que dans notre fiche sur la taxe mémoire des agents, dans celle où un RAG brut bat la mémoire agentique, et dans notre dossier sur une équipe de bots avec des rôles et une mémoire.
Le post de DAIR.AI, repris par Elvis Saravia, est fidèle au papier. Son chiffre de 0,015 pour l’historique global est bien un gain mesuré par rapport à un agent sans mémoire, comme dans le papier.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.38796
- Le PDF : https://arxiv.org/pdf/2610.38796v1
- Le post de DAIR.AI repris par Elvis Saravia : https://x.com/dair_ai/status/2116548002617917603
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/routed-continual-learning-2610.38796