Titre original : JoMoHa: Joint Model–Harness Optimization with Reinforcement Learning
Auteurs : Xudong Wu, Guangchen Lan, Mingqi Yuan et Jiayu Chen (auteur de correspondance).
Affiliations : The University of Hong Kong (Xudong Wu, Mingqi Yuan, Jiayu Chen) et Salesforce AI Research (Guangchen Lan).
Publication : prépublication arXiv 2611.11499v1 (cs.LG), déposée le 8 novembre 2026, avec le code en accès libre.
Liens : page arXiv, PDF, code.
L’idée en bref
Un agent, c’est un modèle et un harnais : le programme qui l’entoure, organise ses étapes, garde l’état de la tâche et le guide. On peut donc l’améliorer de deux façons, en réentraînant le modèle ou en réécrivant le harnais. Les méthodes récentes qui améliorent le harnais confient souvent ce travail à un grand modèle externe, figé, qui n’apprend pas de ses propres résultats.
JoMoHa fait apprendre les deux côtés. Un premier modèle, « l’ingénieur », écrit un harnais sous forme de code exécutable. Un second, « le solveur », réalise la tâche à l’intérieur de ce harnais. Le résultat de la tâche, réussite ou échec, sert de récompense aux deux, chacun sur ce qu’il a lui-même produit. Les auteurs y voient une forme d’auto-amélioration récursive : le système apprend à la fois à faire et à améliorer l’outil qui l’aide à faire.
Ce que montre le papier
Alterner ne suffit pas
Première idée naturelle : entraîner tour à tour le solveur puis l’ingénieur. Sur ALFWorld, un banc d’essai de tâches ménagères en mode texte, la réussite monte de 83,0 % à 90,5 %, puis s’effondre étape après étape jusqu’à 31,5 %.
Pour comprendre, les auteurs gardent un même harnais et le testent avec deux versions du solveur, avant et après. Avec la version tardive, ajouter ce harnais coûte 17,0 points, contre 4,0 avec la version antérieure : le vieux harnais gêne de plus en plus un modèle qui a changé. Mais même sans harnais, le solveur tardif est tombé de 82,5 % à 48,0 % : entraîné sous un harnais inadapté, il a aussi désappris. Sur 47,5 points perdus, 34,5 viennent du modèle et 13,0 de l’incompatibilité.
Un exemple concret : pour nettoyer une éponge et la poser sur un chariot, le solveur tardif réussit en 14 tours sans harnais, mais tourne en rond jusqu’à la limite de 50 tours avec l’ancien. En cause, une ligne de code du harnais qui cherche une clé écrite « action.final_action » au lieu de lire le champ imbriqué : le harnais ne voit pas que le nettoyage est fait et renvoie l’agent le refaire.
Quatre mécanismes de coordination
JoMoHa entraîne donc les deux modèles en même temps et ajoute quatre réglages. Chaque modèle a son propre estimateur de valeur, qui reçoit un court résumé des conditions de la collaboration. Les récompenses sont normalisées séparément pour chaque rôle, car l’ingénieur écrit une fois quand le solveur agit sur plusieurs tours. L’expérience passée est pondérée selon que le partenaire a beaucoup changé depuis. Enfin, le solveur reçoit plus de mises à jour que l’ingénieur, dans un rapport de 3 pour 2.
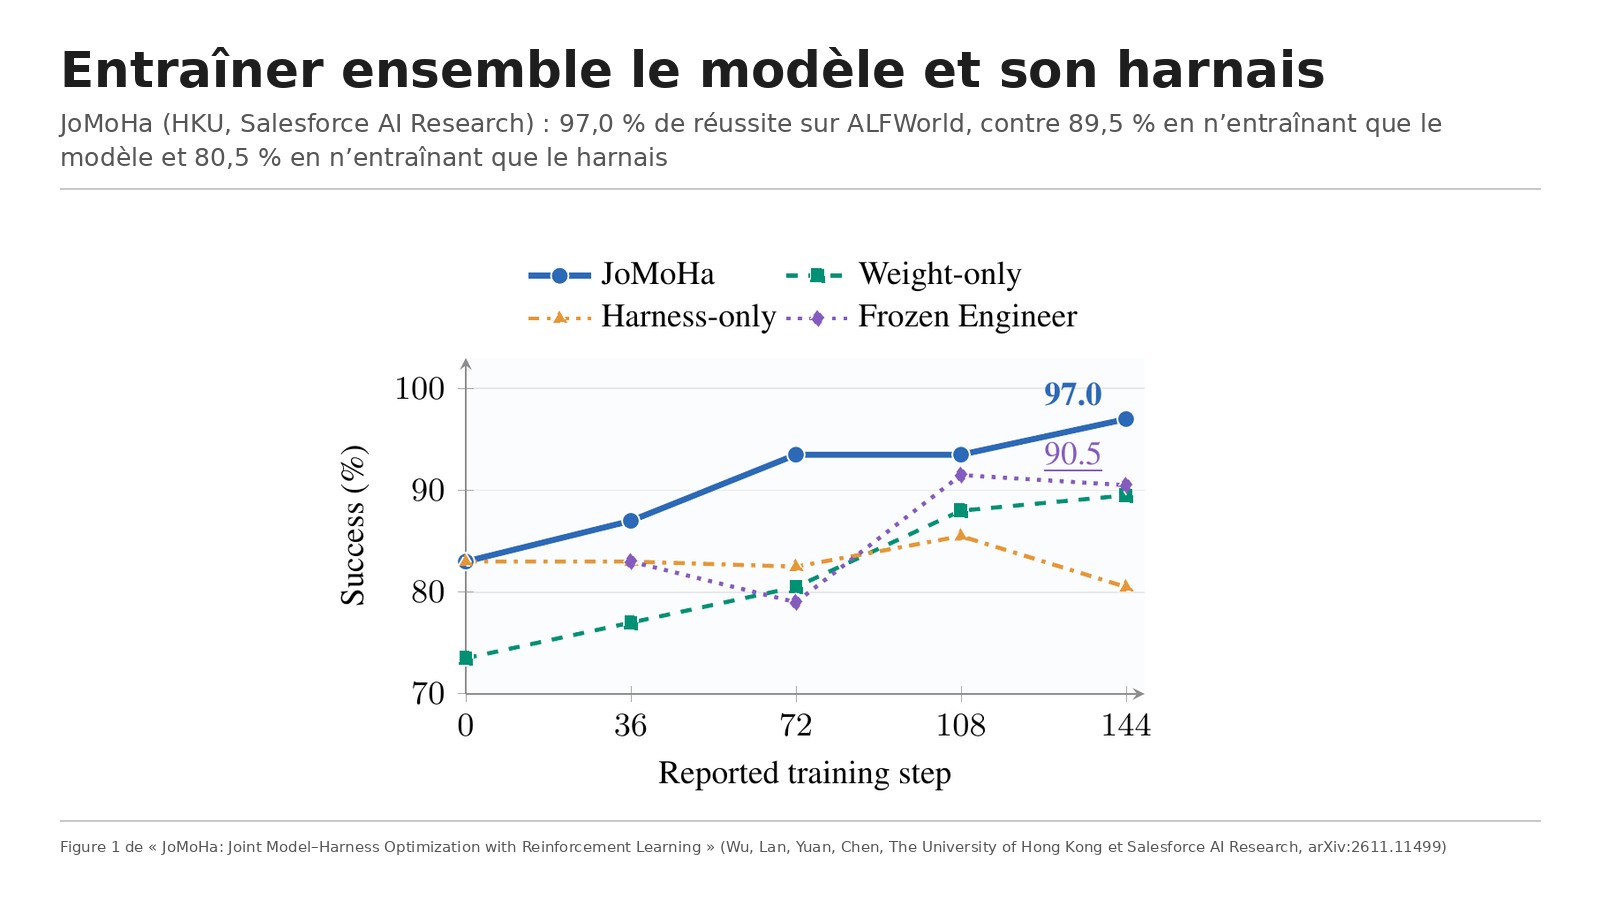
Sur ALFWorld, l’entraînement conjoint sans ces réglages atteint 88,5 %. Chaque réglage ajouté seul donne entre 91,5 % et 92,5 % ; les quatre ensemble, 97,0 %.
Les scores
Le modèle de départ est Qwen3.5-9B, pour l’ingénieur comme pour le solveur. Avec son harnais par défaut, il réussit 40,6 % sur ALFWorld, 31,2 % sur WebShop (achats en ligne simulés) et 61,0 % sur DBBench (requêtes sur des bases de données), soit 44,3 % en moyenne.
JoMoHa obtient 97,0 %, 45,8 % et 68,0 %, soit 70,3 % en moyenne, le meilleur résultat du tableau sur les trois bancs. C’est 6,1 points de plus que la meilleure méthode publiée, Harness-R1 avec un modèle affiné (64,2 %), et 7,2 points de plus que WHALE (63,1 %), qui alterne affinage du modèle et recherche de harnais par un grand modèle externe. Les harnais réécrits par six grands modèles figés, dont GPT-5.5 et DeepSeek-V4-Pro, restent entre 44,3 % et 48,8 % de moyenne.
Sur ALFWorld, les plus gros gains portent sur les tâches qui transforment un objet avant de le poser : nettoyer, chauffer, refroidir, avec 18,2, 17,3 et 24,8 points de plus que le meilleur concurrent. Ce sont justement les tâches où il faut savoir qu’une étape est terminée, le défaut repéré plus haut.
Les deux apprentissages comptent
En gardant l’ingénieur figé mais en continuant d’échantillonner de nouveaux harnais, on plafonne à 90,5 % (91,5 % au mieux). N’entraîner que le modèle donne 89,5 %, n’entraîner que le harnais 80,5 %. À modèle constant, remplacer le harnais initial par le harnais appris fait passer la réussite de 92,5 % à 96,5 %.
Les limites
Le papier ne contient pas de section consacrée aux limites. Nos réserves : un seul modèle de 9 milliards de paramètres est testé, sans répétition des entraînements ni barres d’erreur. Hormis JoMoHa et WHALE, les scores des concurrents sont repris du papier Harness-R1, pas recalculés. Les comparaisons avec l’entraînement du seul modèle ou du seul harnais, et toute l’étude de coordination, ne portent que sur ALFWorld. Les trois bancs sont des environnements simulés à récompense nette, loin des tâches ambiguës d’une entreprise. Enfin, au déploiement, on choisit un harnais et une version du solveur parmi ceux sauvegardés, sur un jeu de validation séparé.
Lecture Neurone21
La leçon la plus utile pour une entreprise est le diagnostic, plus que la méthode. Un harnais écrit pour une version d’un modèle peut nuire à la suivante : ici, un vieux harnais fait échouer un modèle qui réussissait seul. Quand on met à jour le modèle d’un agent, qu’on le réentraîne ou qu’on change de fournisseur, il faut retester le harnais avec lui, et comparer avec et sans harnais, au lieu de supposer que l’ancien code reste bon.
JoMoHa s’adresse surtout aux équipes qui adaptent elles-mêmes un modèle ouvert. Pour elles, le papier plaide pour versionner et évaluer ensemble le modèle et son harnais, comme un seul produit.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 13 novembre 2026 à 01:20 heure de Paris. Nous avons lu la version officielle arXiv 2611.11499v1. Écarts avec le post :
Le post parle d’un travail de Salesforce AI Research « et collègues » ; trois des quatre auteurs, dont l’auteur de correspondance, sont à l’université de Hong Kong, un seul chez Salesforce. Le post écrit que JoMoHa bat l’entraînement du seul modèle et celui du seul harnais sur ALFWorld, WebShop et DBBench : ces deux comparaisons ne sont mesurées que sur ALFWorld ; sur les trois bancs, JoMoHa est comparé à d’autres méthodes (Harness-R1, WHALE, harnais écrits par de grands modèles). Les chiffres de 70,3 % et 97,0 % sont exacts. Enfin, le post attribue la correction de l’incompatibilité à des historiques et des estimations de valeur séparés ; le papier la doit à quatre mécanismes combinés, dont aucun ne suffit seul.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.11499
- Le PDF : https://arxiv.org/pdf/2611.11499
- Le code : https://github.com/xudongwu-0/coevolve
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2121035321211318565
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/jomoha-joint-model-harness-optimization-with-reinforcement-learning-2611.11499
- Notre fiche sur un petit modèle entraîné à améliorer le harnais d’un agent : /p/harnais-appris-cmu
- Notre dossier sur le harnais d’agent IA : /p/harnais-agents-ia-pourquoi-comment-commencer-dossier