Titre original : MemCredit: From Relevance to Utility for Decision-Time Memory in Long-Horizon Web Agents
Auteurs : Quanjiang Guo, Sijie Wang, Qianyang Zhu, Ben Zhang, Jinchuan Zhang, Ke Yan et Zhao Kang (auteur de correspondance).
Affiliations : University of Electronic Science and Technology of China (UESTC) et Nanyang Technological University (Singapour, Sijie Wang).
Publication : prépublication arXiv 2611.15600v1 (cs.AI), déposée le 11 novembre 2026, mise en page pour la conférence WWW ’27 (Dublin) sans que l’acceptation soit indiquée. Aucun code publié n’est mentionné.
Liens : page arXiv, PDF.
L’idée en bref
Un agent qui travaille longtemps accumule un historique trop long pour tenir dans son contexte. La plupart des systèmes de mémoire choisissent alors les souvenirs qui ressemblent le plus à la situation présente : les plus récents, ou les plus proches par les mots (BM25) ou par le sens (recherche dense). Les auteurs posent une autre question : l’agent prendrait-il une moins bonne décision si ce souvenir lui manquait ?
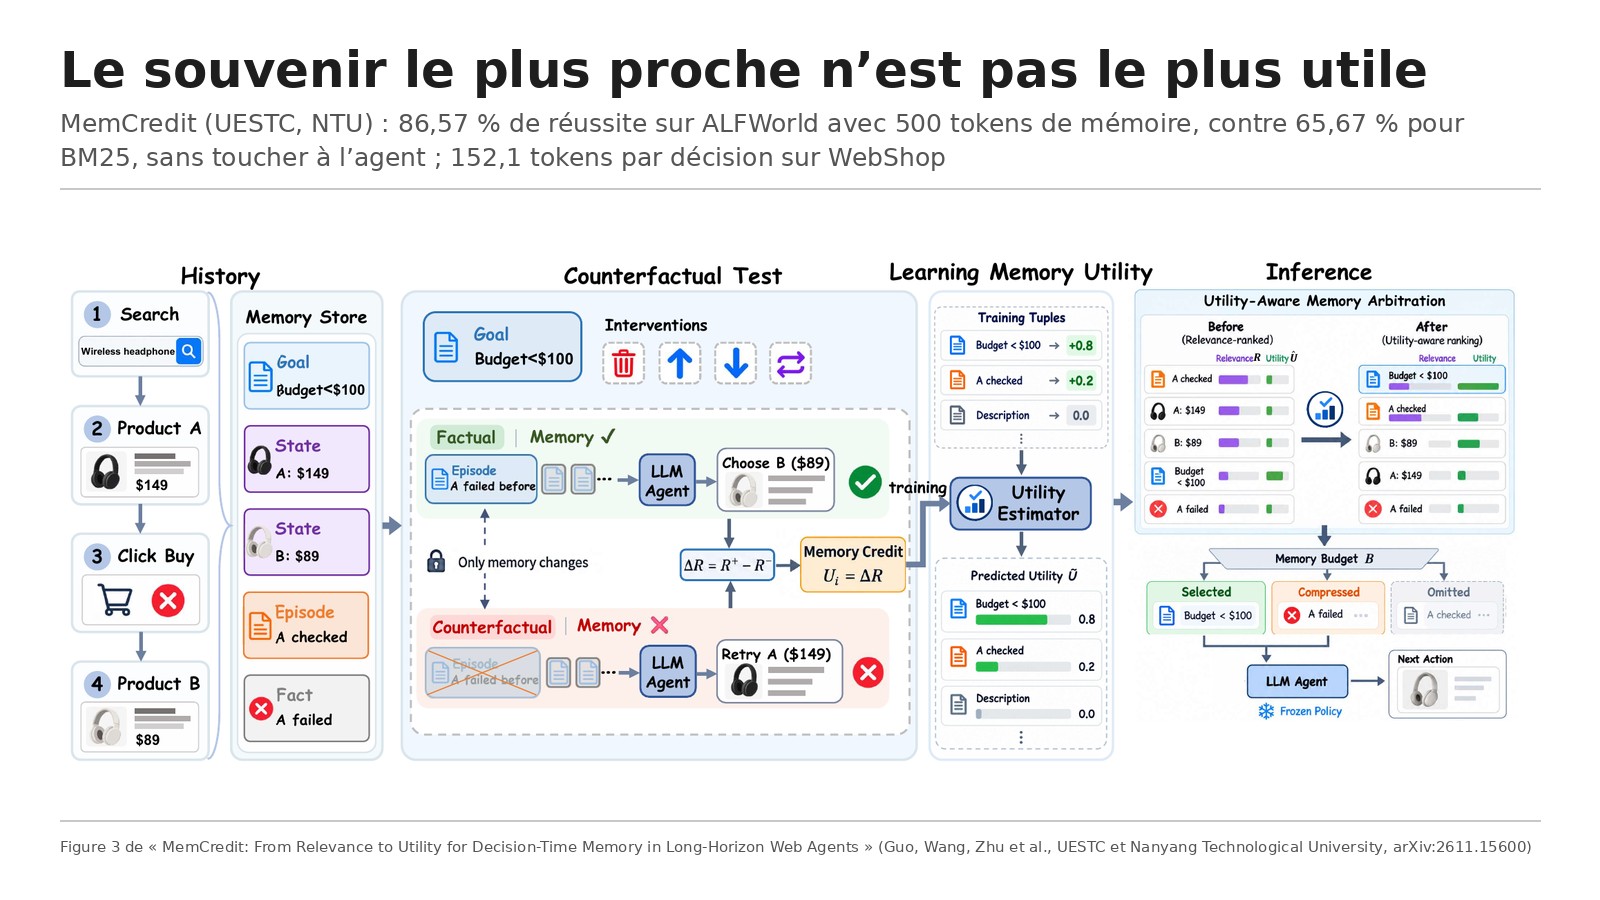
Leur exemple est un achat en ligne. L’agent cherche un casque à moins de 100 dollars. Le souvenir le plus proche de la page affichée, « le produit A est à réduction de bruit », ne l’aide pas. Celui qui compte, « budget inférieur à 100 dollars », ressemble moins à la page, mais c’est lui qui évite d’acheter le produit A à 149 dollars.
MemCredit procède en trois temps. Hors ligne, on rejoue la même décision depuis le même état de l’environnement, une fois avec un souvenir et une fois sans, et l’écart de résultat donne le « crédit » de ce souvenir. Un petit modèle (une forêt d’arbres ExtraTrees, 300 arbres) apprend ensuite à prédire ce crédit à partir d’indices disponibles au moment de décider. En service, la recherche classique ramène une large liste de candidats, puis l’estimateur choisit ceux qui entrent dans le budget de tokens, au meilleur crédit par token ajouté. L’agent lui-même n’est ni réentraîné ni modifié, et aucune interaction supplémentaire avec l’environnement n’est nécessaire.
Ce que montre le papier
La plupart des souvenirs ne changent rien
Sur 1 041 expériences avec et sans un souvenir, tirées de 45 tâches ALFWorld (tâches ménagères en mode texte), 86,9 % ne produisent aucun changement mesurable. Le crédit moyen est de 0,054. Il monte à 0,176 juste après un échec et tombe à 0,029 ailleurs : un souvenir compte surtout quand l’agent vient de se tromper. Surtout, la proximité sémantique ne dit presque rien de l’utilité : la corrélation de rang entre les deux vaut −0,011 sur l’ensemble, −0,191 sur un sous-ensemble de 11 tâches et +0,135 sur un autre de 44 tâches. Elle change même de signe selon les tâches retenues.
Sur ALFWorld, 21 points de plus que BM25 avec un budget serré
Sur les 134 tâches de test d’ALFWorld, avec le modèle Qwen3.6-27B-FP8 comme agent et 50 actions au plus par tâche, MemCredit réussit 86,57 % des tâches avec 500 tokens d’historique, contre 65,67 % pour BM25 (20,90 points d’écart), 71,64 % pour la recherche dense et 82,84 % pour MemArbiter, la meilleure méthode de référence. Le gain est le plus net sur les tâches où il faut se souvenir d’une étape passée : chauffer, refroidir, prendre deux objets (respectivement 30,43, 28,57 et 35,30 points de plus que BM25). Avec 750 tokens, MemCredit atteint 90,30 %, contre 81,34 % pour BM25 et 85,82 % pour MemArbiter : l’écart avec BM25 tombe à 8,96 points. Plus le budget est serré, plus le tri compte. L’agent répète aussi moins ses actions ratées (16,4 % contre 38,5 % avec BM25 à 500 tokens).
Sur WebShop, plus de réussite avec près de quatre fois moins de mémoire
Sur 200 tâches d’achat simulées dans un catalogue de 10 000 produits, MemCredit obtient le meilleur score officiel, 0,612, contre 0,586 pour MemArbiter et 0,407 pour BM25. Il n’utilise que 152,1 tokens de mémoire par décision, contre 427,6 pour MemArbiter et 597,0 pour BM25, soit 64,4 % et 74,5 % de moins. Les recherches répétées, les actions invalides et la longueur des parcours baissent légèrement.
L’utilité se prédit, mais imparfaitement
Avec seulement des indices de proximité et d’ancienneté, l’estimateur ne fait pas mieux que le hasard (AUROC 0,483). Avec tous les indices, dont ce qui est déjà présent dans la mémoire retenue, il atteint une corrélation de rang de 0,220 et une AUROC de 0,744. C’est modeste, et les auteurs le disent : l’estimateur sert à classer, pas à mesurer précisément. Dans l’ablation, mélanger moitié proximité, moitié utilité donne 78,36 %, moins bien que l’utilité seule (84,33 %). La proximité sert donc à ramener des candidats, pas à trancher. Avec d’autres agents (Qwen2.5-7B-Instruct, DeepSeek-V3, GPT-5.4), MemCredit garde l’avantage presque partout, à une exception près : avec GPT-5.4, BM25 fait légèrement mieux sur le taux de réussite à 50 actions.
Les limites
Les auteurs en citent plusieurs. Le tri pas à pas ne garantit pas le meilleur ensemble de souvenirs et peut manquer deux souvenirs utiles seulement ensemble. La prédiction de l’utilité reste imparfaite. Les scores WebShop ne sont pas comparables à ceux publiés sur le catalogue complet, puisqu’il s’agit d’un sous-catalogue de 10 000 produits. D’une exécution à l’autre, le taux de réussite global varie jusqu’à 3 points, à cause du calcul non déterministe sur GPU.
Nos réserves : les crédits ne sont mesurés que sur 45 tâches ALFWorld, chaque paire n’étant jouée qu’une fois, et l’analyse de la proximité contre l’utilité ne porte que sur ce jeu. La configuration finale, sans les indices explicites d’échec, est l’une des variantes de l’ablation rapportées sur les 134 tâches de test, même si les auteurs affirment n’avoir fait aucun réglage a posteriori. Face à la référence la plus forte, MemArbiter, le gain n’est que de 3,73 points à 500 tokens et de 4,48 points à 750 tokens, soit à peine plus que la variabilité annoncée d’une exécution à l’autre. Les résultats principaux reposent sur un seul modèle d’agent, deux environnements simulés, et aucun code n’est publié.
Lecture Neurone21
Pour qui construit un agent métier, la leçon est simple : un système de mémoire ne se juge pas à la pertinence de ce qu’il ramène, mais à ce qu’il change aux décisions. Le test est accessible : rejouer quelques dizaines de décisions enregistrées avec et sans chaque souvenir, et regarder si l’action change. Le papier montre que l’essentiel du contexte injecté ne sert à rien, et que les souvenirs qui comptent sont souvent ceux qui gardent trace d’une contrainte ou d’un échec, pas ceux qui ressemblent à l’écran du moment. Moins de mémoire bien choisie, c’est aussi des appels moins chers. Le gain face aux meilleures méthodes structurées reste cependant de quelques points : avant d’adopter MemCredit, mieux vaut mesurer sur ses propres tâches.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 14 novembre 2026 à 15:26 heure de Paris. Nous avons lu la version officielle arXiv 2611.15600v1. Écarts avec le post :
Les chiffres ALFWorld du post sont exacts : 86,57 % de réussite avec 500 tokens de mémoire, contre 65,67 % pour BM25, et l’agent n’est pas modifié. En revanche, le post place les 152,1 tokens de mémoire par décision et la baisse de 74,5 % par rapport à BM25 sur ALFWorld : dans le papier, ces deux chiffres viennent de WebShop. Le post ne compare MemCredit qu’à BM25 et ne cite pas MemArbiter, la meilleure référence, nettement plus proche (82,84 % sur ALFWorld à 500 tokens). « La plupart des souvenirs récupérés n’ont aucun effet » correspond aux 86,9 % d’expériences sans changement mesurable, sur 45 tâches ALFWorld seulement. Enfin, le crédit ne mesure pas un changement d’action, comme le suggère le post, mais l’écart de récompense entre les deux versions rejouées.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.15600
- Le PDF : https://arxiv.org/pdf/2611.15600
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2121610612040220832
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/memcredit-from-relevance-to-utility-for-decision-time-memory-in-long-horizon-web-2611.15600
- Notre fiche sur un RAG simple qui devance la mémoire agentique : /p/rag-brut-bat-memoire-agentique-conversations
- Notre fiche sur SoMem, une mémoire rangée par l’agent lui-même : /p/somem-memoire-auto-organisee-agents
- Notre fiche sur RIME, un modèle entraîné à écrire sa mémoire : /p/rime-memoire-agents-apprentissage-continu-cmu
- Notre fiche sur les modèles de décision comme juges et professeurs : /p/modeles-decision-acteur-juge-professeur-agents