Titre original : AutoRL: A Multi-Agent System towards Autonomous Reinforcement Learning
Auteurs : Simon Tang, Wenjie Shi (auteur correspondant), Yongjing Yin, Keheng Wang, Jialin Liu, Zheng Zhang, Linvo Lin, Xiangyuan Xue, Kan Ren, Jingang Wang et Xunliang Cai.
Affiliations : Meituan (l’équipe des modèles LongCat), avec The Chinese University of Hong Kong, ShanghaiTech University et Fudan University.
Publication : prépublication déposée sur arXiv le 13 novembre 2026 (2611.17790v1, cs.AI, 23 pages). Pas de relecture par des pairs à cette date, et ni code ni journaux d’agents publiés avec le papier.
Liens : page arXiv, PDF.
L’idée en bref
Un apprentissage par renforcement (RL) sur un grand modèle ne se lance pas puis s’oublie. La récompense peut être mal calculée, les courbes peuvent stagner, des valeurs numériques peuvent exploser au milieu de la nuit. Dans les laboratoires, un chercheur garde un œil dessus en permanence : il lit des réponses générées, corrige le correcteur automatique, ajuste un coefficient, relance depuis un point de sauvegarde.
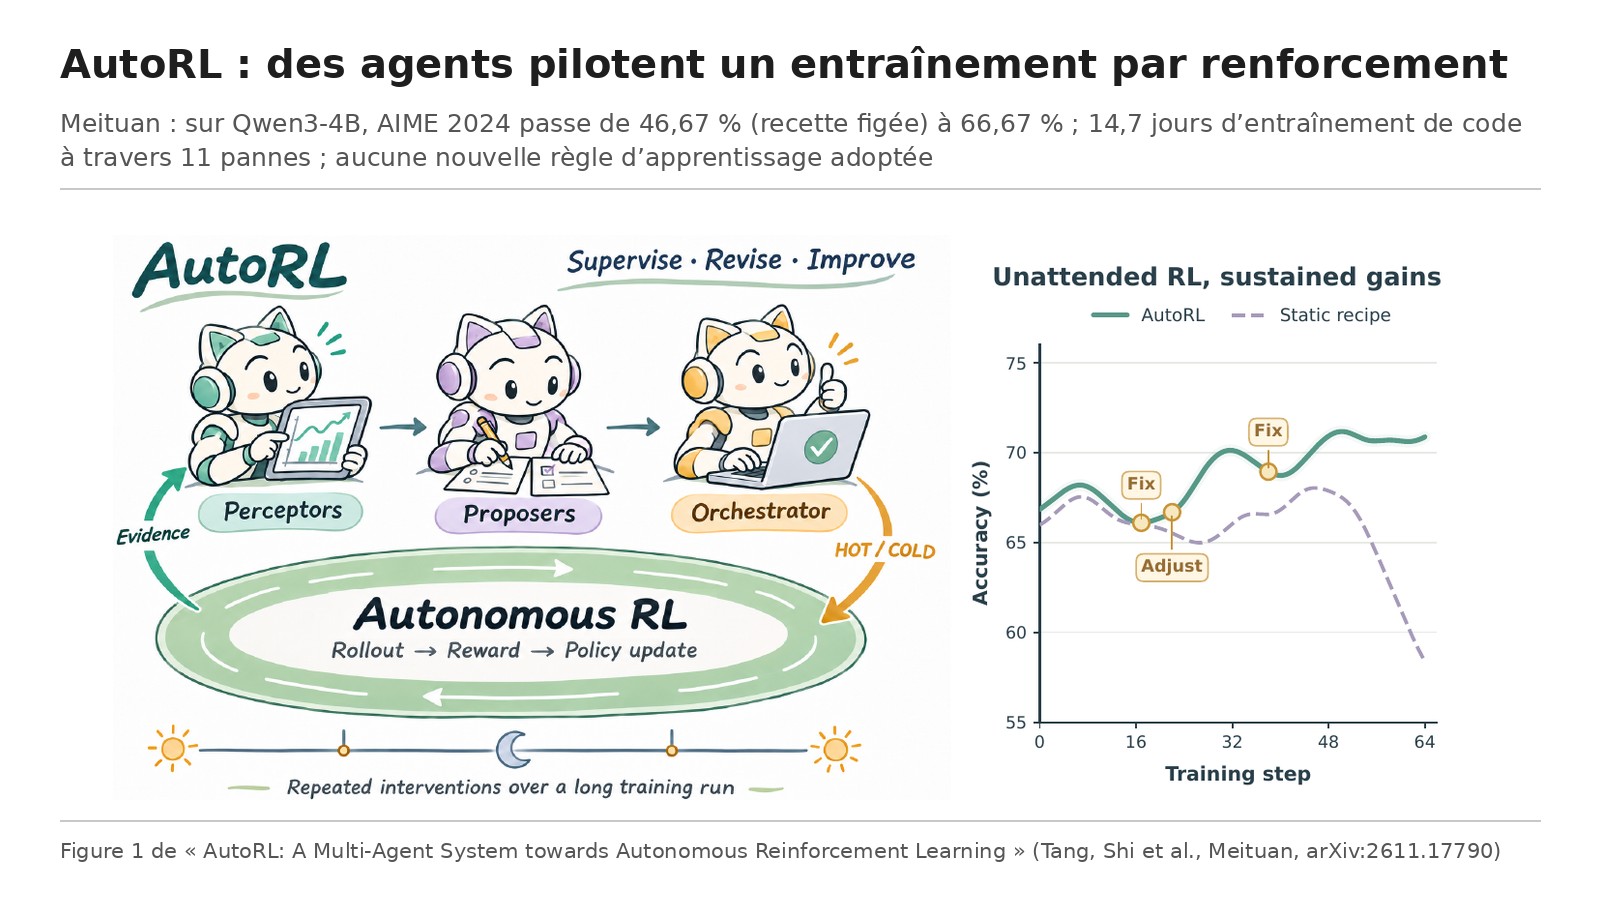
Les systèmes d’« entraînement autonome » existants travaillent plutôt d’expérience en expérience : un run complet, une analyse, une nouvelle recette. AutoRL fait l’inverse : il agit pendant le run. L’équipe découpe le travail du chercheur en rôles. Quatre observateurs (Perceptors) suivent l’optimisation, les réponses générées, les évaluations et l’efficacité, et lèvent une alerte en cas d’anomalie, de dégradation ou de plateau. Trois proposeurs étudient alors le problème : le Tuner propose des réglages de la recette, l’Innovator cherche d’autres mécanismes, le Reviewer traque les erreurs d’implémentation et les hypothèses non étayées. Ils peuvent faire des vérifications sur CPU, sans GPU, avant de converger. Un orchestrateur décide enfin s’il applique la proposition, à chaud quand c’est possible (HOT), ou en arrêtant puis en repartant d’un point de sauvegarde compatible (COLD). Une mémoire commune garde la trace des décisions et de leurs raisons.
Ce que montre le papier
Une recette pilotée bat la même recette figée
Sur des problèmes de mathématiques (DAPO-Math-17K, 17 390 problèmes), l’équipe entraîne Qwen3-1.7B et Qwen3-4B avec une recette GRPO classique. Elle compare trois situations : la recette figée, la même recette confiée à un agent généraliste (Codex avec tous ses outils) et AutoRL. Les deux systèmes d’agents s’appuient sur le même modèle, gpt-6.1-sol. Chaque question est évaluée quatre fois.
Sur Qwen3-4B, AutoRL fait mieux que la recette figée sur les neuf bancs d’essai. AIME 2024 passe de 46,67 % (recette figée) à 66,67 %, pour 25,00 % au modèle de départ et 50,00 % avec l’agent généraliste. AIME 2025 monte de 45,00 % à 56,67 %, HMMT 2025 de 20,00 % à 31,67 %, Beyond AIME de 26,00 % à 32,50 % et IMO-AnswerBench de 27,00 % à 36,75 %. Le gain déborde des mathématiques, mais il est plus mince : de 1 à 2,5 points sur MMLU-Pro (59,73 %), GPQA-Diamond (47,22 %), MBPP (65,25 %) et LiveCodeBench v6 Hard (6,79 %). Sur Qwen3-1.7B, le tableau est moins net : l’agent généraliste reste devant sur AIME 2024 (31,67 % contre 30,00 %) et sur IMO-AnswerBench, et HMMT 2025 est à égalité avec la recette figée (18,33 %).
Réparer une recette mal partie, sortir d’un plateau
Deuxième expérience : un réglage volontairement fragile sur LongCat-Flash-Lite (le modèle maison de Meituan), avec un correcteur de réponses simpliste, sans régularisation KL et des réponses jusqu’à 131 072 tokens. Le run démarre bien puis se dégrade. La version figée tombe à 56,05 % ; AutoRL, parti de 65,53 %, atteint 73,16 % au pas 64, soit 17,11 points d’écart. Sur six interventions, quatre corrigent le correcteur (correspondance des options, réponses en plusieurs parties, LaTeX, unités), deux ajoutent puis renforcent la régularisation KL (0,001 puis 0,01). Aucun redémarrage n’a été nécessaire.
Sur Qwen3-4B, AutoRL laisse aussi la recette inchangée pendant 100 pas de plateau, en observant et en discutant. Il corrige ensuite le correcteur (pas 101), monte progressivement le coefficient d’entropie de 0,001 à 0,004 et pénalise légèrement les réponses fausses qui tournent en boucle. La précision franchit le plateau (29,74 % au mieux) et culmine à 41,58 % au pas 180, contre 31,32 % au mieux pour la recette figée.
Quinze jours d’entraînement sans surveillance humaine
Troisième expérience : un agent de code entraîné par RL sur LongCat-Flash-Lite, 352,5 heures (14,7 jours) sur 224 GPU H800, avec plus de 700 tâches privées de génie logiciel et jusqu’à 400 tours d’interaction par tâche. Le run subit 11 pannes : sept valeurs numériques invalides (NaN), une incompatibilité de types et trois pannes de machines ou de communication. AutoRL repart à chaque fois d’un point de sauvegarde valide, resserre l’écrêtage, baisse le taux d’apprentissage de 5 × 10⁻⁶ à 2 × 10⁻⁶ et passe certains calculs en précision FP32. Une de ses corrections provoque d’ailleurs une nouvelle panne, qu’il annule en gardant le reste. Le taux de réussite au premier essai sur des tâches de type SWE passe de 52,29 % à un pic de 65,13 % (pas 55) et finit à 63,20 %.
Face à un agent généraliste
À budget égal de 273 pas d’entraînement, AutoRL atteint 41,58 % contre 32,11 % pour Codex. Il génère 131 idées contre 21, en applique 20 et en retire 4 (20 %), quand Codex en applique 6 et en retire 3 (50 %). Codex revient quatre fois en arrière et repasse sur 122 de ses 273 pas (44,7 %), alors qu’AutoRL n’en repasse aucun : 17 de ses 20 changements se font à chaud. Avec GLM-5.2 à la place de gpt-6.1-sol, AutoRL tombe à 32,89 % au mieux, toujours devant Codex mais 8,69 points sous la version GPT : le modèle qui pilote les agents pèse lourd.
Ce que les agents ne font pas
Les auteurs ont classé les 131 idées de la campagne Qwen3-4B. Près de 84 % (110) portent sur la correction du signal d’apprentissage : correcteur, réponses de référence, données. Les 20 plans déployés sont des corrections de notation ou de données (10), des réglages de paramètres (9) et un ajustement de récompense (1). Trois idées seulement (2,3 %) proposaient une nouvelle règle d’apprentissage ; aucune n’a été adoptée. Conclusion des auteurs : les agents savent déjà surveiller, régler et réparer, mais ils n’ont produit aucune percée méthodologique dans ces expériences.
Les limites
Les auteurs le disent eux-mêmes : les agents améliorent une recette existante sans en inventer une autre, et valider une idée coûte cher en calcul. Ils ne prétendent pas qu’AutoRL soit la seule organisation possible.
Nos réserves : chaque configuration semble n’avoir été entraînée qu’une fois ; aucune répétition avec plusieurs graines n’est rapportée, alors qu’un écart de 20 points sur AIME 2024 représente six questions sur trente. L’expérience de quinze jours n’a pas de témoin avec une recette figée : on sait que le run a survécu, pas ce qu’une équipe humaine aurait obtenu. Les données LongCat et les tâches de code sont privées, et ni le code d’AutoRL ni ses journaux ne sont publiés. Le coût des agents eux-mêmes (appels à gpt-6.1-sol) n’est pas chiffré. Enfin, la recette « fragile » de LongCat a été construite pour mal tourner : elle illustre la réparation, elle ne mesure pas un gain sur une recette déjà bien réglée.
Lecture Neurone21
Pour une entreprise qui entraîne ou ajuste un modèle métier, la leçon la plus utile est la répartition des erreurs : l’essentiel des idées utiles portait sur la qualité du signal (un correcteur qui note mal, une réponse de référence fausse), pas sur l’algorithme. Mettre un agent devant les courbes et les réponses générées, avec le droit de proposer et un humain ou un orchestrateur pour valider, est déjà réaliste. Lui demander de trouver la prochaine méthode d’entraînement ne l’est pas encore. Et les chiffres rappellent que le choix du modèle qui pilote les agents pèse lourd sur le résultat.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a présenté le 16 novembre 2026 à 21:40 heure de Paris (20:40 UTC), puis a reposté son propre post le 17 novembre 2026 à 09:40 heure de Paris. Nous avons lu la version officielle arXiv 2611.17790v1. Écarts avec le post :
Les chiffres cités existent bien dans le papier (46,67 % à 66,67 % sur AIME 2024, +11,67 points sur AIME 2025 et HMMT 2025, 52,29 % à 65,13 % sur le code). Mais le point de départ de 46,67 % n’est pas « Qwen3 » brut : c’est Qwen3-4B déjà entraîné avec la recette figée ; le modèle de départ fait 25,00 %. Le résultat ne vaut que pour la version 4B ; sur Qwen3-1.7B, l’agent généraliste reste devant sur AIME 2024. Les 65,13 % sur le code sont un pic : le run finit à 63,20 %, sans run témoin pour comparer. Enfin, la « recette volontairement cassée » est un réglage fragile (correcteur simpliste, sans régularisation KL) qui ne s’effondre qu’en cours de route.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.17790
- Le PDF : https://arxiv.org/pdf/2611.17790
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2122429507756069008
- Chat with Paper (DAIR.AI Academy) : https://academy.dair.ai/papers/autorl-a-multi-agent-system-towards-autonomous-reinforcement-learning-2611.17790
- Notre fiche sur RSI-Dojo, des agents entraînés à post-entraîner d’autres modèles : /p/rsi-dojo-agents-post-entrainement-modeles
- Notre fiche sur des agents dans un pré-entraînement complet chez SII et Xinxu AI : /p/rsi-pre-entrainement-801-30b-sii-xinxu
- Notre fiche sur PostTrainBench, qui mesure des agents chargés du post-entraînement : /p/posttrainbench-agents-post-entrainement-triche