Titre original : EMMA: Structured Episodic Memory for Multi-Agent Workflow Synthesis
Auteurs : Ruijia Niu (université de Californie à San Diego, travail réalisé en stage chez Amazon), Kaiwen Liu (Amazon), Rose Yu (université de Californie à San Diego, travail réalisé comme Amazon Scholar ; elle n’est plus affiliée à Amazon) et Kristina Klinkner (Amazon).
Publication : prépublication arXiv 2610.35966v1 (cs.MA), déposée le 25 octobre 2026, 19 pages avec les annexes.
Liens : page arXiv, PDF.
L’idée en bref
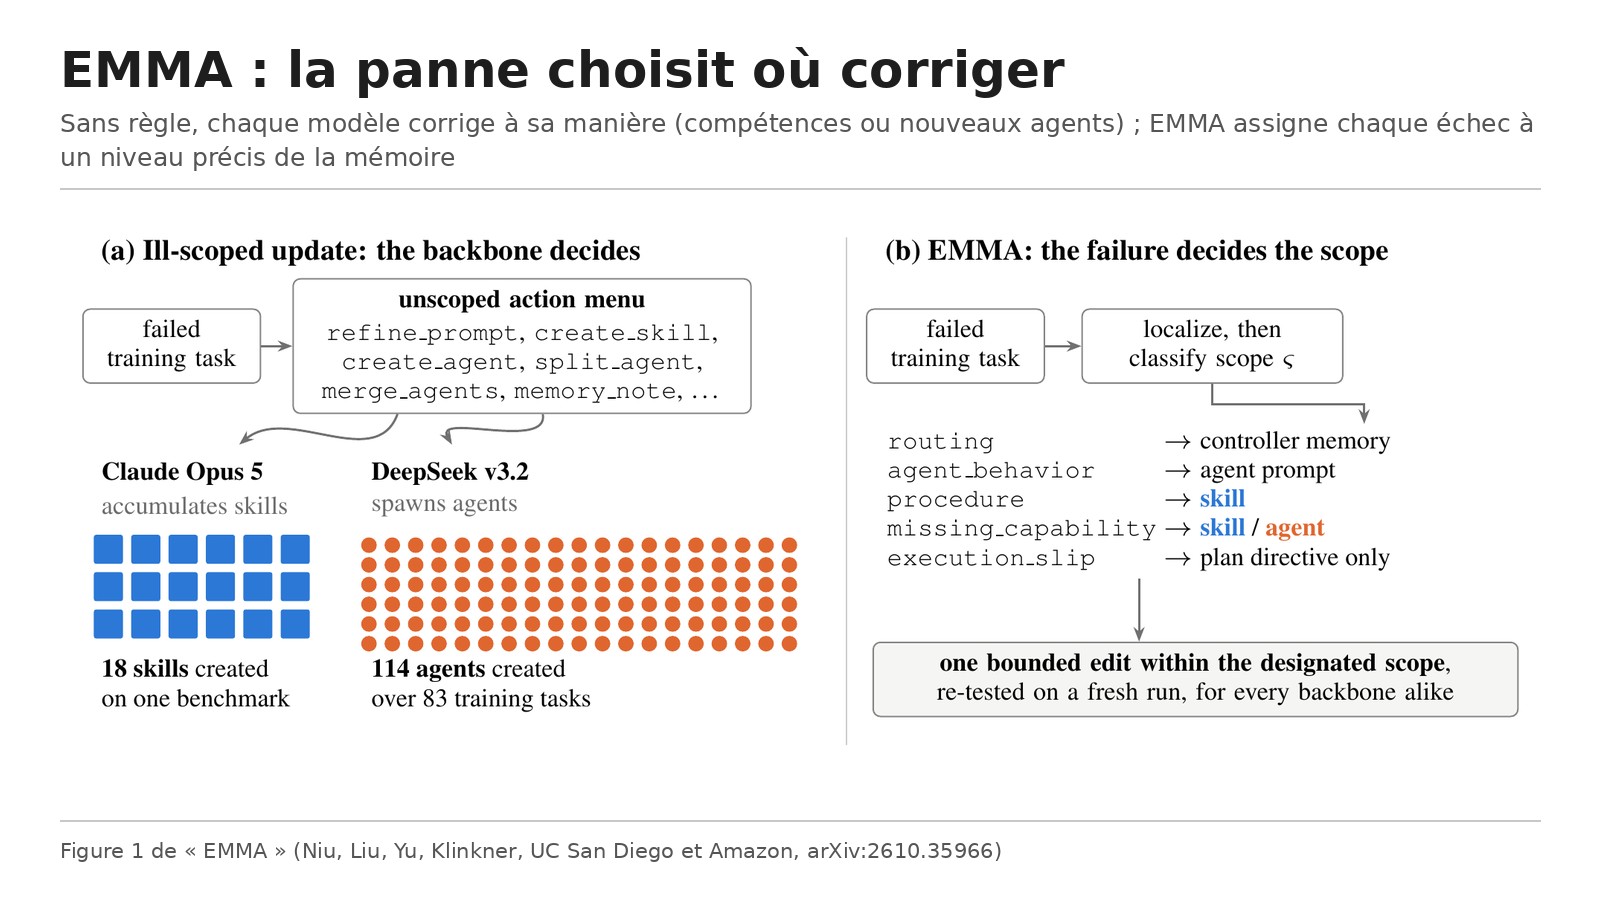
Un système multi-agents qui « s’améliore tout seul » apprend en général ainsi : après un échec, on demande au modèle ce qu’il faut changer, et il peut tout modifier, réécrire une consigne, créer une compétence, ajouter un agent, fusionner deux agents. Les auteurs montrent que le choix du type de correction dépend alors surtout des habitudes du modèle, pas de la nature de l’erreur. Dans leur figure 1, Claude Opus 5 accumule 18 compétences sur un banc d’essai, tandis que DeepSeek v3.2 crée 114 agents sur 83 tâches d’entraînement.
EMMA (structured Episodic Memory for Multi-Agent workflow synthesis) inverse la logique : c’est l’échec qui décide où corriger. La configuration du système est traitée comme une mémoire épisodique à trois niveaux, et chaque erreur diagnostiquée ne peut modifier que le niveau qui en est responsable, par une seule correction, testée aussitôt (sections 1 et 3).
Ce que montre le papier
Une mémoire à trois niveaux
La mémoire comprend une mémoire du contrôleur (comment découper une tâche, quel agent et quelles compétences appeler, quand vérifier), un ensemble d’agents et un ensemble de compétences, c’est-à-dire de courtes procédures pour une classe de sous-problèmes. L’entraînement part d’un seul agent généraliste ; chaque agent spécialisé créé ensuite hérite de la consigne courante du généraliste, si bien qu’une bonne habitude écrite une fois se propage à tous les spécialistes (section 3.1.1).
Cinq types d’échecs, cinq endroits où corriger
Après un échec, un module de réflexion lit toute la trajectoire (plan, code exécuté par chaque agent, explication de l’évaluateur, historique des corrections) et classe l’erreur dans l’une de cinq catégories (tableau 1). Une simple étourderie ne modifie que le plan de la tâche en cours et n’est jamais mémorisée. Une mauvaise habitude de travail corrige la consigne d’un agent. Une méthode fausse ou absente crée ou révise une compétence. Une capacité manquante crée une compétence, puis un agent si besoin. Un mauvais découpage ou un mauvais aiguillage ajoute une règle dans la mémoire du contrôleur (section 3.2.1).
Des garde-fous indépendants du modèle
La correction proposée n’est appliquée que si elle passe des contrôles programmés, identiques quel que soit le modèle : l’action doit correspondre au type d’erreur, une consigne modifiée doit conserver l’essentiel de l’existant, la mémoire reste de taille bornée, aucune réponse attendue ne doit fuir dans la mémoire, et la stratégie doit changer après deux révisions infructueuses au même niveau. L’entraînement fait un seul passage sur les tâches, puis la mémoire est figée pour les tests (sections 3.2.2 et 3.3).
Les résultats
Les auteurs testent EMMA sur trois bancs d’essai : KramaBench (analyse de données scientifiques, 28 tâches d’entraînement et 76 de test), AppWorld (tâches à travers neuf applications via leurs API, avec un jeu « challenge » qui exige une application jamais vue à l’entraînement) et BBEH-mini (raisonnement, 92 exemples d’entraînement et 368 de test). Cinq modèles servent de moteur : Claude Opus 5 et Sonnet 5, GLM-5, DeepSeek v3.2 et Kimi-K2.5. Les méthodes comparées sont ACE, GEPA, EvoMAS et ADAS (section 5.1).
EMMA obtient la meilleure moyenne partout : 0,654 sur KramaBench contre 0,584 pour GEPA, 0,663 sur BBEH-mini contre 0,605 pour GEPA, et sur AppWorld normal 84,2 % de tâches réussies et 71,0 % de scénarios complets, contre 72,3 % et 53,6 % pour ACE. Sur AppWorld challenge, l’écart est plus faible : 73,8 et 56,0 contre 67,4 et 50,7. EMMA arrive premier dans 17 des 20 combinaisons banc d’essai et modèle, et deuxième dans les trois autres (section 5.2, tableaux 2 et 3).
Le point le plus intéressant concerne les modèles ouverts. Avec Claude Opus 5, EvoMAS et ADAS sont presque au niveau d’EMMA sur AppWorld challenge (89,0 et 84,4 contre 89,2). Mais avec GLM-5, EvoMAS tombe à 7,2, et avec DeepSeek v3.2, ADAS tombe à 0,5. EMMA, lui, ne descend jamais sous 61,2 sur ce jeu (section 5.2.1).
EMMA demande aussi moins d’exécutions pendant l’entraînement : en moyenne 61,8 sur KramaBench, 159,6 sur BBEH-mini et 127,8 sur AppWorld, soit 17 à 38 % de moins que la méthode concurrente la plus économe (tableau 4).
Ce qui compte vraiment, d’après les ablations
Sur KramaBench avec Claude Opus 4.5, sans apprendre ni agents ni compétences, le score est de 0,506 ; apprendre les compétences le porte à 0,591 ; apprendre aussi les agents donne 0,647. Les méthodes qui s’adaptent seulement pendant le test restent nettement en dessous (de 0,443 pour DACode à 0,535 pour DeepResearch de smolagents) (section 5.3 et tableau 5).
Les limites
Les auteurs reconnaissent que (section 6) :
- EMMA réduit l’écart entre familles de modèles sans le supprimer ;
- une correction acceptée reste en mémoire même si la tâche n’est finalement pas résolue ; ils n’ont pas observé de dégradation systématique, mais des entrées inutiles ou nuisibles peuvent subsister.
Réserves de notre lecture, tirées du papier :
- Les jeux d’entraînement sont petits (28 à 92 tâches), et chaque mémoire est apprise en un seul passage, sans choix du meilleur point de sauvegarde : les écarts reposent sur peu de tâches par banc d’essai.
- La contribution propre de la mémoire du contrôleur n’est pas mesurée, puisqu’elle est apprise dans toutes les variantes de l’ablation, ce que les auteurs signalent eux-mêmes.
- Avec le modèle le plus fort, l’avantage devient mince (0,2 point sur AppWorld challenge avec Claude Opus 5) : l’intérêt principal d’EMMA est la stabilité d’un modèle à l’autre, pas un gain spectaculaire avec le meilleur modèle.
- Le papier ne mentionne pas de publication du code.
Lecture Neurone21
Pour une entreprise qui fait tourner des agents sur ses propres processus, l’idée centrale est très applicable, même sans reprendre EMMA tel quel : ne laissez pas un modèle réécrire librement son système après chaque erreur. Décidez à l’avance où chaque type de leçon doit être rangé (une règle de répartition des tâches, la consigne d’un agent, une fiche méthode), autorisez une seule modification par échec, testez-la tout de suite, et plafonnez la taille de la mémoire. C’est la même discipline qu’une équipe qualité qui classe un incident avant de modifier une procédure.
Le second enseignement concerne le choix du modèle. Les méthodes qui laissent le modèle tout reconfigurer s’effondrent avec certains modèles ouverts, alors qu’un cadre strict garde des résultats corrects. Pour une entreprise qui veut faire tourner ses agents sur un modèle ouvert hébergé en interne, pour des raisons de coût ou de confidentialité, c’est un argument fort pour encadrer l’apprentissage plutôt que de compter sur la qualité du modèle. Sur la mémoire des agents, voir aussi notre fiche sur la taxe de la mémoire des agents.
Le post d’Elvis Saravia est fidèle au papier. Deux précisions toutefois : « Amazon and colleagues » désigne une équipe mixte université de Californie à San Diego et Amazon, dont le premier auteur était stagiaire chez Amazon ; et le gain « jusqu’à 32,5 % » repris du résumé est un gain relatif (71,0 contre 53,6 de scénarios complets sur AppWorld normal), soit 17,4 points.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.35966
- Le PDF : https://arxiv.org/pdf/2610.35966v1
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115438189901181296
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/emma-structured-episodic-memory-for-multi-agent-workflow-synthesis-2610.35966