Titre original : QDA: Closed-Loop LLM Quantization Design with Agents
Auteurs : Xingyang Li et Tianlang Zhao (contribution égale), Song Han et Ligeng Zhu.
Affiliations : MIT et NVIDIA. Le papier cite les deux institutions sans préciser le rattachement de chaque auteur.
Publication : prépublication déposée sur arXiv le 17 novembre 2026 (2611.23388v1, 19 pages). Les auteurs annoncent la publication de la bibliothèque, de l’évaluateur et du harnais ; aucun dépôt de code n’est indiqué dans le papier à ce jour.
Liens : page arXiv, PDF.
L’idée en bref
Pour servir un grand modèle de langage moins cher, on le quantifie : on stocke ses poids, et parfois ses activations, sur 3, 4 ou 8 bits au lieu de 16. Il existe des dizaines de méthodes publiques pour le faire (GPTQ, AWQ, rotations de Hadamard, distillation des échelles, choix des données de calibration), et on obtient souvent le meilleur résultat en les empilant. Une « recette », c’est cet empilement avec ses réglages et ses données.
Le constat de départ des auteurs : la meilleure recette change d’un modèle à l’autre et d’une précision à l’autre. Sur Qwen3.5-9B, AWQ fait 5,1 points de mieux que GPTQ en 4 bits, mais 12,3 points de moins en 3 bits. Les experts redessinent donc une recette à la main pour chaque nouveau modèle ; NVIDIA tient ainsi une recette écrite à la main pour chacun de 28 modèles dans son outil ModelOpt. Avec plus de 90 modèles ouverts de plus de 10 milliards de paramètres publiés entre octobre 2025 et septembre 2026, cela ne passe pas à l’échelle.
QDA confie ce travail à un agent de code (Claude Code avec Claude Opus 5.5 dans les expériences), qui propose une recette, la fait construire, la fait noter, recommence, et rend à la fin le checkpoint qu’il juge le meilleur.
Ce que montre le papier
Le problème : une évaluation complète coûte des dizaines de GPU-heures
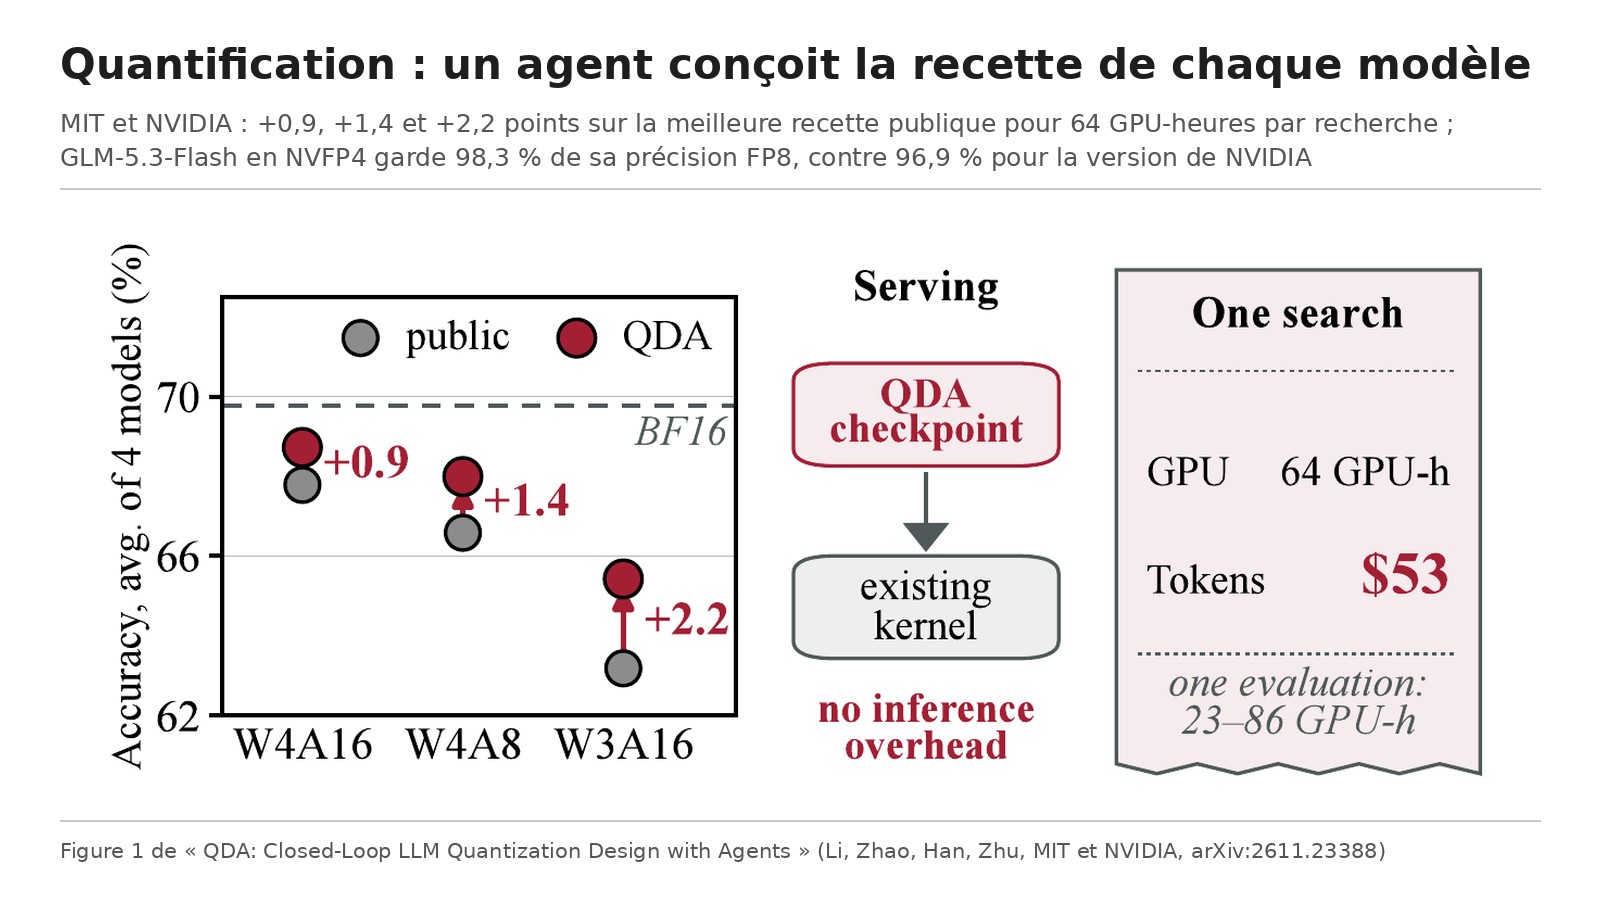
Un modèle de raisonnement écrit des milliers de tokens par réponse, et il faut échantillonner chaque problème plusieurs fois pour une mesure fiable. Évaluer un seul checkpoint quantifié prend 23 GPU-heures sur DeepSeek-R1-Distill-Llama-8B et 60 à 86 GPU-heures sur les modèles Qwen étudiés. À ce prix, une recherche ne pourrait tester que quelques candidats.
La solution : noter chaque candidat en minutes par la divergence KL
Les auteurs remplacent la note de précision par une mesure indirecte : la divergence KL entre les prédictions du token suivant du modèle quantifié et celles du modèle d’origine, calculée sur des traces de raisonnement que le modèle d’origine a écrites (mathématiques, sciences, code, rédaction et planification), distinctes des bancs de test. Les distributions du modèle d’origine sont calculées une fois et mises en cache (les 128 tokens les plus probables à chaque position, plus un reste), si bien que noter un candidat ne fait tourner que le checkpoint quantifié, dans le moteur de service vLLM lui-même. C’est 350 à 990 fois moins cher qu’une évaluation complète.
La mesure est validée sur 44 paires de checkpoints : la KL range 82 % des paires dans le même ordre que leur précision réelle, contre 73 % pour l’erreur couche par couche que minimisent GPTQ et AWQ. Comme une faible KL ne détecte pas tout, l’agent fait aussi écrire des réponses longues à quelques candidats prometteurs, pour repérer les boucles de répétition et les réponses coupées. Dans un exemple, une calibration sur données auto-générées baissait la KL de 30 % mais coupait 12 réponses sur 191 à la limite de longueur, contre 3 pour le modèle d’origine ; l’agent a corrigé en distillant sur 1 200 réponses longues.
Une bibliothèque de 21 méthodes qui s’empilent
Les auteurs ont étendu la bibliothèque llm-compressor de Red Hat et vLLM à 21 méthodes qui prennent toutes un checkpoint en entrée et en rendent un, donc s’empilent dans n’importe quel ordre. La bibliothèque déduit l’architecture du modèle elle-même au lieu de tables écrites à la main : ajouter GLM-5.3-Flash, un modèle à 288 experts, a demandé un adaptateur de 72 lignes et une extension pour sa version FP8 et sa couche de prédiction multi-tokens, après quoi toutes les méthodes ont tourné dessus. Elle accélère aussi la construction : une passe GPTQ sur Qwen3.6-35B-A3B prend 0,42 GPU-heure au lieu d’environ 16.
Un harnais qui empêche l’agent de tricher
L’agent travaille dans un bac à sable sans GPU ni accès réseau autre que l’API du modèle. Il ne voit ni les traces de référence ni les bancs de test, l’évaluateur tourne hors du bac à sable sur une copie figée du checkpoint et ne renvoie que des valeurs de KL, et chaque fichier lisible par l’agent est vérifié pour ne contenir aucun élément de test. Seul le checkpoint final est évalué sur les bancs.
Les résultats
Le banc couvre quatre modèles de raisonnement (Qwen3.5-9B, Qwen3.6-35B-A3B à 256 experts, Qwen3.8-27B et DeepSeek-R1-Distill-Llama-8B) en trois précisions : W4A16 et W3A16 (poids sur 4 ou 3 bits) et W4A8 (poids sur 4 bits, activations sur 8). La note est la moyenne de quatre catégories : mathématiques (AIME 2025 et HMMT février 2026), GPQA-Diamond, LiveCodeBench v6 et IFBench. Chaque recherche dispose de 8 GPU GH200 pendant 8 heures, soit 64 GPU-heures, et de 19 à 75 dollars de tokens d’agent.
En moyenne sur les quatre modèles, QDA fait 0,9 point de mieux que la meilleure recette publique en W4A16, 1,4 point en W4A8 et 2,2 points en W3A16. Les écarts les plus nets : +5,2 points sur Qwen3.5-9B en W4A8 (72,3 % contre 67,1 % pour QuaRot+GPTQ) et +6,1 points sur DeepSeek-R1-Distill-Llama-8B en W3A16 (40,0 % contre 33,9 % pour GPTQ). Sur Qwen3.8-27B en W4A16, le modèle quantifié dépasse même de 0,3 point le modèle en BF16 (79,8 % contre 79,5 %).
Sur le gros modèle GLM-5.3-Flash (320 milliards de paramètres, 288 experts) au format NVFP4 W4A4, une seule recherche d’environ 6,5 heures sur 16 GPU GB300, pour 69 dollars de tokens, garde 98,3 % de la précision du modèle FP8 (76,4 % contre 77,7 %), contre 96,9 % pour le checkpoint NVFP4 publié par NVIDIA et 96,3 % pour celui de Red Hat AI. QDA est le meilleur des trois sur chaque banc sauf GPQA-Diamond, où il est 0,1 point sous Red Hat AI, et son checkpoint est le plus léger (183,6 Gio contre 190,4 et 184,3).
Aucun checkpoint QDA n’ajoute de coût à l’inférence : chacun garde le format et le noyau vLLM standard de sa précision. ParoQuant, la méthode publique la plus précise en W4A16 sur Qwen3.5-9B, ajoute une rotation en ligne ; QDA décode 1,30 à 1,75 fois plus vite qu’elle sur Qwen3.8-27B en W4A16.
D’où vient le gain
Trois tests isolent les composants sur Qwen3.6-35B-A3B. Donné à NVIDIA ModelOpt et à sa compétence de recherche de recette au lieu de l’outillage QDA, le même agent fait 0,5 à 1,3 point de moins, et passe sous la meilleure recette publique en W4A8 et W3A16, alors même qu’il choisit ses candidats sur les bancs de test. Remplacé par des algorithmes de recherche classiques (recherche gloutonne, ASHA) sur la même bibliothèque, l’agent garde 0,2 à 1,2 point d’avance en W4A8 et W3A16, mais seulement 0,1 point en W4A16. Privé de la bibliothèque, il écrit trois fois plus de code (3 100 lignes contre 1 100) et finit 0,2 à 0,5 point plus bas.
Les 12 recettes finales diffèrent à chaque étape. L’étape qui baisse le plus la KL est une rotation dans cinq recherches, une distillation dans quatre, des données auto-générées dans deux et une recherche d’échelles FP8 dans une. Toutes calibrent ou distillent sur des données générées par le modèle d’origine. Appliquer tel quel le motif le plus fréquent (GPTQ sur données auto-générées puis distillation des échelles) égale ou bat la meilleure recette publique en W4A16 sur les quatre modèles, mais perd 2,2 et 5,0 points face à QDA sur Qwen3.5-9B en W4A8 et W3A16.
Les limites
Le papier ne contient pas de section consacrée aux limites. À la lecture, plusieurs points tempèrent les résultats. Les gains sont des moyennes sur quatre modèles : sur Qwen3.6-35B-A3B en W3A16, QDA est 0,2 point sous GSQ, la meilleure méthode publique. En W3A16, toutes les recherches sur les modèles Qwen sauf une partent du checkpoint GSQ et l’affinent ; or GSQ coûte 30 à 52 GPU-heures par modèle, un coût qui n’entre pas dans les 64 GPU-heures annoncées. La recherche sur GLM-5.3-Flash a utilisé 16 GPU GB300 pendant environ 6,5 heures, soit un budget plus large que les 64 GPU-heures des recherches principales, et un seul passage. Chaque paire modèle-précision n’a eu qu’une recherche, sauf Qwen3.6-35B-A3B (trois). Face aux algorithmes de recherche classiques, l’apport propre de l’agent reste modeste. Enfin, l’agent et les modèles utilisés sont récents et le code n’est pas encore publié : l’expérience n’est pas reproductible en l’état.
Lecture Neurone21
Pour une entreprise qui héberge ses propres modèles ouverts, la quantification est le levier le plus direct sur la facture : GLM-5.3-Flash en NVFP4 tient sur un GPU GB300 au lieu de deux en FP8. Le papier montre qu’on peut gagner un à deux points de précision sur les versions quantifiées publiées, sans surcoût au service, pour un budget de calcul de l’ordre d’une évaluation complète et quelques dizaines de dollars de tokens. Les enseignements valent aussi sans QDA : il n’y a pas de recette universelle, ce qui marche sur un modèle peut en dégrader un autre, et une mesure rapide par divergence KL sur des traces du modèle d’origine permet de comparer des candidats avant de payer une évaluation complète. Le dispositif anti-triche (évaluateur hors de portée de l’agent, bancs de test isolés) est un bon modèle pour toute automatisation où un agent optimise une métrique. Avant d’adopter un checkpoint quantifié, publié par un éditeur ou produit par un agent, il reste indispensable de le tester sur ses propres tâches, en particulier sur des réponses longues.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.23388v1. Les chiffres principaux sont conformes au papier : +0,9, +1,4 et +2,2 points en moyenne sur la meilleure recette publique en W4A16, W4A8 et W3A16, 64 GPU-heures par recherche, notation par divergence KL sur des traces de raisonnement invisibles pour l’agent, 98,3 % de la précision FP8 pour GLM-5.3-Flash en NVFP4 W4A4 contre 96,9 % pour le meilleur checkpoint d’éditeur (celui de NVIDIA), aucun surcoût d’inférence. Trois précisions. Les 64 GPU-heures concernent les recherches sur les quatre modèles principaux ; celle sur GLM-5.3-Flash a tourné environ 6,5 heures sur 16 GPU GB300. Le gain moyen cache un cas où QDA est légèrement sous la meilleure méthode publique (Qwen3.6-35B-A3B en W3A16, −0,2 point), et en W3A16 la plupart des recherches affinent un checkpoint public dont le coût de fabrication n’est pas compté. Le papier mentionne MIT et NVIDIA sans répartir les auteurs entre les deux.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.23388
- Le PDF : https://arxiv.org/pdf/2611.23388
- Notre fiche sur NVIDIA, NVFP4 et la mémoire des usines d’IA : /p/nvidia-co-conception-memoire-usine-ia-nvfp4-dynamo-cmx-vera-rubin
- Notre fiche sur CompoundingKernel, des agents qui écrivent des noyaux GPU chez Amazon : /p/compoundingkernel-noyaux-gpu-agents-amazon
- Notre fiche sur RSI-Dojo, un modèle qui apprend à post-entraîner d’autres modèles : /p/rsi-dojo-agents-post-entrainement-modeles
- Notre page NVIDIA : /wiki/nvidia