Titre original : Evo²: Evolving the Evolver through Weight-Harness Co-Evolution
Auteurs : Chejian Xu, Shujian Zhang, Wenxuan Zhou, John Lambert, Beck Chen, Bo Li, Andrew Hard, Rajiv Mathews
Affiliations : Google DeepMind, Université de l’Illinois à Urbana-Champaign (UIUC). Le premier auteur a mené ce travail comme étudiant chercheur chez Google DeepMind.
Publication : déposé sur arXiv le 9 octobre 2026 (version 1).
Liens : page arXiv, PDF. Aucun dépôt de code n’est indiqué dans le papier.
L’idée en bref
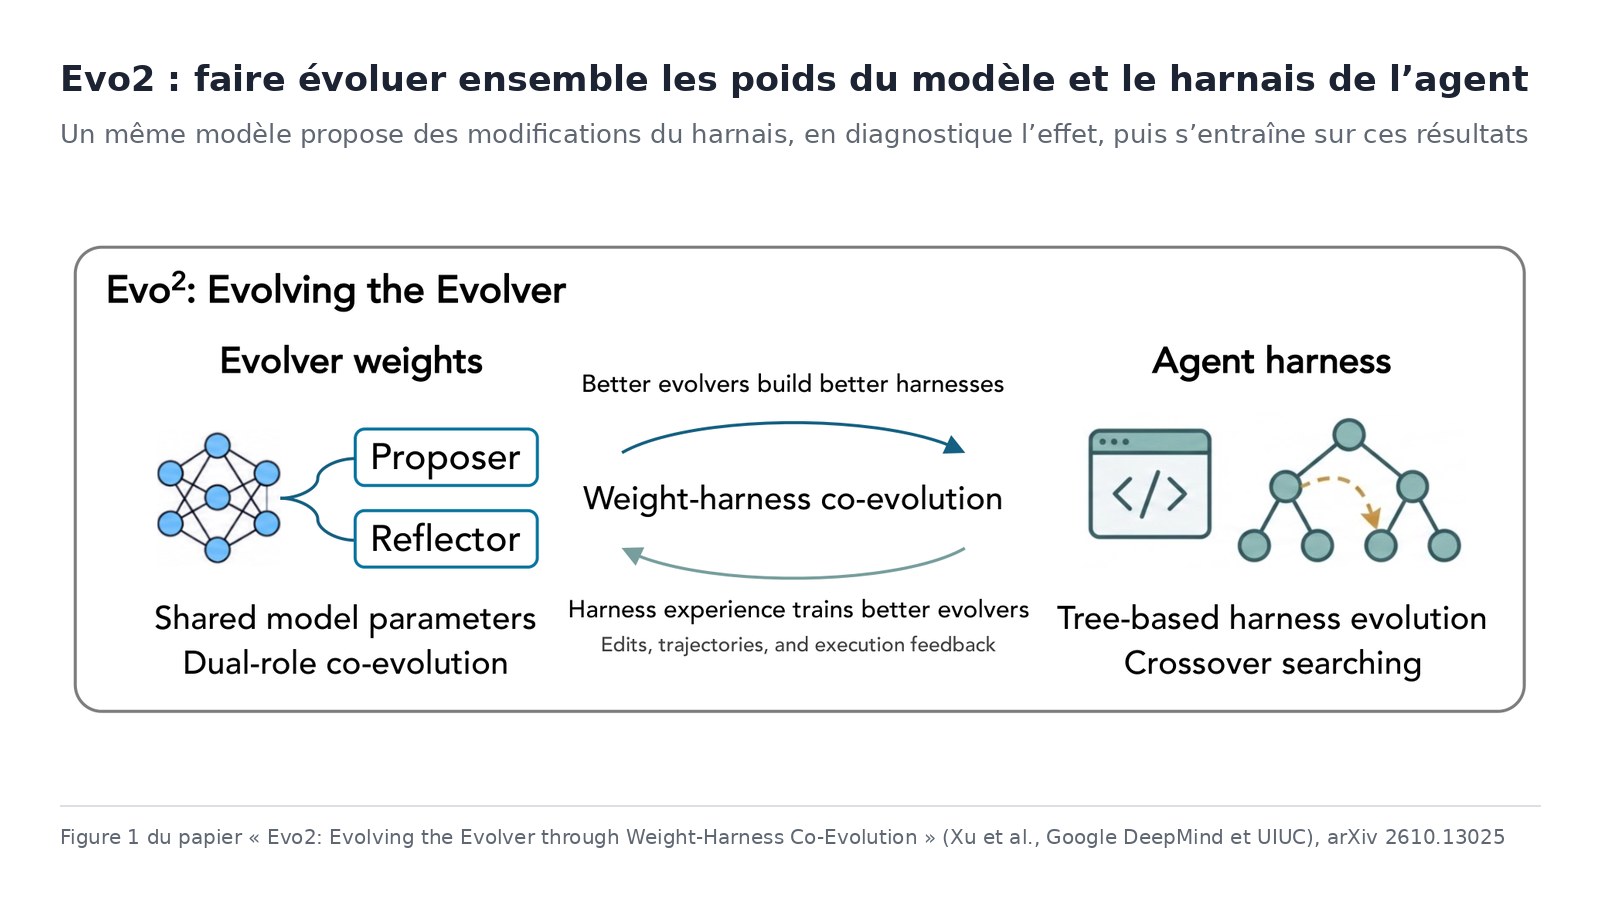
Un agent s’améliore de deux façons : en changeant les poids du modèle (on le réentraîne sur ses propres expériences) ou en changeant son harnais, le code qui gère ses consignes, ses outils, son contexte et ses retours d’exécution. Les deux pistes avancent d’habitude séparément. Evo2 les relie : chaque modification du harnais, avec son résultat mesuré, devient une donnée d’entraînement pour le modèle chargé de proposer les modifications suivantes. Le message, repris par Elvis Saravia : si vous journalisez déjà vos changements de harnais et leurs effets, vous avez des données d’entraînement.
Ce que montre le papier
Un modèle, deux rôles. Le même modèle joue le « proposeur », qui écrit des modifications du harnais, et le « réflecteur », qui lit les traces d’exécution, diagnostique l’effet de la modification et demande une révision, une greffe d’une stratégie trouvée sur une autre branche de la recherche, ou le statu quo. Les variantes forment un arbre. Le modèle est ensuite entraîné en deux temps : un réglage supervisé sur les meilleures réponses, puis du GRPO (Group Relative Policy Optimization, un apprentissage par renforcement qui compare plusieurs réponses à une même consigne), avec pour récompense le gain de score produit par chaque décision.
Des harnais plus performants. Avec Qwen3.8-27B comme exécutant et comme « évolueur » (tableau 1), le meilleur harnais obtenu atteint 82,1 % sur Polyglot (contre 62,6 % pour la meilleure méthode concurrente, GEA), 48,3 % sur SWE-bench Verified (contre 41,0 % pour HGM) et 58,0 % sur LiveCodeBench (contre 56,0 %).
Des harnais qui se transportent. Évalués sans nouvelle évolution sur les deux autres bancs d’essai, les harnais d’Evo2 arrivent premiers dans cinq des six combinaisons.
Avec des modèles fermés. Sans réentraînement possible, la seule recherche à deux rôles fait passer GPT-5-mini à 48,3 % sur un sous-ensemble de 60 tâches de SWE-bench Verified, contre 19,4 % à 24,4 % pour les méthodes concurrentes ; Claude Haiku 4.5 passe à 47,8 %, contre 42,2 % à 45,0 %.
Ce qu’apporte l’entraînement. À recherche identique, l’évolueur entraîné fait mieux que l’évolueur brut : +16,3 points sur Polyglot, +9,3 sur la mémoire conversationnelle LoCoMo, +10,6 sur LongMemEval.
Sans surcoût d’inférence. Sur LiveCodeBench, le harnais d’Evo2 consomme 3 600 jetons et 10,2 appels au modèle par tâche, contre 6 600 à 6 900 jetons et 26 à 37 appels pour deux concurrents moins précis.
Les limites
Le papier ne comporte pas de section consacrée aux limites. Notre lecture :
- Un chiffre à bien lire. Le post d’Elvis Saravia présente le passage de 24,4 % à 48,3 % avec GPT-5-mini comme l’effet du seul harnais. Dans le tableau 3, 24,4 % est le score de la meilleure méthode concurrente (SICA), pas celui de l’agent de départ, et la mesure porte sur 60 tâches seulement. De plus, Evo2 y retient le meilleur de ses deux harnais en tête, quand les concurrents n’en évaluent qu’un.
- Des gains d’entraînement inégaux. Sur SWE-bench Verified, l’apport des poids entraînés (+5 points) n’est pas statistiquement significatif d’après la valeur p de 0,086 fournie par les auteurs.
- Un seul modèle ouvert pour la co-évolution, et un domaine restreint au code et à la mémoire conversationnelle.
- Pas de code publié pour reproduire la chaîne d’entraînement.
Lecture Neurone21
L’idée la plus utile est organisationnelle : les journaux de modifications d’un harnais d’agent ont de la valeur. Une équipe qui teste des variantes d’enveloppe (consignes, outils, gestion du contexte) et mesure leurs effets peut, à terme, entraîner un modèle ouvert à proposer les bonnes modifications. C’est une piste concrète pour les organisations qui veulent garder la main sur leur pile technique : la connaissance accumulée reste chez elles, dans le harnais comme dans les poids.
Le résultat sur modèles fermés montre aussi qu’une partie du gain s’obtient sans aucun entraînement, par une recherche mieux organisée. Les chiffres, eux, demandent d’être confirmés avec des protocoles d’évaluation identiques pour toutes les méthodes.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.13025
- Le PDF : https://arxiv.org/pdf/2610.13025
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2110006902331769049
- La page « Chat with Paper » de DAIR.AI Academy : https://academy.dair.ai/papers/evo-2-evolving-the-evolver-through-weight-harness-co-evolution-2610.13025