Titre original : XLA from the Trenches: Correctness on TPU Workloads at Scale
Auteurs : Ignacio Cano (auteur de correspondance), Amir Saadat, Rishipal Singh Bhatia, Samuel Ginzburg, Patrick C. Toulme, Ioannis Zarkadas, Praveen Narayanan, Pratik Bhatu, Nicolas Basile, Alexander Dietmüller, Ruishan Wang, Jacob Wahlgren, Victor Barros, Subhankar Shah, Michael Kuperstein, Farzin Houshmand, Emma Sevastian, Peter Gavin, Karthik Srinivasa Murthy, Berkin Ilbeyi, Amit Sabne et Eli Bendersky (22 auteurs).
Affiliation : Google.
Publication : prépublication arXiv 2611.00624v1 (cs.AI), déposée le 31 octobre 2026.
Liens : page arXiv, PDF, projet OpenXLA.
L’idée en bref
XLA est le compilateur qui transforme un modèle d’IA en instructions pour une puce, ici les TPU de Google. Pour aller vite, il fusionne beaucoup d’opérations en un seul noyau de calcul. Le risque est qu’une erreur subtile de génération de code ne fasse pas planter le programme : elle change légèrement les nombres. Les auteurs écrivent qu’un tel défaut peut faire diverger un entraînement de plusieurs millions de dollars après des semaines de calcul, ou dégrader un service en production sans aucune erreur visible.
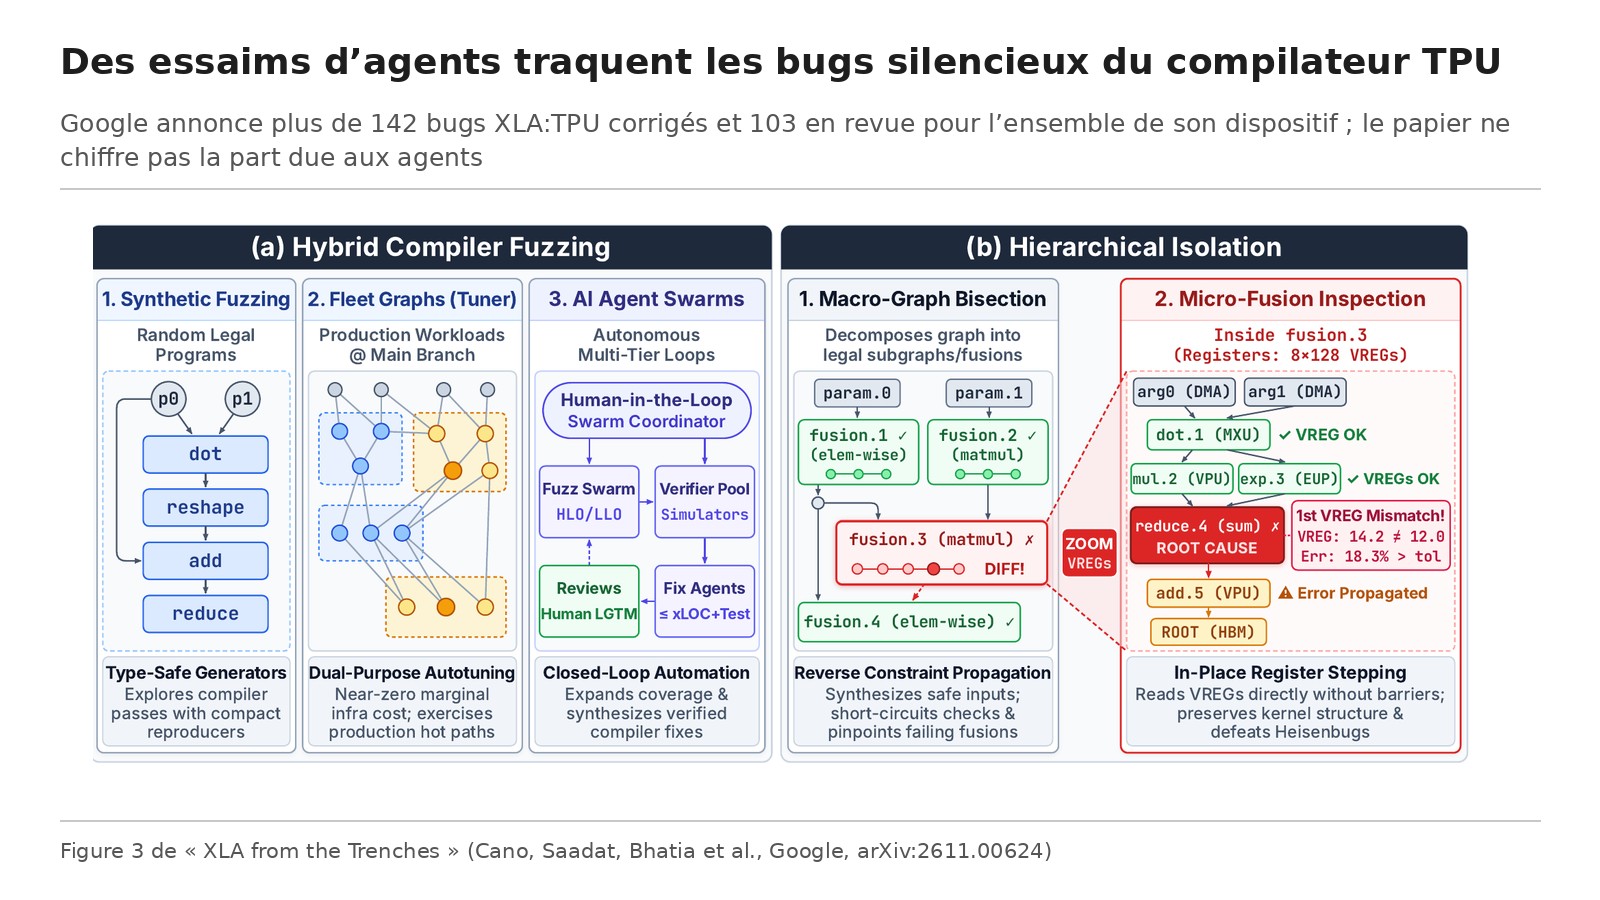
Le papier décrit la méthode que l’équipe XLA:TPU utilise pour traquer ces défauts. Elle associe trois sources de tests (programmes générés au hasard, vrais graphes de production, essaims d’agents) à une méthode pour localiser, dans un grand calcul, l’opération qui fausse le résultat.
Ce que montre le papier
Pourquoi les tests existants ne suffisent pas
Le code source d’XLA contient plus de 40 000 définitions de tests unitaires, qui deviennent presque 200 000 cas une fois paramétrés par type de nombre, forme et disposition. Une passe complète représente bien plus d’un million d’exécutions. Des erreurs silencieuses passent pourtant, parce que l’espace des fusions possibles est trop vaste et que les graphes de production sont énormes : sur un échantillon d’environ 200 000 graphes d’un parc de TPU, plus de 40 % dépassent 10 000 nœuds, et des fusions atteignent environ 700 instructions de produit matriciel et 5 900 d’opérations élément par élément.
Les trois sources de tests
Le premier outil génère des programmes aléatoires mais valides, avec des gabarits qui évitent les opérations aux résultats non définis. Le deuxième exploite l’optimiseur automatique qui tourne déjà sur les graphes de production : il vérifie les sorties à un coût marginal presque nul. Le troisième est un essaim d’agents qui travaille en boucle fermée : des agents de fuzzing proposent des tests, des agents de vérification confirment ou écartent, des agents correcteurs produisent un correctif minimal, et un essaim de relecture adverse contrôle chaque correctif avant qu’un humain le voie. Les humains restent dans la boucle : l’auteur oriente les cibles et un coordinateur ne soumet que les correctifs les plus graves aux mainteneurs.
Où se trouvent les bugs, et ce qu’ils ont coûté
Le tableau 1 répartit les correctifs relus issus des campagnes de fuzzing : 43 % dans le code de bas niveau des cœurs de calcul (LLO et émetteurs), 25 % dans les simplificateurs de haut niveau, 14 % dans les réécritures de précision et d’émulation, 10 % dans SparseCore, 8 % dans le code des noyaux sur mesure. Le papier précise que la grande majorité des bugs corrigés sont des erreurs numériques silencieuses, car les agents ont été orientés volontairement vers elles plutôt que vers les plantages bruyants.
Deux cas de production illustrent l’enjeu. Le fuzzing quotidien sur les graphes a signalé une divergence dans des noyaux fusionnant convolution et réduction quelques jours avant qu’un client constate une chute de ses métriques d’évaluation par 100 après une mise à jour du compilateur. Un second défaut du même type, sur des réductions fenêtrées, avait été repéré par le fuzzing et son correctif était déjà en cours quand un client a signalé qu’un pipeline de recherche de plus proches voisins perdait environ 30 % de ses meilleurs résultats : le rappel sur les 1 000 premiers a pu être rétabli à plus de 99 % aussitôt.
Isoler le calcul fautif
Dans un grand graphe, comparer seulement la sortie finale ne dit pas quelle opération est coupable. L’isolement se fait en deux étapes : découper le graphe en sous-graphes exécutables seuls pour trouver la fusion fautive (cette partie a été reversée au projet OpenXLA), puis lire, dans le noyau resté intact, les valeurs intermédiaires des registres vectoriels pour trouver la première instruction où le résultat diverge. Exemple décrit : dans un calcul d’entraînement avec quantification, la soustraction censée capter l’erreur d’arrondi donnait 0,0 pour les 131 072 éléments, soit 100 % d’erreur relative, parce que les deux conversions de type étaient sautées à l’intérieur du noyau fusionné.
Leçons pratiques
Les auteurs tirent plusieurs enseignements. Imposer des correctifs courts et atomiques, accompagnés d’un test minimal qui échoue, permet à un humain de vérifier en quelques secondes que le bug est réel, alors que la charge de relecture ne croît pas proportionnellement à la taille du correctif. Une porte de relecture adverse, un classement par gravité et une relecture humaine sur option évitent de submerger les mainteneurs. Sans précaution, les agents gravitent vers les plantages faciles à trouver, d’où le choix de les diriger vers les erreurs silencieuses. Enfin, un taux de faux positifs de 5 % suffit à faire perdre la confiance des développeurs.
Les limites
Le papier n’a pas de section dédiée aux limites. Voici ce que montre sa lecture :
- l’évaluation est descriptive : elle donne des comptes, une répartition par sous-système et des cas, sans méthode de référence ni mesure de ce que l’approche trouve en plus ou en moins qu’une autre ;
- le chiffre de plus de 142 bugs corrigés concerne l’ensemble du dispositif (fuzzing synthétique, vérifications sur le parc, essaims d’agents) ; aucun chiffre ne sépare la part due aux agents ;
- les 103 autres résultats sont « en cours » : ils ne sont pas confirmés ;
- le dispositif repose sur un harnais d’agents interne à Google et sur du matériel TPU, il n’est donc pas reproductible de l’extérieur ; seule la brique d’isolement du macro-graphe est reversée à OpenXLA ;
- l’étude porte sur un seul compilateur, XLA:TPU, et surtout sur les erreurs numériques silencieuses.
Lecture Neurone21
Pour une équipe qui fait écrire du code par des agents, le papier donne un cadre éprouvé sur un système exigeant : donner à l’agent une cible précise (ici les erreurs silencieuses), le forcer à livrer un correctif minimal avec un test qui échoue avant et réussit après, et faire contrôler le tout par un second groupe d’agents avant de solliciter un humain. La charge de relecture, pas la vitesse d’écriture, est ce qui limite.
Un exemple concret : pour un éditeur de logiciel de gestion, demander à un agent de corriger des arrondis dans le calcul de la TVA vaut mieux avec un test qui échoue sur un cas précis qu’avec un correctif de deux cents lignes touchant tout le module, que personne n’osera relire. Le papier le dit : les correctifs courts se sont révélés bien meilleurs que les gros.
Ce résultat complète notre fiche sur l’agent de Google qui répare les tests en échec et notre dossier sur le harnais des agents IA. À lire avec prudence : c’est le compte rendu d’une équipe sur son propre outil, sans comparaison avec une autre méthode.
Le post d’Elvis Saravia est fidèle au papier. Précisions : les plus de 142 bugs sont attribués à l’ensemble du dispositif, pas aux seuls essaims d’agents, et l’idée que la charge de relecture croît plus vite que la complexité des correctifs est une paraphrase du constat des auteurs sur une charge non linéaire.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.00624
- Le PDF : https://arxiv.org/pdf/2611.00624
- Le projet OpenXLA : https://github.com/openxla/xla
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2117613273189376072