Titre original : rTaste: Do Research Agents Have Taste? Evaluating Early Stage Research Judgment
Auteur : Art Kanke, University of Minnesota (États-Unis), seul auteur.
Publication : prépublication arXiv 2610.40488v1 (cs.CL), déposée le 29 octobre 2026, 24 pages. Licence Creative Commons CC BY 4.0. Le banc d’essai et le jeu de données des 415 expériences, avec prévisions et résultats audités, sont publiés sur GitHub.
Liens : page arXiv, PDF.
L’idée en bref
Les agents IA savent désormais lire la littérature, coder et lancer des expériences. Ce que les laboratoires ne leur délèguent pas encore, c’est le choix de ce qui mérite d’être testé avant de connaître le résultat, ce que les chercheurs appellent le « flair » (taste en anglais). Le papier le rappelle en citant une évaluation du METR : dans quatre grands laboratoires, rien n’indiquait que des agents fixaient l’agenda de recherche ou décidaient des budgets (section 1).
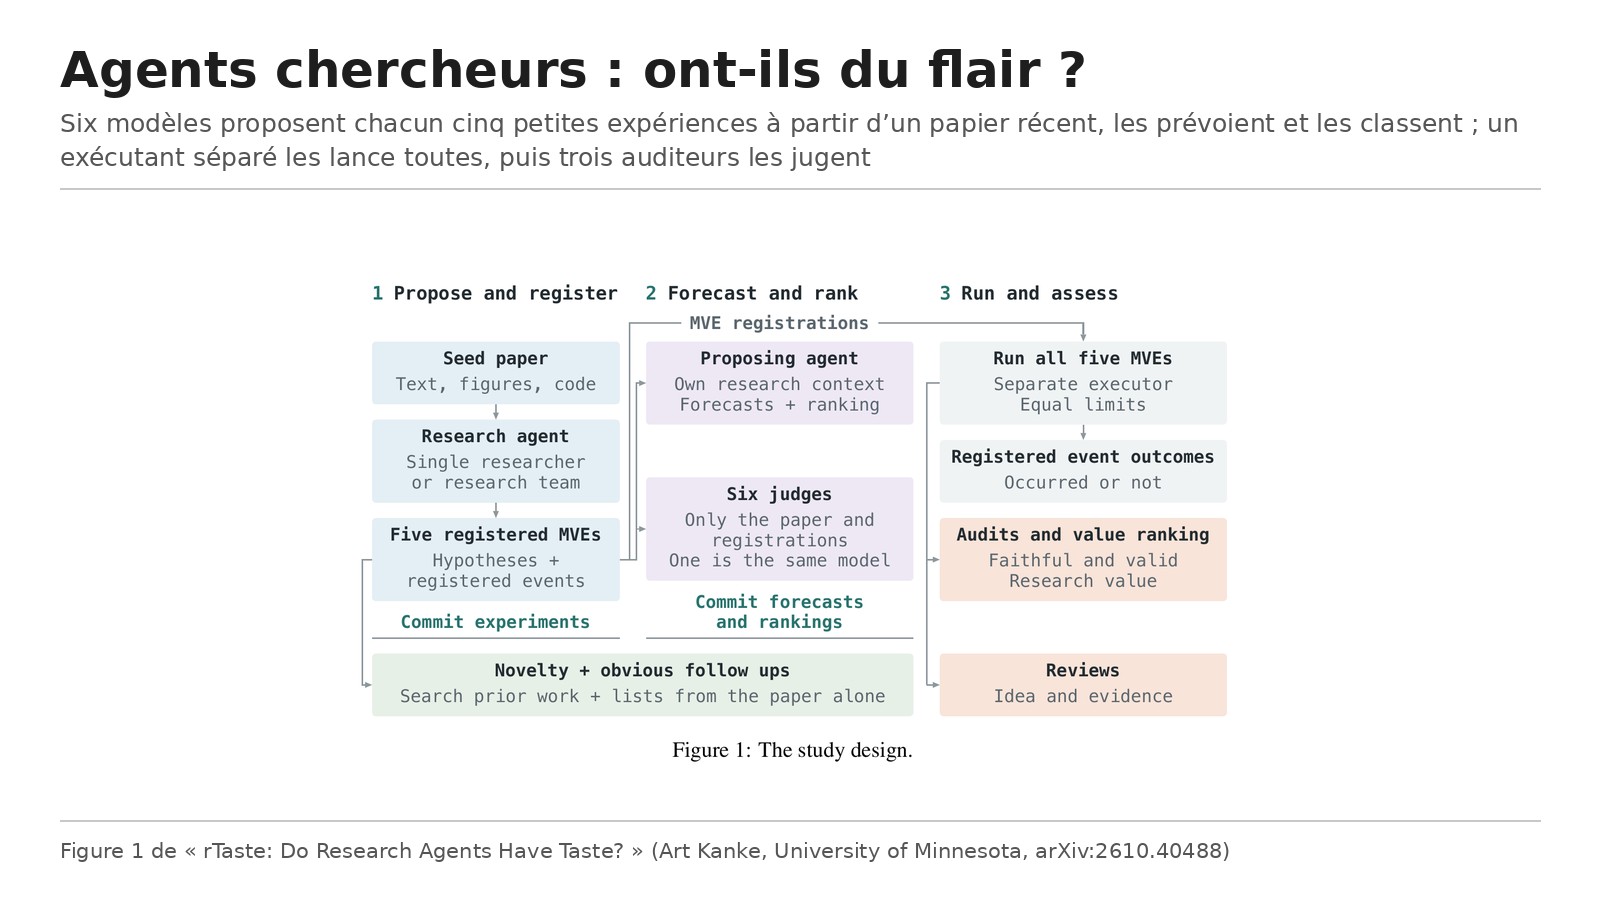
Pour mesurer ce flair, l’auteur donne à chaque modèle un papier récent de traitement du langage, avec son code. Le modèle propose cinq « expériences minimales viables », de petits tests peu coûteux qui disent si une piste vaut un investissement plus lourd. Pour chacune, il fixe à l’avance un seuil de réussite, estime la probabilité de l’atteindre, puis classe les cinq. L’originalité du protocole : un exécutant séparé lance toutes les expériences, y compris celles classées en dernier, ce qui permet de vérifier si le classement et les prévisions valaient quelque chose (figure 1).
Ce que montre le papier
Le protocole
Sept papiers de départ, publiés entre le 3 août et le 24 septembre 2026, ont été choisis assez récents pour que peu de travaux de suite existent. Six modèles ont été testés à effort de raisonnement maximal, entre le 6 et le 8 octobre 2026 : GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5, GPT-6.1 Sol, GPT-6 Luna et Muse Spark 1.3. Chaque modèle travaille de deux façons : en chercheur seul, dans un seul contexte, ou en équipe, avec deux proposeurs, un critique et un chef qui arbitre (sections 3.1 et 3.2).
L’exécution se fait sur une machine à part, avec un GPU A100 et 45 minutes au plus par expérience. Les résultats sont ensuite relancés sur une machine neuve, puis jugés par trois auditeurs (Claude Opus 5.5, GPT-6.1 Sol et Grok 4.7) qui ne savent pas qui a proposé quoi (section 3.4).
Beaucoup de bonnes expériences, peu d’idées vraiment neuves
Sur 415 expériences proposées, 194 sont jugées solides, utiles et nouvelles. Mais seulement 73 de ces 194 vont aussi au-delà du papier de départ de façon non évidente. Les quatre grands modèles proposent environ trois bonnes expériences sur cinq, les deux plus petits (GPT-6 Luna et Muse Spark 1.3) environ une (sections 1 et 4.1).
La plupart des expériences prolongent le papier : 66 % le développent, 24 % vérifient l’une de ses affirmations, et seulement 5 % ouvrent une direction nouvelle. 44 % figurent dans une liste de suites « évidentes » que chaque modèle a rédigée à partir du seul papier. Sur un des papiers, les huit essais des quatre grands modèles ont tous écrit en premier la même vérification (section 4.2, tableau 2).
GPT-6 Astra et GPT-6.1 Sol proposent à eux deux les deux tiers des expériences qui sortent vraiment du cadre. Ils fixent aussi des seuils plus exigeants : leurs critères de réussite sont atteints dans 25 % des cas, contre 52 % pour Claude Fable 5.1 et Claude Opus 5.5, qui restent plus proches du papier (sections 4.2 et 4.3).
Des prévisions correctes, mais pas meilleures qu’un lecteur extérieur
Les prévisions des agents battent un taux de base (score de Brier de 0,192 contre 0,240, plus bas est meilleur). Mais une nouvelle instance du même modèle, qui n’a lu que le papier et les cinq fiches d’expérience, sans code ni recherche, prévoit aussi bien : l’écart est de moins 0,006, avec un intervalle de confiance à 95 % de moins 0,021 à 0,009. La moyenne des six juges fait même mieux que l’agent, 0,179 (section 4.4, tableau 3).
Un classement qui suit surtout l’ordre d’écriture
Le premier choix de l’agent est l’expérience la plus appréciée des auditeurs dans 38 % des cas, contre 20 % pour un tirage au hasard. Mais il ne fait pas mieux que la toute première expérience écrite : l’avantage est de 3 points, avec un intervalle de moins 8 à plus 15. Les agents classent en effet surtout dans l’ordre où ils ont écrit, et leur premier choix est l’expérience écrite en premier dans 47 % des cas. Ils favorisent aussi les expériences qui ont des chances de passer : le seuil du premier choix est atteint dans 47 % des cas, contre 29 % pour le dernier (section 4.5).
Les équipes coûtent plus sans gain net
En équipe, un modèle propose en moyenne 0,71 bonne expérience de plus sur cinq, mais l’écart n’est pas significatif (intervalle de moins 0,10 à 1,52). Un essai coûte 15,31 dollars en moyenne pour un chercheur seul et 23,93 dollars pour une équipe. Pour 100 dollars, les chercheurs seuls produisent 13 bonnes expériences et les équipes 11 ; GPT-6.1 Sol est le plus efficace, avec 30 en chercheur seul (sections 4.6 et 4.7, tableau 1).
Les limites
L’auteur reconnaît que (section 6) :
- toutes les étiquettes viennent de modèles, sans point de comparaison humain ;
- les auditeurs jugent après avoir vu les résultats, et deux des trois font partie des modèles étudiés et servent aussi d’exécutants ;
- toutes les expériences ont été lancées quel que soit leur rang : un agent dont le classement décide vraiment de ce qui tourne pourrait classer avec plus de soin ;
- chaque essai n’a été lancé qu’une fois, sans mesure de la variabilité d’un essai à l’autre.
Réserves de notre lecture, tirées du papier :
- Le champ est étroit : sept papiers de traitement du langage, sans entraînement lourd ni modèle de plus de 8 milliards de paramètres. Les conclusions ne valent pas forcément pour d’autres disciplines.
- L’auditeur Claude Opus 5.5 juge non solides 18 % des expériences codées par l’exécutant Claude Opus 5.5, contre 3 % pour l’exécutant GPT-6.1 Sol (section 4.7). Le choix de l’exécutant pèse donc sur les scores.
- Sur un papier, le fournisseur de Claude Opus 5.5 a refusé les requêtes du chercheur seul, et 30 des 415 fiches de l’équipe Claude Opus 5.5 ont été écrites à effort moyen après une coupure de réponse (section 3.2).
Lecture Neurone21
Pour une entreprise, le résultat est utile parce qu’il sépare deux capacités souvent confondues. Un agent sait très bien vérifier une idée et dérouler les suites évidentes, pour quelques dollars par test. Il ne sait pas encore, de façon démontrée, choisir à votre place la piste qui mérite le budget. En pratique, on peut confier à un agent la vérification d’une méthode publiée ou d’une affirmation d’un fournisseur, mais garder la décision d’investir chez une personne.
Le papier donne aussi un conseil simple : ne pas se fier au premier choix de l’agent, qui reprend surtout la première idée qu’il a écrite et la plus sûre de passer. Mieux vaut lancer plusieurs petits tests en parallèle et regarder les résultats. Enfin, le surcoût des équipes d’agents n’est pas justifié ici, ce qui rejoint notre dossier sur la façon de monter une équipe d’agents IA. Sur les agents de recherche, voir aussi notre fiche sur le scientifique agentique de Sakana.
Le post d’Elvis Saravia est fidèle aux chiffres du papier. Il ne précise pas que tous les jugements, y compris celui de « bonne expérience », viennent de modèles et non de chercheurs humains, ce que l’auteur présente pourtant comme la première limite de l’étude.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.40488
- Le PDF : https://arxiv.org/pdf/2610.40488v1
- Le code et le jeu de données : https://github.com/ArtKanke/rTaste
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2116204488562528713
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/rtaste-do-research-agents-have-taste-evaluating-early-stage-research-judgment-2610.40488