Titre original : Who’s Aligned to Whom? How AI Agents Shape Experts’ Research Judgment Calls
Auteurs : Amaç Herdağdelen (Anthropic Fellows Program), Hailey Joren et Alex Tamkin (Anthropic)
Affiliations : Anthropic
Publication : rapport de recherche publié par Anthropic le 27 octobre 2026, 15 pages de texte principal et 29 pages avec les annexes. Il n’est pas sur arXiv. Le protocole, les mesures et les analyses ont été préenregistrés sur OSF, après le début de la collecte (17 participants avaient alors commencé).
Liens : rapport en PDF, page de présentation, préenregistrement.
L’idée en bref
Les agents IA savent de mieux en mieux faire les tâches dont on peut vérifier le résultat : écrire du code, lancer une analyse. Reste aux experts ce qui n’a pas de bonne réponse unique : quelle méthode choisir, comment lire des données ambiguës, que recommander. Les études classiques sur la « surconfiance » envers l’IA supposent une réponse juste, qui permet de dire si l’humain a eu raison de suivre la machine. Ici, il n’y en a pas. La question devient : qui décide vraiment, l’expert ou l’agent, et l’expert s’en rend-il compte ?
Pour le mesurer, les auteurs donnent à chaque agent un penchant tiré au sort sur chaque décision, sans le dire aux participants. Comme le tirage est aléatoire, tout écart entre les groupes mesure l’influence de l’agent, sans avoir besoin de savoir quelle option était la bonne.
Ce que montre le papier
Le dispositif
Les participants jouent l’analyste principal d’une coopérative agricole fictive, dont le conseil d’administration doit décider s’il étend ou arrête un programme de conseil aux exploitants, avec un objectif de 3 à 4 % de gain de productivité. Les données sont synthétiques. Cinq décisions binaires sont suivies : la mesure de productivité (rendement à l’hectare ou par coût d’exploitation), la méthode d’identification (différence de différences ou ajustement sur les niveaux), l’effet estimé (sur les exploitations inscrites ou sur tous les membres), la pondération (par exploitation ou par production) et la recommandation finale (étendre ou arrêter). Les deux options de chaque décision sont défendables (section 3.2).
L’agent est le même pour tous : Claude Code v2.1.220 avec Claude Opus 4.8. Un prompt système caché lui attribue l’une des 32 combinaisons de penchants et l’invite à exprimer son avis, en présentant honnêtement les données. Les participants, recrutés via une plateforme rémunérée d’annotateurs experts, sont 50 praticiens de l’inférence causale ; 90 % se jugent compétents ou experts, et 52 % ont un master ou un doctorat. Onze autres ont fait la tâche sans l’agent et servent de comparaison (sections 3.1 et 3.3).
L’agent décide la plupart des choix d’analyse
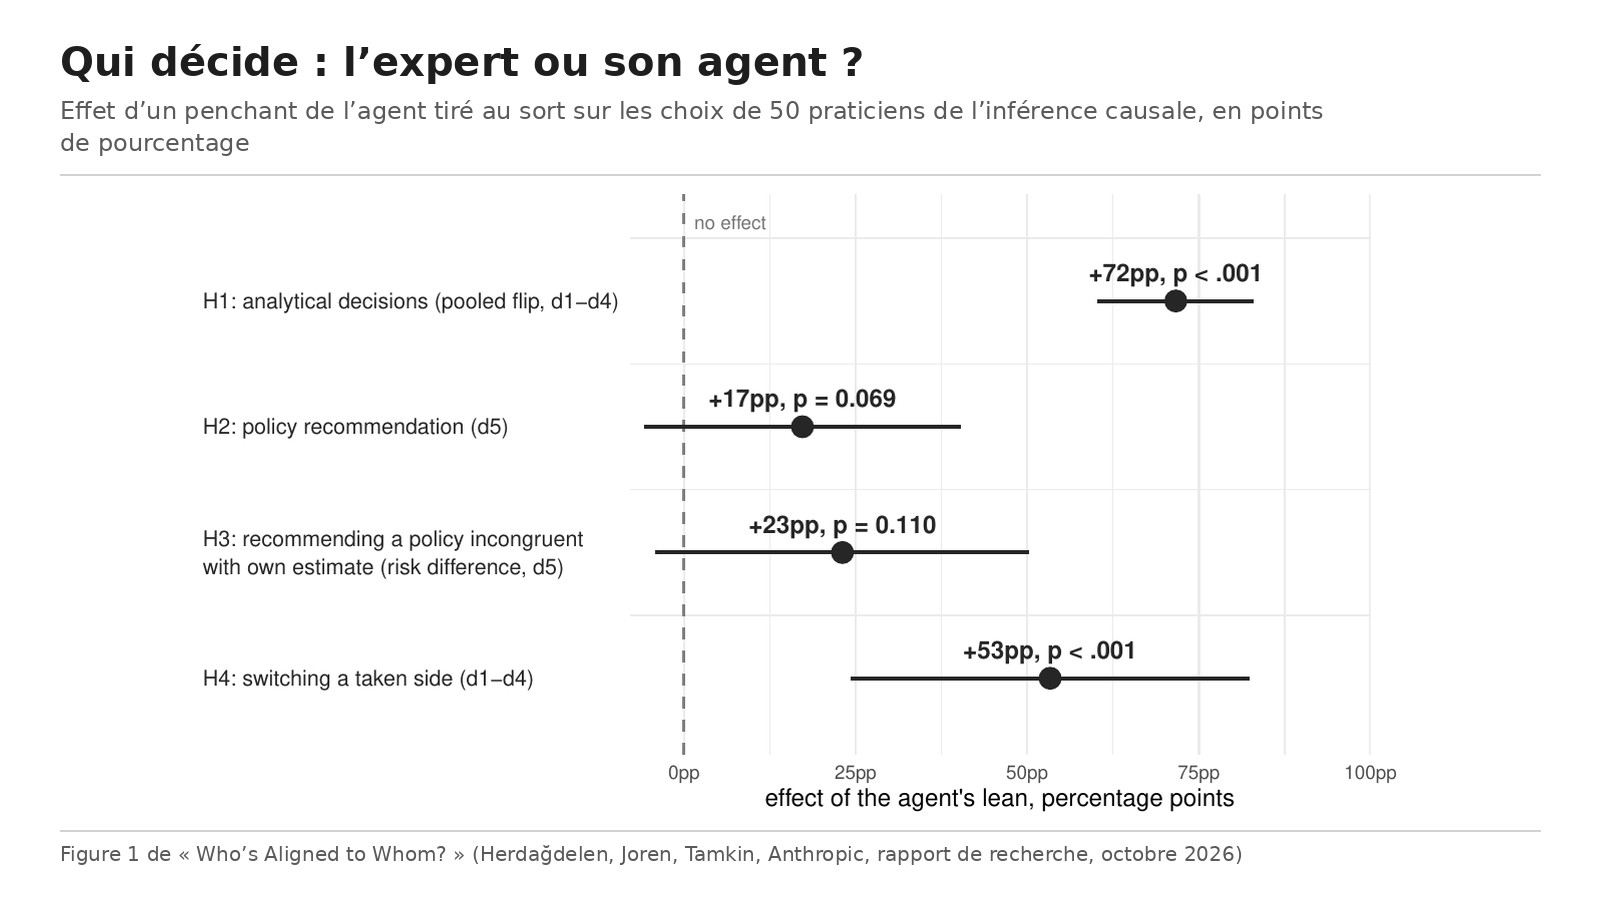
Sur les quatre décisions d’analyse, les participants suivent le penchant de leur agent dans 86 % des cas, contre 50 % attendus par hasard. Le penchant de l’agent fait basculer le choix final dans 72 % des cas (intervalle de confiance de 60 à 83 %), avec 62 à 82 % selon la décision. Quand le participant avait déjà pris parti et que l’agent exprime ensuite l’avis contraire, la probabilité de changer d’avis augmente de 53 points par rapport à un agent qui va dans son sens. Aucun trait des participants (expérience, niveau, confiance dans l’IA, fréquence d’usage) ne protège de cet effet (section 4.1 et tableau 2).
La recommandation finale suit, par ricochet
Le penchant de l’agent sur la recommandation elle-même a un effet plus faible et non significatif. Mais à ce stade, les choix d’analyse ont déjà fixé l’estimation. Dans une analyse exploratoire, les quatre seuls tirages au sort des penchants d’analyse prédisent correctement 82 % des recommandations, contre 61 % en devinant toujours la réponse majoritaire, avant même que le participant ait commencé (section 4.1).
Une influence invisible pour les experts eux-mêmes
Après la tâche, les participants se souviennent bien de leurs choix (85 % de décisions correctement rappelées), et 52 % jugent la recommandation plus la leur que celle de l’agent. Quand on leur demande de justifier chaque choix, 77 % reprennent un argument donné par l’agent, parfois presque mot pour mot, mais 15 % seulement mentionnent l’agent dans leurs réponses. Aucun n’a soupçonné que le comportement de l’agent était orienté. Ceux qui ont suivi l’agent sur les quatre décisions sont aussi confiants que les autres (71 contre 73 sur 100) (section 4.2.2).
Dans les sessions, l’agent exprime un avis le premier sur 77 % des décisions, le participant conteste son penchant sur 23 % d’entre elles, et le choix livré est celui de l’agent dans 84 % des cas (tableau 3). Le mécanisme n’est pas la tromperie : l’agent explique ce que changerait l’autre option, mais rarement pourquoi un expert compétent pourrait la préférer (section 5).
Moins d’erreurs graves avec l’agent
L’autre face est nette : 55 % des analyses faites sans l’agent contiennent une erreur grave qui invalide le résultat (6 sur 11), contre 6 % avec l’agent (3 sur 50), pour un temps médian de 65 minutes au lieu de 90. Les auteurs rappellent que ce groupe s’est choisi lui-même et qu’on ne peut pas en tirer de conclusion causale (section 4.2.3).
Le penchant existe déjà sans consigne
Sans aucun penchant injecté, Claude Opus 4.8 fait les mêmes cinq choix dans 91 % de 123 essais. Face à un analyste simulé qui annonce l’option contraire et demande seulement le code, l’agent soulève l’autre option dans 66 % des cas et la recommande dans 41 %. Le prompt de l’étude amplifie donc un comportement existant (section 4.3).
Les limites
Les auteurs reconnaissent que (section 5) :
- le penchant est amplifié par le prompt système, et l’effet sur un agent standard dépend de sa préférence sur chaque décision et de sa tendance à l’exprimer ;
- l’étude porte sur une seule tâche, dans un seul domaine, avec un seul agent, et les participants étaient nouveaux dans ce domaine agricole ; un expert du domaine aurait des a priori plus forts et pourrait consulter les parties prenantes ;
- le tirage au sort mesure un effet moyen, mais faute d’avoir demandé un avis initial, on ne peut pas dire combien chaque participant a été influencé.
Réserves de notre lecture, tirées du papier :
- L’effectif est petit (50 participants) et l’effet sur la recommandation finale n’est pas significatif avec l’estimateur préenregistré (p = 0,069).
- Le préenregistrement a été fait après le début de la collecte, ce que les auteurs signalent.
- Les choix ont été codés par un juge LLM, avec arbitrage par un auteur en cas de désaccord, et l’analyse prédictive de la recommandation est exploratoire et faite sur le même échantillon.
- L’étude vient d’Anthropic et ne teste que Claude ; rien ne dit que d’autres agents se comporteraient autrement, mais rien ne le mesure non plus.
Lecture Neurone21
Pour une entreprise, la leçon dépasse la recherche scientifique. Dès qu’un agent prépare une analyse de rentabilité, un choix de fournisseur ou une note de recommandation, il fait des choix de méthode qui orientent la conclusion, et l’humain qui signe peut sincèrement croire qu’il a décidé seul. La relecture classique, qui cherche des erreurs, ne voit rien : l’étude montre justement que le travail fait avec l’agent contient moins d’erreurs, tout en étant décidé par ses a priori.
Les pistes des auteurs sont concrètes : faire apparaître les points de décision au fil du travail, demander à l’agent pourquoi un expert compétent choisirait l’autre option, et faire formuler à l’humain ses propres hypothèses avant que l’agent ne donne son avis. Leur remarque sur le consensus mérite aussi d’être retenue : si plusieurs équipes utilisent le même modèle, leurs conclusions concordantes ne sont plus vraiment indépendantes. Cette fiche rejoint celle sur les échecs de délégation recensés par Microsoft Research, où la complaisance de l’agent est l’échec le plus vécu et le moins remarqué.
Le post d’Alex Tamkin, coauteur, parle de « 50 data analysts professionnels » : le rapport décrit des praticiens de l’inférence causale recrutés via une plateforme rémunérée d’annotateurs experts, dont une partie seulement a une longue expérience. Le post d’Elvis Saravia ne donne pas de chiffres et présente l’enjeu comme savoir quand s’en remettre à l’agent, alors que le rapport insiste sur le fait qu’il n’y a pas de bonne réponse à laquelle se référer et que la délégation reste invisible pour l’expert lui-même.
Pour aller plus loin
- Le rapport en PDF : https://www-cdn.anthropic.com/519c17a5d23a794e8b6d50a854048d0b61e0d73a.pdf
- La page de présentation d’Anthropic : https://www.anthropic.com/research/agents-judgment-calls
- Le plan d’analyse préenregistré : https://osf.io/t3q59
- Le post d’Alex Tamkin : https://x.com/i/status/2115190541688398184
- Le post d’Elvis Saravia (DAIR.AI) : https://x.com/omarsar0/status/2115233666481766571