Le fait
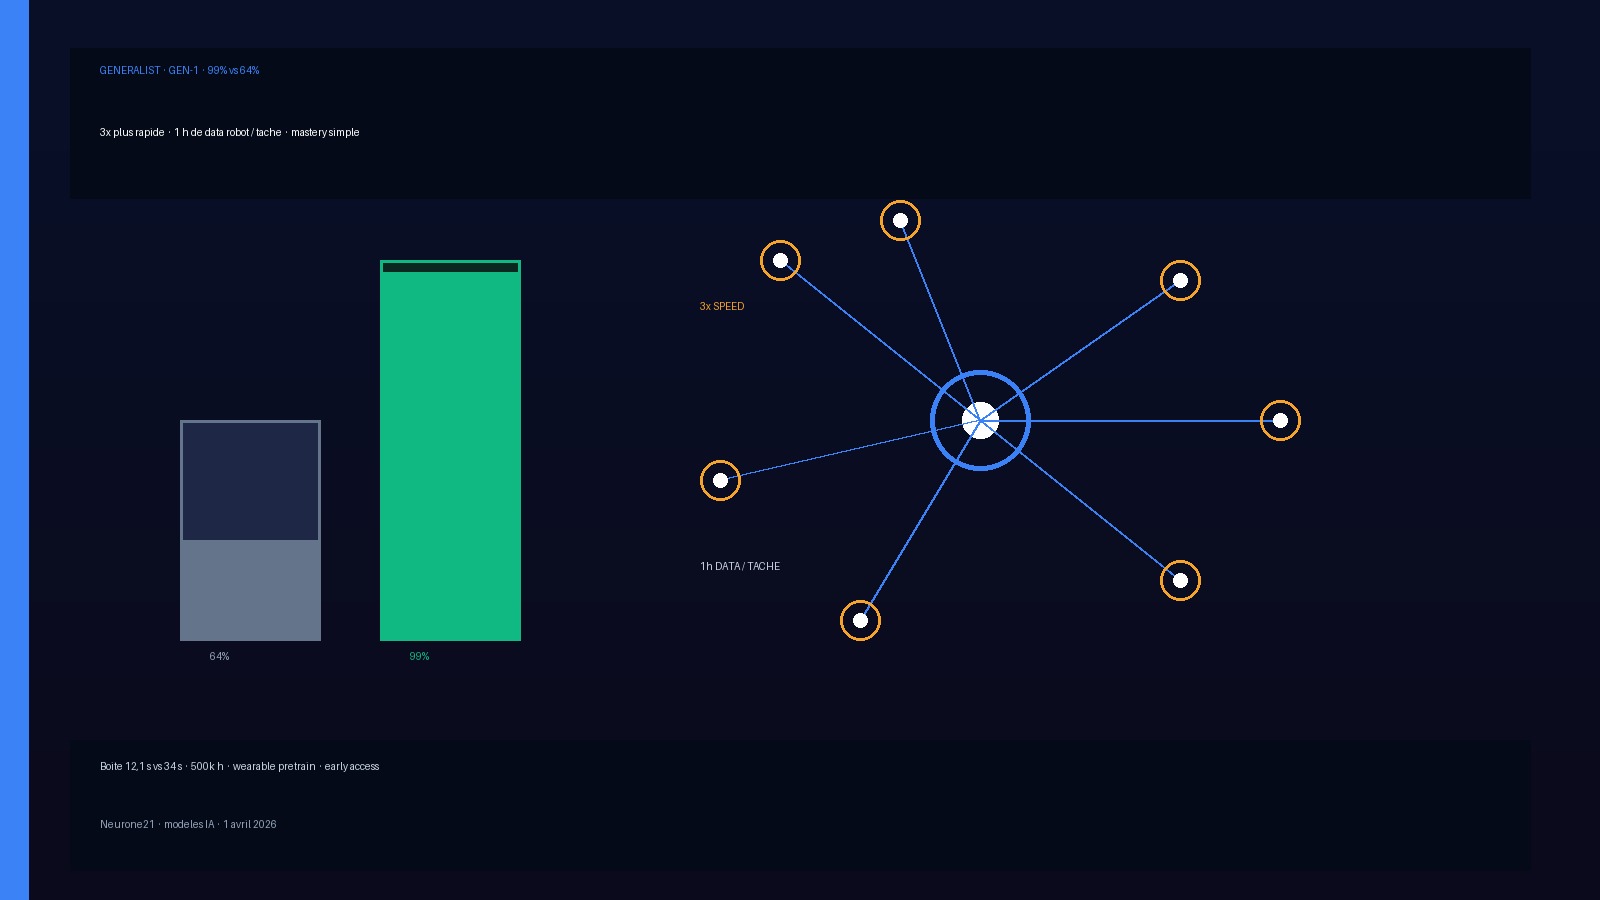
Le 2 avril 2026, Generalist AI (San Mateo, fondée en 2024) publie GEN-1, présenté comme le premier modèle généraliste d’IA physique à franchir un seuil qu’ils nomment mastery de tâches simples. Chiffres maison, répétés le lendemain par The Robot Report : le taux de succès moyen passe à 99 % sur des tâches où les modèles précédents (GEN-0 fine-tuné) plafonnaient à 64 % ; le temps de complétion est environ 3× plus court que le SOTA ; chaque résultat affiché n’a demandé qu’environ une heure de data robot. Sans pré-entraînement, les mêmes tâches from scratch tombent à 19 % de succès moyen. En cinq mois — GEN-0 datait de novembre 2025 — la startup affirme avoir basculé d’un régime « pas déployable en commercial » à un régime « production-level » sur un sous-ensemble borné.
GEN-1 n’est pas vendu comme un checkpoint isolé. Le blog le décrit comme un système : avances de pré-training (courbe d’efficacité compute), post-training, RL / learning from experience, guidage humain multimodal, et de nouvelles techniques d’inférence dont Harmonic Reasoning. Le dataset interne atteint désormais plus d’un demi-million d’heures d’interaction physique haute-fidélité. Point critique pour le coût data : le pré-training ne contient pas de data robot. Il s’appuie sur des wearables low-cost portés par des humains qui accomplissent des millions d’activités. Quand GEN-1 s’adapte à une tâche, il s’adapte en même temps à l’embodiment et à la tâche — avec ~1 h de traces robot. Sur certains tests, il égalerait GEN-0 avec 10× moins de data tâche et de steps de fine-tune.
Les preuves vidéo (1×, fully autonomous, non accélérées) couvrent six tâches longues : kitting auto parts plus d’une heure sans intervention ; pliage de T-shirts 86 fois d’affilée ; servicing de robots aspirateurs 200+ fois ; packing de blocs 1 800+ fois ; pliage de boîtes 200+ fois ; packing de téléphones 100+ fois. Vitesse : une boîte assemblée en 12,1 s — 2,8× plus vite que GEN-0 et π 0 (Physical Intelligence), tous deux ~34 s sur des boîtes identiques ; un téléphone en housse en 15,5 s, 2,8× GEN-0. SiliconANGLE (6 avril) relaie le même couplet 99 % / 3×, en rappelant que toutes les tâches ne tapent pas 99 %.
Contexte
Generalist a posé, avec GEN-0 (4 novembre 2025), la thèse des scaling laws en robotique : chaque tâche zero-shot suivie s’améliorait en même temps à mesure que data et compute croissaient — analogie explicite avec GPT-2 → GPT-3. GEN-0 n’était « pas suffisant pour du commercial ». GEN-1 est raconté comme le moment GPT-3 de cette courbe : certaines tâches simples deviennent économiquement utiles, sans que le modèle « résolve tout ». La société (Pete Florence, Andy Zeng, ex-DeepMind ; Andrew Barry, ex-Boston Dynamics ; backing NVIDIA souvent cité) revendique d’avoir redessiné les fondations incarnées, entraînées from scratch sur le dataset interne, et d’avoir reconstruit l’infra distribuée pour traiter des petabytes d’interaction physique (kernels custom, paged attention temps réel, contrôles plus lisses).
La définition de mastery vaut le détour : ce n’est pas un score unique, c’est le produit de trois axes. Reliability : tenir des heures, des centaines de cycles, sans opérateur. Speed : le temps de tâche, pas la vitesse moteur — dès que ça accélère, le monde n’est plus quasi-statique (frottements, blur, contraintes d’inférence). Improvisation : récupérer hors distribution. Exemple kitting auto : une rondelle (washer) délogeée peut être repose-regraspée, partiellement insérée pour une dextérité extrinsèque, ou reprise bimanuelle. Un T-shirt dans une configuration jamais vue est « figuré » plutôt que reset. Ces comportements, dit Generalist, sont hors training set et nourrissent la long-tail. Ils posent aussi un problème d’alignment incarné : secouer un sac, rattraper un objet qui tombe, réorganiser un plan de travail — utiles, ou hors process selon l’acheteur. Le succès robotique n’est pas universel ; il est workflow-specific.
Le contraste data est le second enjeu. Les modèles généraux qui passaient 90 %+ s’appuyaient jusqu’ici sur d’énormes corpora de téléopération, chers et peu scalables. Generalist affirme une existence proof inverse : pré-train humain wearable, puis 1 h de robot par tâche montrée. C’est, si ça tient hors blog, un changement de coût unitaire pour industrialiser une nouvelle SKU. Les limites sont écrites noir sur blanc : toutes les tâches tentées ne tapent pas 99 % ; certaines exigeraient encore plus de fiabilité ou de vitesse pour servir en vrai ; les chiffres 99 %, 500 000 h et le scaling sont self-reported, sans paper arXiv ni reproduction tierce au moment de l’annonce. Early access : partnerships@generalistai.com, dès le jour J.
Pourquoi ça compte
1. 64 % → 99 % en cinq mois est le vrai headline — s’il est borné. 99 % sur un set choisi (boîtes, phones, kitting, T-shirts, vacuums) n’est pas 99 % sur votre ligne. Mais l’écart avec le from-scratch (19 %) et GEN-0 (64 %) est le premier argument sérieux que le pré-train wearable + 1 h robot bat le régime téléop de masse. Un acheteur doit demander la liste des tâches qui échouent, pas seulement les six vidéos.
2. La vitesse 2,8× (12,1 s vs 34 s) change le P&L, pas seulement la démo. Un cycle trois fois plus court, plus rapide que les démonstrations humaines, et capable de réagir à une physique d’objet nouvelle : c’est le seuil où un poste packing / folding cesse d’être une curiosité. π 0 dans le même tableau (34 s) ancre le claim dans un SOTA nommé, pas dans un strawman.
3. 1 h de data robot / tâche = le levier d’industrialisation. Si l’adaptation embodiment+tâche tient, un intégrateur EU peut finetuner un poste en un shift, pas en trois mois de téléop. Le « 10× moins de data que GEN-0 » est le KPI à contracter en PoC : heures, succès, et qui possède les traces.
4. Improvisation = moat et risque légal. Regrasp bimanuel d’une washer, recovery T-shirt : c’est ce qui manque aux VLA « scriptés ». C’est aussi ce qui fait peur à un RSSI / HSE : le robot qui invente un moyen. Generalist le dit : il faut repenser l’alignment incarné — ce que le robot ne doit pas faire. Pour l’EU Act / machine regulation, c’est le dossier à ouvrir avant le early access.
5. Self-reported, pas déployé. Pas de partenaire hardware nommé, pas de customer production, poids closed, pas de model card. Le registre DEPLOY classe GEN-0/GEN-1 en maturité research. Lire 99 % comme « commercial viability unlocked » (claim Generalist) sans site nommé serait une erreur de due diligence. Early access ≠ GA.
Lecture Neurone21
Thèse courte : GEN-1 (2 avril 2026) est le premier jalon Generalist où la courbe scaling + wearable pretrain prétend sortir du labo : 99 % vs 64 %, ~3× plus vite (boîte 12,1 s vs ~34 s GEN-0 / π 0), ~1 h de data robot par tâche montrée, dataset 500k h, mastery = fiabilité × vitesse × improvisation. Ce n’est pas encore un cerveau d’usine livré clés en main. Pour une équipe FR/EU (intégrateur, OEM, logistique, fonds Physical AI) : (1) traiter GEN-1 comme un early-access modèle, pas comme un robot — demander embodiment supportés (6 / 7 / 16+ DoF) et le protocole des 99 % ; (2) contracter un PoC sur une tâche bornée avec budget ≤ 1–2 h de data et un critère d’arrêt (succès × temps × interventions) ; (3) exiger une policy d’alignment (interdits, reset, logging) pour l’improvisation ; (4) comparer à π 0 / GR00T / Skild sur le même objet, pas sur des reels ; (5) ne pas budgéter une flotte avant un site de référence hors blog.
À suivre : paper ou model card, premier partenaire named, GEN-2, reproduction tierce des 12,1 s / 99 %, et le coût réel de l’heure de data une fois hors labo San Mateo.
Sources : Generalist — GEN-1: Scaling Embodied Foundation Models to Mastery, 02/04/2026 · The Robot Report — Generalist introduces GEN-1, 03/04/2026 · SiliconANGLE — Generalist releases GEN-1, 06/04/2026.