Le fait
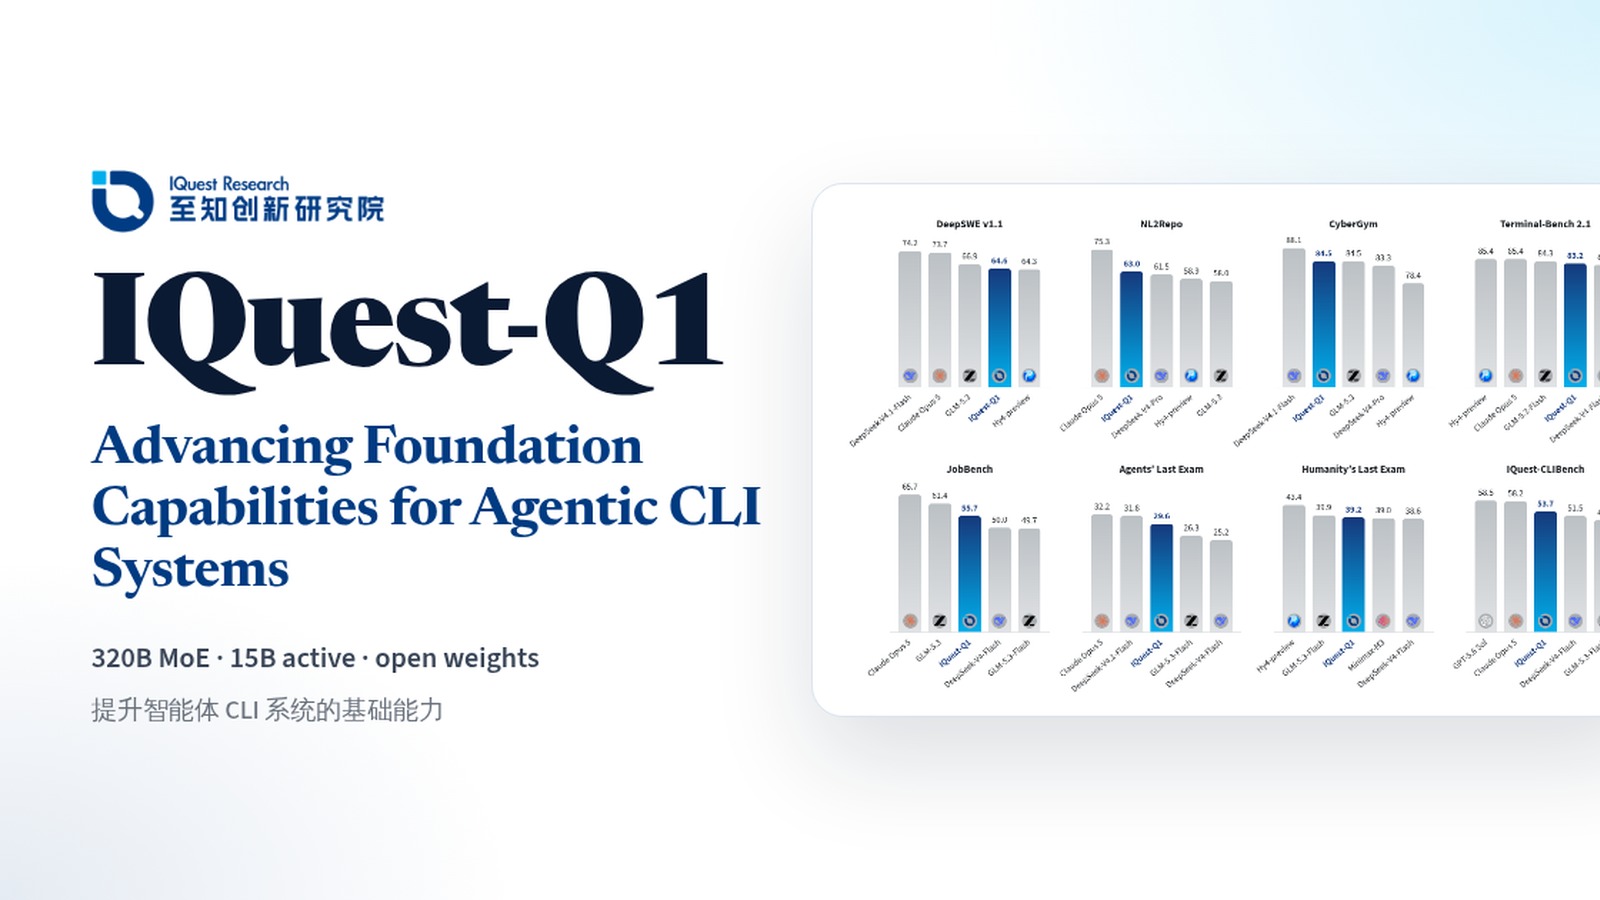
Le 9 octobre 2026, IQuest Research publie IQuest-Q1, un modèle conçu dès le départ pour le code agentique, le raisonnement et l’usage d’outils en plusieurs étapes. Les poids sont disponibles sur Hugging Face et GitHub, accompagnés de documents techniques.
L’architecture
Selon la fiche du modèle, IQuest-Q1 est un mélange d’experts (MoE) d’environ 320 milliards de paramètres, dont 15 milliards seulement sont activés pour chaque token. Il compte 88 couches, 256 experts dont 8 actifs, et alterne trois couches d’attention à fenêtre glissante (4 096 tokens) pour une couche d’attention complète. Son contexte atteint 524 288 tokens, de quoi charger un dépôt de code volumineux et de longues traces d’outils.
L’entraînement se fait en trois temps (pré-entraînement, mi-entraînement, post-entraînement), avec du fine-tuning supervisé et de l’apprentissage par renforcement. Selon AI Frontier Post, IQuest utilise aussi une distillation à partir de plusieurs modèles « professeurs » sur les propres essais du modèle élève.
Ce qu’il revendique
IQuest publie des résultats sur NL2Repo, CyberGym, Terminal-Bench 2.1, DeepSWE v1.1 et JobBench, en se comparant notamment aux versions officielles de DeepSeek-V4-Flash et Pro. Les démonstrations de lancement vont d’un jeu de tir à la première personne généré en une passe jusqu’au débogage d’un entraînement par renforcement déraillé, où le modèle a retrouvé un espace parasite inséré dans les données. Ces résultats sont ceux du laboratoire, sans évaluation indépendante à ce stade.
Les limites affichées
La fiche est franche : entrée texte uniquement, appels d’outils dans un format propre à IQuest, et sur les tâches réelles en ligne de commande le modèle « peut ignorer des contraintes, répéter des tentatives ratées ou laisser des problèmes non résolus », ce qui impose une supervision humaine. Le déploiement recommandé passe par SGLang ou vLLM sur 8 GPU en parallélisme tensoriel, avec Claude Code 2.1.140 ou Codex 0.142 comme harnais.
Lecture Neurone21
Le coût d’inférence d’un MoE à 15 milliards de paramètres actifs est attrayant, mais héberger 320 milliards de paramètres reste un projet d’infrastructure, pas un test sur un poste de développeur. Autre point à lire avant tout usage commercial : la licence, que GitHub classe dans la catégorie « other » selon AI Frontier Post. À suivre surtout pour les équipes qui veulent un agent de code auto-hébergé, hors des grands fournisseurs américains.