Titre original : What affects chain-of-thought monitorability across the model lifecycle?
Auteurs : Jeffrey G. Wang, Aiden Low, Zora Che, Holden Mui et Harshit Sikchi (contribution égale), Yong Zheng-Xin, Tomek Korbak (travail fait chez OpenAI), Bill Stavroulakis, Alex Barron, Shibani Santurkar, Kristian Georgiev, et Micah Carroll, Ben Sokolowsky, Katherine Lee et Jakub Pachocki (encadrement à parts égales).
Affiliation : OpenAI.
Publication : étude publiée le 10 novembre 2026 sur le blog de recherche en alignement d’OpenAI, hors arXiv et sans relecture extérieure.
Liens : l’étude.
L’idée en bref
Les modèles de raisonnement écrivent leur réflexion avant de répondre, ce qu’on appelle la chaîne de pensée. OpenAI s’en sert comme l’un des piliers de sa surveillance : on y lit souvent l’intention d’un modèle, y compris quand il s’apprête à mal se comporter. Pour certains modèles, dont ceux jugés critiques en cybersécurité, OpenAI dit surveiller les trajectoires complètes, chaîne de pensée comprise.
Avec GPT-6 Astra, l’entreprise a observé une baisse de cette surveillabilité. Elle a donc cherché ce qui, dans la fabrication d’un modèle, la fait varier. Comme on ne peut pas mesurer directement la capacité d’un modèle à tromper son surveillant, l’étude suit deux indicateurs indirects : la capacité à raisonner sans chaîne de pensée, et la capacité à contrôler ce qu’on écrit dans cette chaîne quand on le lui demande.
Ce que montre le papier
Le préentraînement
Sur des modèles internes et publiés, de GPT-5 (août 2025) à la classe Astra (septembre 2026), la capacité à raisonner sans chaîne de pensée suit de près la qualité du modèle de base, mesurée par sa perplexité sur des données de test. L’étude rappelle que l’institut britannique de sécurité de l’IA avait jugé Astra hors tendance, avec un horizon médian de 30,9 minutes sur des questions de maths sans chaîne de pensée, quand la projection prévoyait environ 7 minutes d’ici fin 2028. Rapporté à la perplexité, Astra n’est pas hors tendance, selon OpenAI. La contrôlabilité suit aussi la perplexité, mais plus faiblement.
L’architecture
En comparant trois familles d’architectures à perplexité égale, la perplexité explique la plupart des résultats sans chaîne de pensée. Sur la planification et les calculs en plusieurs étapes, une des architectures fait nettement mieux que ce que prédit sa perplexité. Les détails des modèles ne sont pas publiés.
L’apprentissage par renforcement et la transmission
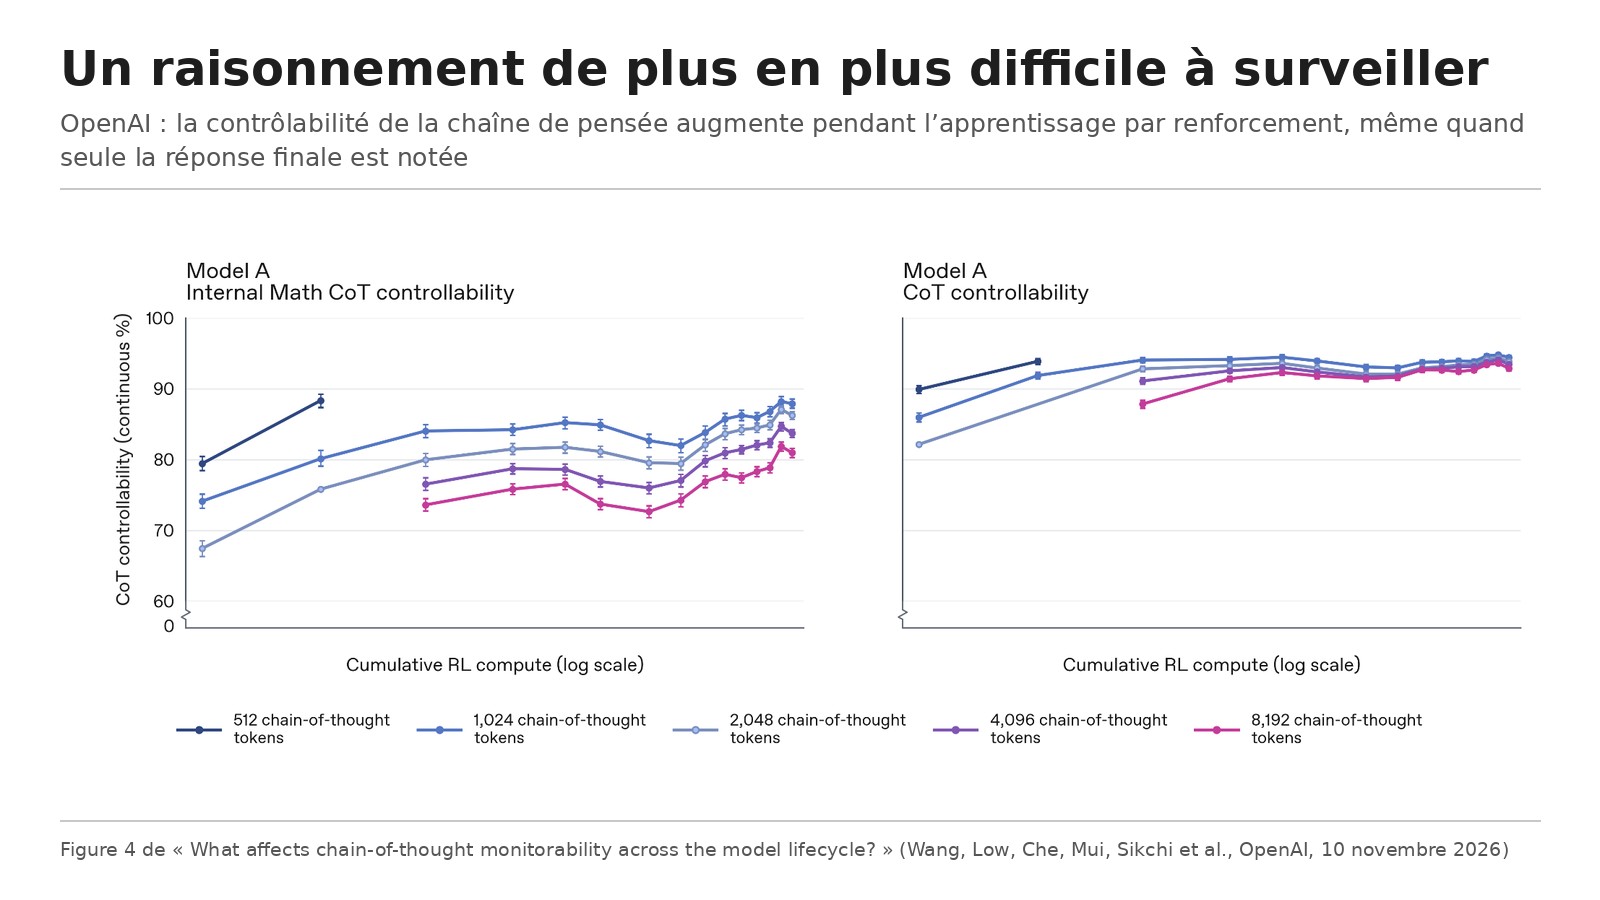
Pendant l’apprentissage par renforcement d’un modèle de classe Astra, la contrôlabilité augmente nettement, même quand seule la réponse finale et la longueur sont notées. OpenAI dit avoir vérifié qu’aucune récompense ne portait par accident sur la chaîne de pensée. Donner au modèle un terminal et un navigateur, avec des correcteurs qui voient leur usage, l’augmente seulement un peu plus. Enfin, deux modèles professeurs aux capacités proches mais à la contrôlabilité différente ont servi à entraîner deux copies du même modèle : l’élève du professeur le plus contrôlable devient lui-même plus contrôlable.
Les limites
OpenAI les signale. Les deux indicateurs sont des substituts imparfaits, et la mesure de contrôlabilité est bruitée : elle repose sur cinq consignes simples, comme écrire « meow » entre chaque mot ou tout écrire en majuscules. Dans une annexe, le modèle le plus contrôlable de la paire n’échoue pas plus souvent à tromper le surveillant que l’autre, et réussit même moins bien à cacher une sous-performance volontaire. Les expériences ne séparent pas complètement l’effet de la perplexité et celui de la supervision. L’étude ne donne ni la taille des modèles ni leurs données, et n’a pas été relue à l’extérieur.
Lecture Neurone21
Pour un régulateur ou une entreprise qui compte sur la lecture du raisonnement d’un modèle pour l’auditer, le signal mérite attention : c’est le fabricant lui-même qui dit que ce levier va s’affaiblir avec les prochaines générations. Les obligations de transparence et de supervision humaine, comme celles de l’AI Act pour les systèmes à haut risque, ne peuvent pas reposer uniquement sur cette fenêtre.
La transmission par les données d’entraînement est le point le plus concret : un trait du modèle professeur passe à l’élève sans qu’on l’ait demandé. Toute organisation qui affine un modèle sur des sorties d’un autre modèle hérite aussi de comportements qu’elle n’a pas choisis.
D’où vient ce papier
Elvis Saravia (@omarsar0) l’a recommandé le 11 novembre 2026 à 21:44 heure de Paris, en citant le fil de Jeffrey G. Wang, premier auteur. Nous avons lu l’étude officielle sur le blog d’OpenAI. Écarts avec le post :
Elvis Saravia résume que les modèles plus intelligents sont plus difficiles à surveiller par leur chaîne de pensée. C’est bien la conclusion d’OpenAI, mais elle repose sur des indicateurs indirects, et l’étude montre elle-même un cas où le modèle le plus contrôlable ne trompe pas mieux son surveillant. Ce n’est pas un papier relu par des pairs, et l’essentiel de ses résultats n’est donné que sous forme de figures.
Pour aller plus loin
- L’étude d’OpenAI : https://alignment.openai.com/cot-monitorability-model-lifecycle/
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2120618625568526500
- Le fil de Jeffrey G. Wang : https://x.com/jeffreygwang/status/2120581630196879460
- Notre fiche sur le contrôle du raisonnement par les premiers jetons : /p/controle-raisonnement-ia-premiers-tokens