Le fait
Le 31 août 2026, Skild AI publie S1, son foundation model robotique phare, conçu dès l’origine comme un apprenant in-context (in-context learning, ICL) pour la manipulation. La thèse produit, développée sur le blog Skild et relayée par The Robot Report et le blog NVIDIA, est radicale pour le secteur : montre une vidéo d’une tâche — courte ou longue, vue ou jamais vue en pré-entraînement — et le robot l’exécute, sans fine-tuning, sans post-training, sans changer les poids. Une seule passe de démonstration visuelle suffit à conditionner la policy.
S1 vise explicitement le plafond que les VLA « language-prompted » peinent à franchir : des tâches long-horizon jusqu’à environ 10 minutes, avec des dizaines d’étapes de manipulation, hors distribution de pré-entraînement. Démonstrations publiques mises en avant : rempotage (plant potting), préparation de pancakes (y compris le flip), café pour-over, assemblage de kits. Skild affirme n’avoir trouvé aucun exemple de flip dans ses millions d’heures de données — le geste aurait émergé de la correspondance visuelle spatule / mouvement. Deepak Pathak (co-fondateur & CEO) insiste : ce ne sont pas des micro-tâches de 3–4 secondes ; c’est de la composition longue.
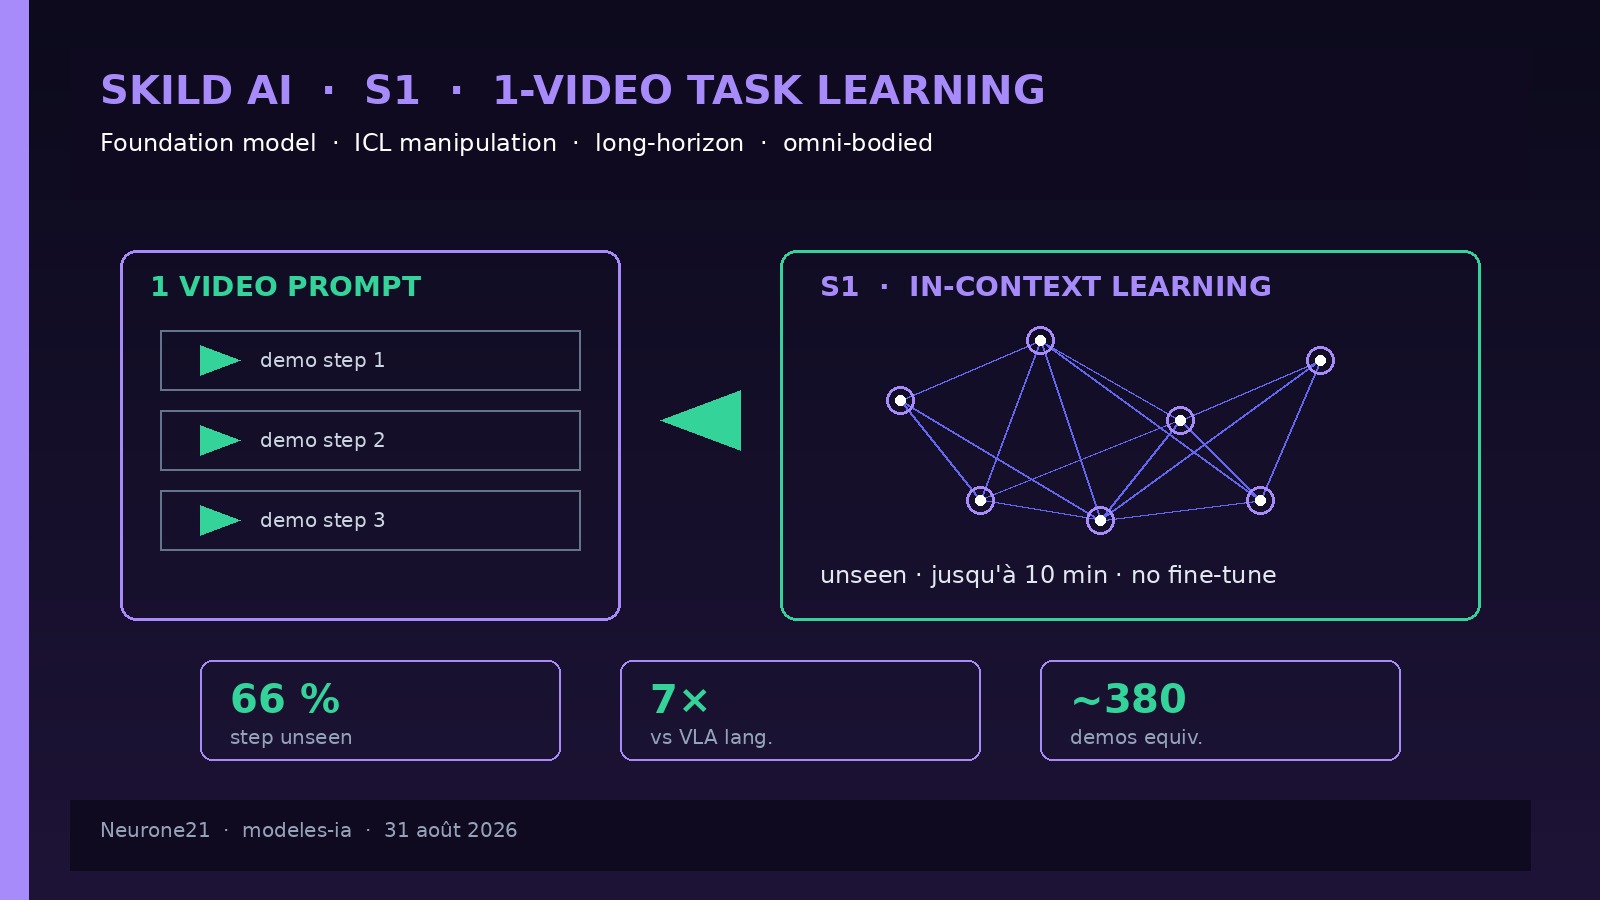
Chiffres internes mis en avant dans l’analyse ICL : sur tâches unseen multi-étapes, succès step-level d’environ 66 % pour S1 en ICL, contre ~9 % pour une baseline VLA conditionnée par le langage entraînée sur les mêmes données / même échelle (jusqu’à 100k heures de pré-entraînement dans l’étude de scaling) — soit un gain d’ordre 7×. Sur tâches seen, l’ICL atteint jusqu’à ~96 % à grande échelle. Autre métrique choc : une seule démo en contexte vaudrait environ 380 épisodes de post-training téléop pour approcher le même niveau sur tâches nouvelles (collecte estimée 50–100 heures de téléopération pour ces horizons 4–10 min). Chronologie type rempotage : de l’arrivée du matériel à l’exécution autonome, ~11 minutes une fois la scène prête — dont une vidéo égocentrique humaine.
Skild, fondée en 2023, a levé près de 1,7 milliard de dollars pour un « cerveau robot généraliste ». S1 s’appuie sur l’infrastructure NVIDIA (données synthétiques, training, simulation, déploiement). Le modèle est présenté comme omni-bodied (bras fixe, quadrupède, humanoïde — avec plus d’effort humanoïde à venir). Pathak souligne aussi l’acquisition Fetch Robotics (talents déploiement) et annonce des preuves production « dans les semaines » suivantes. La timeline interne Skild : LocoFormer (locomotion ICL, sept. 2025) → premiers ICL in-domain manipulation (fév. 2026) → premier pancake OOD (mai 2026) → release S1 (août 2026).
Contexte
La robotique encore coincée à l’ère BERT. Skild pose l’analogie LLM : BERT comprenait le langage mais chaque appli exigeait fine-tuning ; ChatGPT a basculé grâce au prompting / ICL. En robotique, on sait apprendre des comportements complexes en deep learning, mais une nouvelle tâche robuste demande encore des heures / dizaines d’heures de données et un fine-tune spécialiste. Pire : quand le post-training est assez dense, des policies from scratch peuvent rattraper un foundation model post-entraîné (résultat cité Oh et al., 2026). D’où la question Skild : à quoi sert le pré-entraînement, si ce n’est à activer l’ICL ?
Vidéo plutôt que langage pour spécifier la tâche. Pour une action atomique (« passe-moi la tasse »), le langage suffit. Pour plier un drap-housse, monter des blancs en neige ou enchaîner un café pour-over, l’humain montre. S1 aligne la robotique sur ce réflexe : la démo vidéo entre dans la fenêtre de contexte ; la policy mappe intention, objets et progression vers les actions de son embodiment et de sa scène. Concurrentement, Generalist AI (2026) et Jiang et al. / RoboTTT (2026) explorent l’ICL manipulation, mais Skild revendique la première démonstration ICL sur tâches extrêmement long-horizon et jamais vues en pré-entraînement.
Data engine multi-sources. Aucune source ne gagne à la fois proximité hardware, diversité et scalabilité : téléop (proche, peu scalable), vidéos humaines / égocentriques (scalables, gros domain gap), gants de capture, simulation. Pathak : il n’y a pas de golden path ; Skild combine les quatre. Qualité revendiquée : pour 1 $ de collecte, 3 $ de contrôle qualité (précision bas niveau, cohérence de tâche, fidélité d’annotation).
Propriétés émergentes. Au-delà du scoring step : robustesse aux perturbations (objets déplacés, lighting, swaps), récupération d’erreurs, « common sense » (utiliser une tasse si l’arrosoir de la démo n’est pas là ; compléter un verre déjà presque plein), et parfois correction d’une démo fautive (œuf mal lâché dans le prompt → geste contrôlé en exécution). L’ICL traite la démo comme spécification de but, pas comme trajectoire à cloner. Sur l’axe distribution shift L1–L5, les policies ICL se dégradent nettement moins que les VLA langage quand il faut changer de plan moteur (bras opposé, nouveaux objets à affordance similaire).
Pas encore le « ChatGPT moment » grand public. Pathak le dit clairement : ce n’est pas prêt pour un déploiement massif à domicile ; c’est le premier signe de la trajectoire. Priorité parallèle : déploiements clients (Fetch, partenaires commerciaux) et flywheel données live → pré-entraînement.
Pourquoi ça compte
1. Changement de paradigme déploiement. Minutes entre démo et autonome vs 50–100 h de téléop pour ~380 épisodes : le coût d’introduction d’une nouvelle SKU / process / poste bascule. Les usines et entrepôts qui changent de tâches chaque semaine deviennent enfin adressables sans équipe ML permanente.
2. Scaling laws ICL favorables sur l’OOD. L’écart ICL vs VLA langage s’élargit avec l’échelle de pré-entraînement sur tâches unseen. C’est un argument d’investissement data : chaque heure supplémentaire achète plus de primitives et de composition, pas seulement du mémorisation in-distribution.
3. Pression sur les VLA language-only. Les stacks qui ne font que du prompt texte pour de la manipulation longue et nouvelle devront expliquer leur gap 7× step-success — ou ajouter sérieusement du conditioning vidéo.
4. Omni-embodiment = un cerveau, plusieurs corps. Si S1 tient sur bras, quadrupèdes et (bientôt) humanoïdes, les acheteurs peuvent rationaliser la couche policy. Attention au marketing : les résultats « membre cassé / adaptation » cités par Pathak viennent d’une version antérieure ; le scale humanoïde reste un chantier.
5. Flywheel commercial × recherche. Démo rapide → robots en prod → données réelles → meilleur S1. Couplé à ~1,7 Md$ levés et à Fetch pour le déploiement, Skild joue la carte frontier + go-to-market, pas le paper-only.
6. Barème d’évaluation du secteur. Long-horizon + OOD + single video devient le nouveau minimum pour juger un foundation model robotique en 2026–2027. Les démos 5 secondes in-distribution ne suffisent plus à convaincre un comité CapEx.
Lecture Neurone21
Thèse courte : S1 est la tentative la plus claire à ce jour de faire faire à la manipulation robotique le saut BERT → GPT via l’in-context learning vidéo. Une démo, pas de retrain, horizons jusqu’à 10 minutes, y compris des gestes absents du pré-entraînement : si les chiffres 66 % / 7× / ~380 démos se confirment hors labo Skild, le goulot historique du post-training par tâche se fissure. Pour un décideur FR/EU (industrie, logistique, electronics assembly, service), le sujet n’est pas la pancake virale : c’est si l’ICL survit au bruit d’usine (occlusions, interruptions, opérateurs, conformité).
Checklist dil dig / PoC : (1) reproductibilité des tâches OOD sur votre hardware (pas seulement bras Skild) ; (2) taux de succès bout-en-bout (pas seulement step avec intervention humaine — l’étude ICL utilise des interventions pour noter le baseline VLA) ; (3) latence et taille de contexte vidéo admissible en edge vs cloud ; (4) safety : ICL qui « improvise » un flip pancake en labo ≠ validation ISO / cellulaire ; (5) data governance — les déploiements clients nourrissent-ils le modèle global (Pathak : quand les contrats le permettent) ; (6) positionnement vs Helix / GR00T / π / Generalist sur un même panel long-horizon ; (7) coût inference + stack NVIDIA requis ; (8) roadmap humanoïde réelle vs omni-bodied slide.
À suivre : preuves production annoncées pour septembre 2026, métriques clients nommées, papers / détails d’entraînement promis dans la série de posts Skild, et réactions concurrentes (ICL vidéo chez les grands VLA). Tant que les évaluations restent internes avec recovery humaine sur le baseline, S1 est un signal de paradigme extrêmement fort — pas encore une commodité déploiement. Mais le sens de l’histoire est clair : montrer une fois bat téléopérer trois cents fois.
Sources : Skild AI — Introducing S1: In-Context Learning for Robotics · The Robot Report — Skild AI unveils S1, 31/08/2026 · NVIDIA Blog — Skild AI S1, teach robots from a single video. Image : cover Neurone21 (synthèse éditoriale).