Titre original : AgentBaton: Efficient Model Collaboration in Agentic Tasks
Auteurs : Junlong Li (HKUST), Jindong Jiang, Yonggan Fu, Jiarui Yao (université de l’Illinois à Urbana-Champaign), Hanrong Ye, Wonmin Byeon, Peter Belcak, Hao Zhang et Pavlo Molchanov, NVIDIA. Junlong Li et Jiarui Yao ont mené ce travail en stage chez NVIDIA ; Jindong Jiang, Yonggan Fu et Hanrong Ye sont responsables du projet.
Publication : prépublication arXiv 2610.35959v1 (cs.MA), déposée le 25 octobre 2026, 16 pages avec annexes. Le PDF ne mentionne pas de publication du code ni du détecteur.
Liens : page arXiv, PDF.
L’idée en bref
Un agent de code qui résout un ticket passe par des phases inégales : comprendre le dépôt et trouver la cause demande un modèle puissant, mais une fois le diagnostic posé, appliquer le correctif, relancer les tests et vérifier peut souvent être fait par un modèle beaucoup moins cher. AgentBaton organise un seul passage de relais, du modèle coûteux vers le modèle économique, au bon moment.
Le moment est choisi par un petit détecteur, un modèle Qwen 3.5 de 2 milliards de paramètres affiné pour lire la trajectoire de l’agent et dire si le travail restant est surtout de la réparation et de la validation localisées (sections 3 et 4).
Ce que montre le papier
Le sens du relais compte
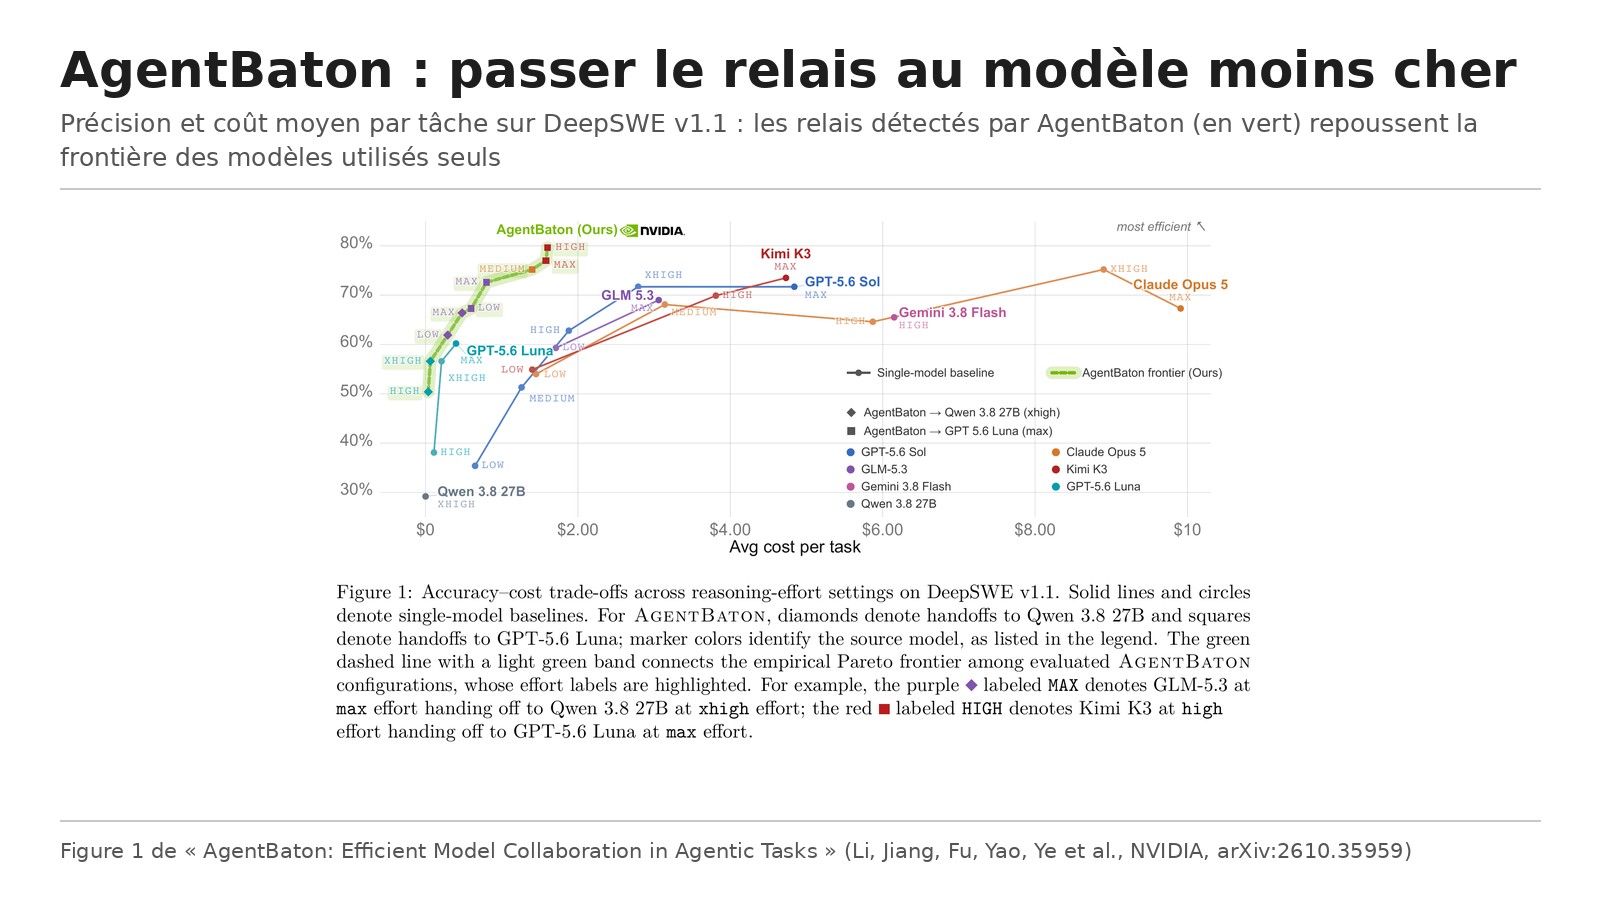
Les auteurs testent d’abord des relais à un moment fixe sur DeepSWE v1.1 (113 tâches), avec l’agent mini-SWE-agent. Commencer avec le petit modèle et finir avec le gros préserve la précision mais économise peu : en passant de Qwen 3.8 27B à GPT-5.6 Sol à 30 % du parcours, la précision atteint 70,80 %, contre 68,10 % pour Sol seul, mais le coût ne baisse que de 6,1 %. Dans l’autre sens, les économies sont nettes : Kimi K3 relayé par Qwen à 45 % du parcours obtient 72,57 % contre 73,45 % seul, pour 61,5 % de coût en moins ; GLM-5.3 relayé à 30 % garde 61,1 % pour 82,4 % de coût en moins (section 3).
Demander au modèle de passer la main ne marche pas
Avec une simple consigne de passer la main quand il est prêt, Kimi K3 ne le fait jamais (0 tâche sur 113) et GLM-5.3 dans 6 cas seulement. GPT-5.6 Sol le fait à chaque tâche, mais son coût moyen reste de 3,75 dollars par tâche contre 5,32 dollars seul, avec une précision de 62,8 % (section 4.1, tableau 2). D’où l’idée d’un détecteur externe.
Un détecteur léger, entraîné sur 4 000 trajectoires
Le détecteur est entraîné sur 4 000 trajectoires (2 000 tâches SWE-rebench V2, deux modèles), dont le meilleur point de relais a été annoté par Codex, l’agent de code d’OpenAI. L’entraînement a utilisé 16 GPU NVIDIA H100 avec NeMo Automodel. Sur un seul H100, une décision prend 338 millisecondes en médiane et 1,11 seconde au 95e centile, pour des historiques de 2 000 à 121 000 tokens (section 4.2).
65,9 % de coût d’API en moins, avec des résultats inégaux
Sur 11 paires de modèles et deux bancs d’essai (DeepSWE v1.1 et Terminal-Bench 2.1), le coût d’API baisse de 65,9 % en moyenne. Dans 12 des 22 combinaisons, la précision progresse ou recule de moins de 5 % en relatif (tableau 3). Quelques cas illustrent l’écart :
- Kimi K3 relayé par Qwen 3.8 27B sur DeepSWE : 72,6 % contre 73,5 % seul, pour 72,9 % de coût en moins.
- Claude Opus 5 relayé par GPT-5.6 Luna sur DeepSWE : la précision passe de 67,3 % à 76,1 % (+8,8 points) pour 70,5 % de coût en moins. Avec Luna comme receveur, quatre des cinq gros modèles font mieux que seuls sur DeepSWE.
- GPT-5.6 Sol relayé par Qwen sur DeepSWE : 60,2 % contre 68,1 % seul, soit 11,6 % de perte relative, pour 80,8 % de coût en moins.
- Même un modèle déjà économique gagne à passer la main : GPT-5.6 Luna relayé par Qwen coûte 75,0 % de moins sur DeepSWE et 42,9 % de moins sur Terminal-Bench, avec des pertes relatives de 7,3 % et 5,7 %.
Mieux que les routeurs existants
Un routeur qui choisit le modèle dès le départ, à partir de l’énoncé de la tâche, n’envoie au petit modèle qu’une seule tâche sur l’ensemble, et n’économise donc presque rien. Face à MTRouter, qui choisit le modèle à chaque tour, AgentBaton coûte 46,7 à 86,6 % de moins pour une précision égale ou supérieure (section 4.4). Sur la frontière coût et précision de DeepSWE, Kimi K3 relayé par Luna atteint 79,6 % pour 1,60 dollar par tâche, au-dessus du meilleur modèle seul testé, Claude Opus 5 en effort maximal, à 75,2 % pour 8,90 dollars (section 4.5).
Les limites
Le papier ne contient pas de section consacrée aux limites. Réserves de notre lecture, tirées du papier :
- Le coût du modèle local Qwen 3.8 27B est compté à zéro par convention (section 2) : les économies annoncées portent sur l’API seulement, sans le matériel, l’électricité ni l’exploitation du modèle local.
- Les essais portent uniquement sur des tâches de code et de terminal ; rien ne dit que la méthode se transpose à d’autres usages d’agents.
- Les points de relais d’entraînement sont annotés par un autre agent (Codex), pas par des humains, et le détecteur est entraîné sur SWE-rebench V2, proche des tâches évaluées.
- Dans 10 des 22 combinaisons, la perte de précision dépasse 5 % en relatif, jusqu’à 11,6 % ; le choix de la paire de modèles reste déterminant.
Lecture Neurone21
Pour une entreprise qui fait tourner des agents de code, ou plus largement des agents sur des tâches longues, le message est pratique : la question n’est pas « quel modèle choisir », mais « à quel moment changer de modèle ». Le gros modèle sert à comprendre et à décider, le petit à exécuter et vérifier. C’est le même raisonnement que celui d’une équipe humaine où un expert pose le diagnostic et confie la réalisation.
L’intérêt est encore plus fort quand le modèle économique tourne en local, comme dans les déploiements d’IA sur site que nous suivons avec Nemotron 3.5 pour des agents locaux : la facture d’API baisse fortement et le travail de fin de tâche reste dans l’entreprise. Il faut toutefois chiffrer soi-même le coût du matériel local, que le papier ne compte pas. Pour d’autres leviers de coût des agents, voir aussi la taxe de la mémoire des agents.
Le post de DAIR.AI, repris par Elvis Saravia, cite correctement les 65,9 %, les 11 paires, les 338 millisecondes et le gain de 8,8 points. Deux nuances : les 65,9 % sont des économies d’API, le modèle local étant compté gratuit ; et « en préservant largement la précision » recouvre des situations inégales, puisque près de la moitié des combinaisons perdent plus de 5 % en relatif. Le papier est bien un travail NVIDIA, mené en partie par des stagiaires de HKUST et de l’université de l’Illinois.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2610.35959
- Le PDF : https://arxiv.org/pdf/2610.35959v1
- Le post de DAIR.AI, repris par Elvis Saravia : https://x.com/dair_ai/status/2115888920860958961
- La page Chat with Paper de DAIR.AI Academy : https://academy.dair.ai/papers/agentbaton-efficient-model-collaboration-in-agentic-tasks-2610.35959