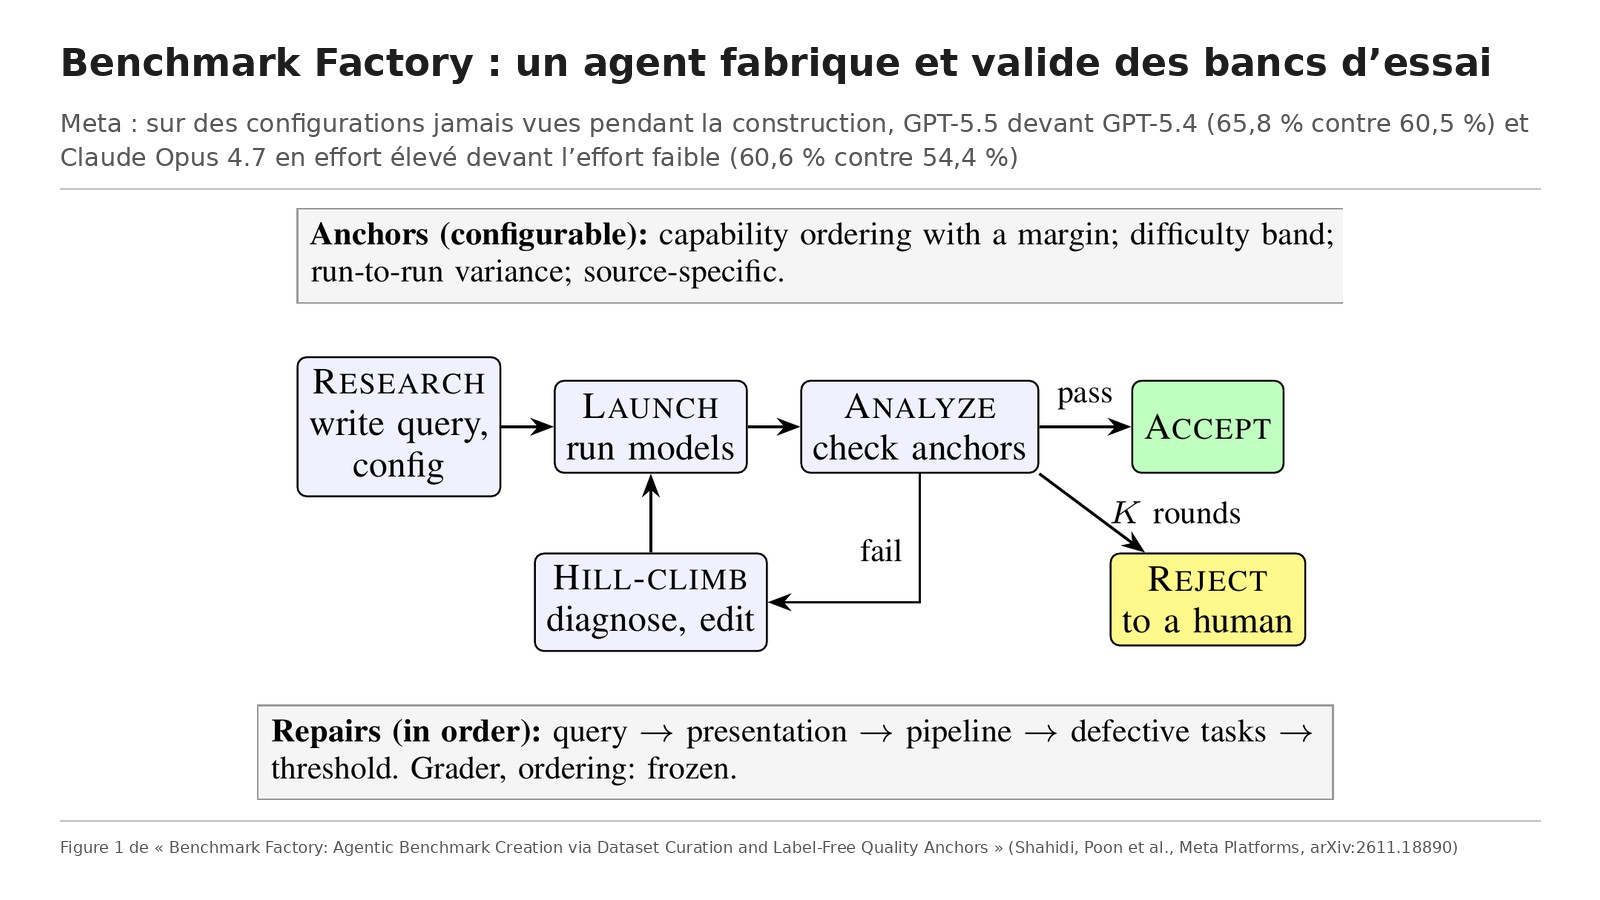
Titre original : Benchmark Factory: Agentic Benchmark Creation via Dataset Curation and Label-Free Quality Anchors
Auteurs : Shervin Shahidi et James Poon (contribution égale), Hang Xie, Kenneth O. Xu, Robin Håkanson, Vikram Nair, Jens Pillgram-Larsen et Nachiappan Nagappan.
Affiliation : Meta Platforms.
Publication : prépublication déposée sur arXiv le 13 novembre 2026 (2611.18890v1, 5 pages), préparée pour l’atelier AGENT 2027. Les bancs contiennent du code interne de Meta et ne seront pas publiés ; le papier décrit la procédure, les réglages des ancres et les analyses, sans dépôt de code.
Liens : page arXiv, PDF, version HTML.
L’idée en bref
Une équipe qui confie des modifications de code à des agents a besoin de les mesurer sur son propre code : ses applications, ses frameworks internes, ses dépôts. Les bancs publics comme SWE-bench ne couvrent pas ce travail, et vérifier à la main chaque tâche d’un banc maison coûte cher. Fabriquer automatiquement un banc à partir de l’historique des modifications pose un autre problème : un banc trop facile, trop dur ou trop bruité fausse en silence toutes les comparaisons faites dessus.
Benchmark Factory fait de la construction du banc une tâche d’agent. Un « méta-agent » (un agent qui fabrique des bancs pour d’autres agents) écrit la requête qui va chercher des tâches dans les modifications fusionnées, lance une échelle de modèles dont la force relative est connue, lit les résultats tâche par tâche, et n’accepte le banc que s’il respecte des « ancres de qualité » qui ne demandent aucune étiquette humaine par tâche. Sinon, il diagnostique et répare.
Ce que montre le papier
Comment la boucle fonctionne
Une tâche est une modification de code réellement fusionnée : l’agent testé reçoit son titre et son résumé, et travaille sur la version d’avant. Comme ces dépôts sont privés, les modèles publics ont peu de chances d’avoir vu les correctifs à l’entraînement. Faute de tests, un modèle correcteur (GPT-5.5) note de 0 à 100 le correctif de l’agent par rapport au correctif fusionné, et un seuil décide de la réussite.
Le méta-agent repart d’un contexte neuf à chaque itération et garde son état dans un fichier, pour que les longues sessions ne se dégradent pas. Chaque candidat passe par quatre phases : recherche dans les données de production et écriture de la requête, lancement d’un passage par modèle testé, analyse (séparer les pannes d’infrastructure des vrais échecs, vérifier les ancres), puis acceptation, réparation, ou rejet après cinq tours avec renvoi à un humain.
Les ancres sont des vérifications posées à l’avance sur les taux de réussite. L’ordre de capacité : les modèles sont rangés en paliers, et chaque modèle d’un palier supérieur doit faire au moins 5 points de mieux que ceux d’un palier inférieur. La bande de difficulté : chaque taux doit rester entre 10 % et 85 %, pour éviter un banc saturé. Une partie des tâches (20 %) est mise de côté, figée par une empreinte vérifiée à chaque itération, et ne sert jamais à accepter ni à réparer. Les réparations suivent un ordre fixe, des moins capables d’adapter le banc aux modèles vers les plus risquées : réécrire la requête, changer la présentation des tâches, corriger la chaîne d’exécution, retirer une tâche seulement si elle est défectueuse, et toucher au seuil en dernier. Le correcteur et l’ordre attendu des modèles ne sont pas des leviers de réparation.
Cinq bancs construits pour cinq groupes d’équipes
Les auteurs ont construit des bancs pour cinq groupes d’équipes de Meta, chacun couvrant un domaine produit, plusieurs langages, en monodépôt ou multidépôts. Les modèles de référence étaient Claude Opus 4.7 en palier haut, Opus 4.6 et Sonnet 4.6 au milieu, Opus 4.5 en bas (Opus 4.8 pour le cinquième groupe, construit un mois plus tard). Cinq bancs ont été acceptés et un candidat rejeté ; quatre des cinq ont demandé des réparations, au total 8 changements de requête, 5 de seuil, 3 corrections d’infrastructure et 1 de prompt, plus trois changements de correcteur ou d’ordre attendu dans le groupe de développement.
Un exemple : dans un groupe, Opus 4.7 et Sonnet 4.6 réussissaient 70 % et 68 % des tâches au départ, trop proches pour la marge. Le méta-agent a réorienté la requête vers des modifications plus grosses (3 à 6 fichiers, au moins 50 lignes), ce qui a remplacé 81 des 96 tâches et séparé les deux modèles (67 % contre 59 %). Un tour fait tourner quatre modèles sur environ 120 tâches, soit quelque 480 exécutions d’agent, en quelques heures selon le parallélisme ; un banc a été accepté après environ 960 exécutions, un autre après environ 2 400.
Une relecture par des experts
Trois ingénieurs de Meta ont relu un échantillon de 30 tâches (5 % des quelque 600 tâches des cinq bancs), une personne par tâche. La qualité des tâches obtient 2,3 sur une échelle de 1 à 3 (15 bonnes, 9 acceptables, 6 mauvaises) et celle des verdicts du correcteur 2,6 : sur 58 verdicts, 40 corrects (69 %), 13 discutables et 5 faux (9 %). Les cinq verdicts faux sont tous des échecs injustes, sur des tâches dont la description omettait des détails présents dans le correctif fusionné. C’est le principal défaut relevé : les tâches mal spécifiées, que les ancres ne peuvent pas voir puisqu’elles pénalisent tous les modèles à égalité.
Les bancs acceptés classent des configurations qu’ils n’ont jamais vues
Après acceptation, chaque banc a été figé, puis rejoué sur un nouveau tirage de 42 à 150 tâches par groupe, avec deux facteurs absents de la construction : une autre famille de modèles (GPT-5.4 et GPT-5.5, dans un autre harnais) et l’effort de raisonnement d’Opus 4.7. Sur l’ensemble des groupes, GPT-5.5 réussit 65,8 % des tâches et GPT-5.4 60,5 %, soit +5,3 points (intervalle de confiance à 95 % de +1,6 à +8,9 ; p = 0,004 ; 552 tâches). Opus 4.7 en effort élevé réussit 60,6 % des tâches contre 54,4 % en effort faible, soit +6,2 points (p = 0,002 ; 551 tâches). L’écart d’effort est positif dans les cinq groupes, celui des GPT dans quatre sur cinq : 9 comparaisons par groupe sur 10 vont dans le sens attendu. Les deux écarts résistent à une correction pour comparaisons multiples, au retrait du groupe de développement et à celui des tâches communes avec la construction ; ils restent positifs quand on retire n’importe quel groupe, mais l’écart GPT n’est plus significatif sans le cinquième groupe (+3,4 points, p = 0,07). L’effort « très élevé » n’apporte rien de plus que l’effort élevé (−2,2 points, non significatif) malgré 20 % de tours et 31 % de tokens de sortie en plus.
Les ancres rejettent les bancs cassés
Les auteurs ont testé des bancs volontairement défectueux. En mélangeant les résultats de quatre configurations d’un même modèle pour qu’aucun ordre réel n’existe, un tirage au hasard passe les ancres dans au plus 0,22 % des cas en une tentative et 1,4 % en cinq tentatives, pour le groupe le moins favorable (20 000 simulations). Un banc de modifications triviales (un fichier, au plus 5 lignes) est saturé à 91-95 % et rejeté. Les correcteurs cassés sont tous rejetés : références mélangées (tout à zéro), correcteur qui lit seulement le compte rendu de l’agent ou ignore le correctif de référence (90 à 100 % de réussite), note fondée sur la seule longueur, seuil abaissé à 10 sur 100. Sur des soumissions dégénérées, le correcteur valide le correctif fusionné dans 100 % des cas, rejette un correctif vide, celui d’une autre tâche ou un remplissage de même taille dans 100 % des cas, et valide 8 à 28 % des correctifs à moitié faits.
Les limites
Les auteurs les détaillent. Tous les bancs viennent d’une seule entreprise et aucun banc écrit à la main n’existe pour ces dépôts ; l’échantillon relu par des experts est petit, relu par une seule personne par tâche, et les relecteurs voyaient le nom des modèles et le raisonnement du correcteur. L’ordre de capacité des modèles est une hypothèse, que les tests hors échantillon atténuent sans l’éliminer. Le correcteur est GPT-5.5 : il pourrait favoriser GPT-5.5 dans la comparaison entre familles (pas dans celle de l’effort, où les deux bras sont le même modèle Claude). Les ancres sont nécessaires, pas suffisantes : sur un nouveau tirage de 52 tâches, elles rejettent même le vrai correcteur, faute de tâches assez nombreuses pour séparer les modèles, et seule la bande de difficulté arrête certains correcteurs complaisants, si bien qu’un seuil laissé libre pourrait les laisser passer. Le groupe de développement montre aussi le risque d’une boucle autonome : un identifiant de modèle invalide a donné 0 % à Opus 4.5, le méta-agent l’a pris pour un manque de capacité et a abaissé le seuil de 80 à 60, et l’acceptation obtenue a dû être retirée. Enfin, rien n’est reproductible de l’extérieur : données, bancs et code restent internes.
Lecture Neurone21
Pour une entreprise qui adopte des agents de code, la question « lequel marche le mieux chez nous ? » ne trouve pas de réponse dans les classements publics. Ce papier donne une méthode pour construire un banc maison à partir de ses propres modifications fusionnées, et surtout une façon de vérifier qu’il mesure quelque chose : exiger qu’il retrouve l’ordre de modèles dont on connaît déjà la force, et qu’il ne soit ni saturé ni impossible. Ces garde-fous sont simples à reprendre sans l’infrastructure de Meta. Trois leçons valent au-delà : vérifier la santé des exécutions (tours, appels d’outils, tokens) avant de lire un score, toucher au seuil en dernier, et garder un humain à chaque acceptation. La relecture montre où porter l’effort humain : sur la rédaction des tâches, car une tâche mal décrite fait échouer tout le monde et aucun contrôle automatique ne le voit. Le résultat sur l’effort de raisonnement est aussi utile pour le budget : au-delà du niveau élevé, payer plus de tokens n’a rien rapporté sur ces bancs.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.18890v1. Les chiffres principaux sont conformes au papier : 60,6 % contre 54,4 % pour Opus 4.7 en effort élevé et faible, 65,8 % contre 60,5 % pour GPT-5.5 et GPT-5.4, 9 comparaisons sur 10 dans le bon sens, 1,4 % au plus de faux passages. Trois précisions. Le chiffre de 1,4 % est le cas le moins favorable sur cinq tentatives successives, pour le groupe le moins favorable (0,22 % au plus en une tentative), et il porte sur quatre configurations d’effort d’un même modèle dont les résultats sont mélangés, pas sur des modèles différents permutés. Les 9 comparaisons sur 10 se font par groupe d’équipes travaillant sur un même domaine produit (cinq groupes, deux comparaisons chacun), pas par équipe. Enfin, le correcteur qui note toutes les tâches est lui-même GPT-5.5, ce que les auteurs signalent comme un biais possible dans la comparaison entre GPT-5.5 et GPT-5.4.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.18890
- Le PDF : https://arxiv.org/pdf/2611.18890
- Notre dossier sur le harnais d’agent IA, pourquoi il compte autant que le modèle : /p/harnais-agents-ia-pourquoi-comment-commencer-dossier
- Notre fiche sur la relecture indépendante des agents de code : /p/verification-harnais-agents-critique
- Notre fiche sur un agent de code simple face aux systèmes multi-agents chez Apple : /p/apple-ml-agents-coding-simples-vs-multi
- Notre page Meta : /wiki/meta