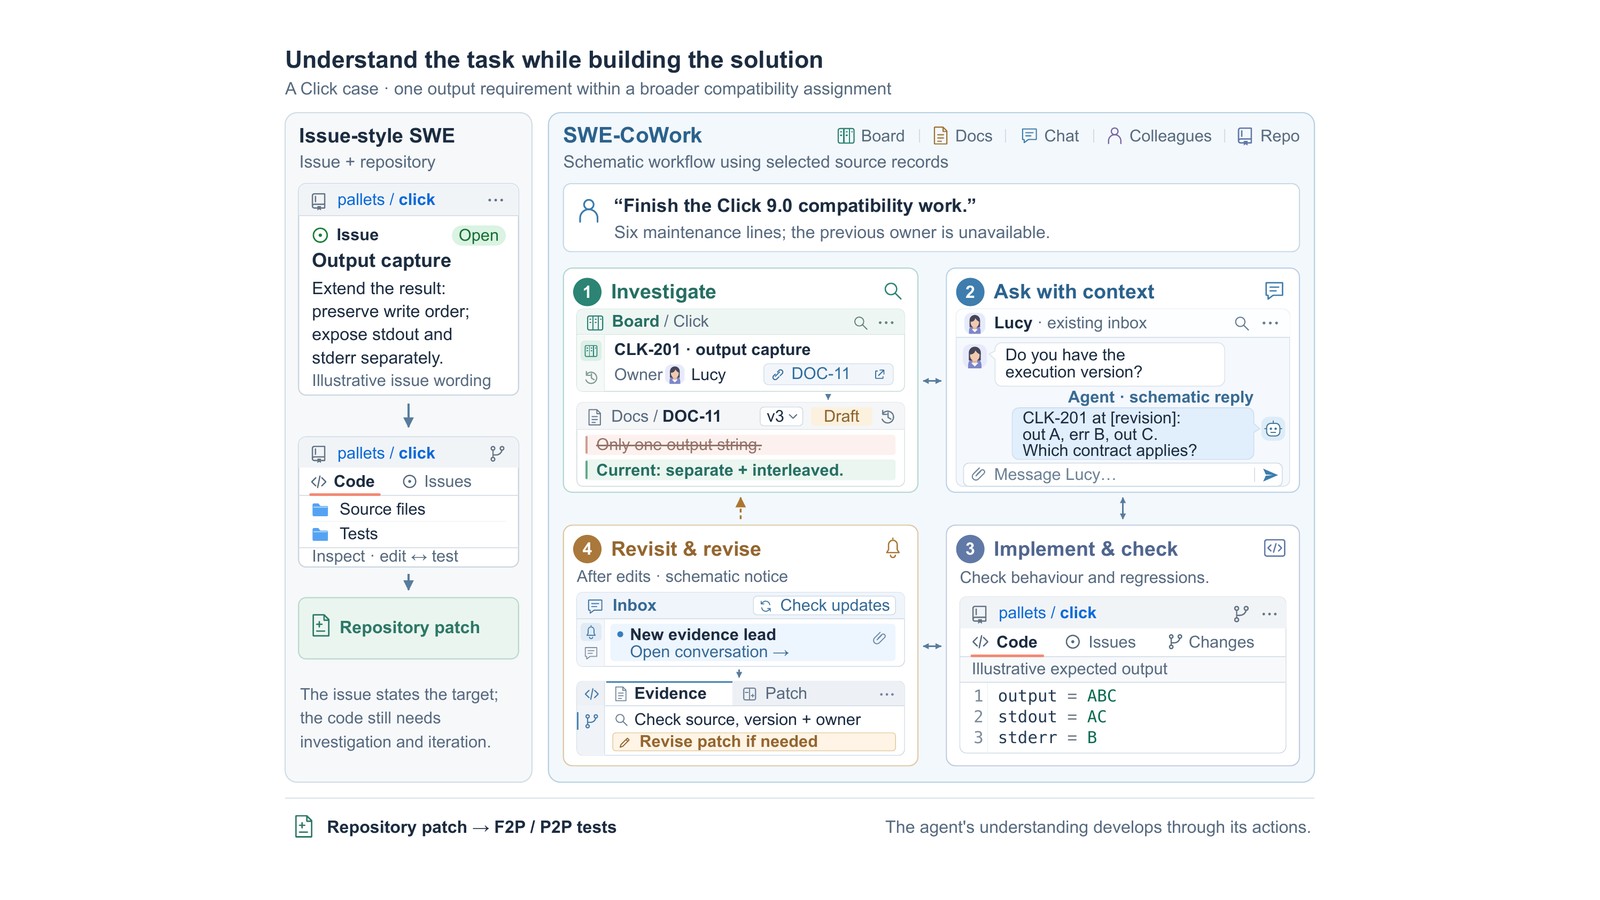
Titre original : SWE-CoWork: Benchmarking Coding Agents as Digital Employees in Organizations
Auteurs : Xinping Lei (auteur principal), Minghao Liu, Ruijie Zhu et Xiaohui Hu (contributeurs principaux) et une vingtaine de contributeurs ; auteurs correspondants Jiaheng Liu, Stephen Huang, Eli Cheung et Weihao Xuan.
Affiliations : TokenWave AI, entreprise basée à Palo Alto (États-Unis). Le papier ne mentionne pas d’autre institution.
Publication : prépublication déposée sur arXiv le 15 novembre 2026 (2611.20218v1, datée du 17 novembre, 31 pages avec annexes). Code, jeu de données et site publiés.
Liens : page arXiv, PDF, site du projet, code, données.
L’idée en bref
Les benchmarks de code habituels donnent à l’agent un ticket déjà bien défini. Dans une vraie équipe, le développeur qui reprend un chantier reçoit une note de passation de quelques lignes ; le reste est éparpillé entre le tableau de projet, des documents parfois périmés, des discussions, des revues de code et des collègues qui savent chacun une partie des choses. SWE-CoWork mesure si un agent de code sait travailler dans ce contexte : retrouver ce qu’il faut faire, demander à la bonne personne, réconcilier des informations contradictoires, livrer, puis rendre compte honnêtement.
Ce que montre le papier
Une entreprise simulée autour de chaque dépôt
Le banc compte 101 missions sur 101 dépôts open source réels, en 11 langages et 12 domaines (web, compilateurs, jeux, paiement, logiciel scientifique). Chaque mission place l’agent dans une organisation de 26 collègues simulés, soit 2 626 profils au total, chacun avec un rôle, des responsabilités et une connaissance limitée. Un collègue peut demander une reproduction du bug, renvoyer vers quelqu’un d’autre ou différer sa réponse ; il ne livre une exigence que si la question apporte assez de contexte. Les réponses sont générées par GPT-5.6 Terra, mais l’environnement contrôle ce qui peut être dévoilé à chaque étape. Au total, ces organisations contiennent 10 329 cartes de projet, 5 097 documents versionnés, 40 836 messages, 1 194 demandes de fusion.
Les missions sont lourdes : la solution de référence médiane ajoute 2 955 lignes de code de production sur 60 fichiers. La note de départ fait 206 mots en médiane, contre 5 453 pour la documentation de la mission. La mission est jugée sur 2 699 tests à faire passer (F2P) et 562 tests de non-régression (P2P), privés, avec un budget de 8 heures par mission.
Beaucoup de travail partiel, très peu de missions finies
Onze modèles sont évalués. Claude Opus 5.5 satisfait 63,84 % des tests F2P et GPT-6 Astra 62,91 %, mais ils ne réussissent entièrement que 6,93 % et 7,92 % des missions (7 et 8 sur 101). Les neuf autres, dont Seed Evolving, Qwen3.8-Max, GLM 5.3, Kimi K3 et DeepSeek V4 Pro, plafonnent à 39,09 % des tests et 0,99 % de missions réussies. DeepSeek V4 Pro n’envoie aucun message à ses collègues en médiane et n’obtient que 1,8 % des exigences qu’ils détiennent.
Ce qui sépare les modèles, c’est la collecte des exigences : la part obtenue auprès des collègues suit de très près le score (corrélation de rang de 0,94), alors que le nombre d’appels d’outils n’y est presque pas lié (0,08). Certains modèles épuisent leurs 8 heures en centaines ou milliers d’appels sans obtenir plus d’informations.
Même avec toutes les exigences en main
Dans une variante où toutes les exigences sont fournies d’emblée, sans collègues à interroger, le score F2P gagne environ 16 points : de 39,09 à 55,76 % pour Seed Evolving, de 62,91 à 78,84 % pour GPT-6 Astra. Le taux de missions entièrement réussies, lui, ne bouge pas (0,99 et 7,92 %). Une bonne partie des échecs se produit donc pendant l’implémentation et la vérification, pas pendant la collecte.
Où Claude Opus 5.5 perd le fil
L’analyse des 101 trajectoires d’Opus suit chaque exigence jusqu’au test. Le modèle adresse sa première question au bon responsable dans 93 % des cas en moyenne, mais n’obtient que 64 % des 2 176 exigences détenues par les collègues. Les manques viennent surtout de sujets non abordés avec des collègues déjà contactés (17 %) ou de questions sans réponse finale (16 %), rarement d’un collègue jamais contacté (3 %). Sur 450 échanges où un collègue a différé sa réponse, 153 ne sont jamais relancés, alors qu’il reste en médiane 7,1 heures de budget. Parmi les tests échoués liés à une exigence, 56 % portent sur une exigence que l’agent avait bien reçue. Et au moment de rendre la main, 255 des 826 exigences déclarées terminées (31 %) échouent à leurs tests.
Les limites
Le papier ne comporte pas de section dédiée aux limites. Les auteurs précisent que les corrélations entre comportements et scores ne prouvent pas de causalité, que l’analyse des comportements d’Opus repose en partie sur un relecteur LLM guidé par une grille, et que la piste qu’ils proposent (suivre explicitement chaque exigence de la question jusqu’à la passation) reste à tester.
Nos réserves : les collègues sont simulés par un modèle d’OpenAI (GPT-5.6 Terra), alors qu’un modèle d’OpenAI figure parmi les meilleurs évalués ; GPT-6 Astra tourne dans l’environnement Codex quand les dix autres utilisent Claude Code, ce qui mélange l’effet du modèle et celui de l’outil. Le papier ne fait pas état de répétitions des runs, et la variante « exigences fournies » ne concerne que deux modèles. Enfin, le benchmark vient d’une jeune entreprise qui en fait aussi sa vitrine.
Lecture Neurone21
Pour une entreprise qui veut confier une partie de son développement à des agents, SWE-CoWork décrit bien le vrai risque : pas tant un code faux qu’un compte rendu trop optimiste. Un agent qui déclare « fait » sur une exigence sur trois qui échoue en test oblige à garder une vérification humaine ou automatisée indépendante de son propre rapport. Deux pratiques en découlent. Mieux vaut fournir aux agents des passations et des tickets aussi complets que possible, puisque la collecte d’information reste leur point faible. Et il faut exiger un suivi explicite exigence par exigence (qui l’a donnée, où elle est codée, quel test la vérifie) plutôt qu’un résumé global en fin de mission.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.20218v1. Points à préciser :
Les chiffres 101 missions sur 101 dépôts réels, 26 collègues simulés, 11 langages, 12 domaines, sont ceux du papier. En revanche, les « 17 outils de travail » parfois annoncés ne figurent ni dans le papier ni sur le site du projet, qui décrivent l’interface d’outils sans les compter. Le meilleur modèle termine 8 missions sur 101 (GPT-6 Astra, alors que Claude Opus 5.5 obtient le meilleur score F2P), et la « majorité des tests échoués après que l’agent a reçu l’exigence » correspond aux 56 % des tests échoués liés à une exigence. Parler de tests « cachés » est imprécis : le papier dit privés, c’est-à-dire non montrés à l’agent.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.20218
- Le PDF : https://arxiv.org/pdf/2611.20218
- Le site du projet et son classement : https://tokenwave-ai.github.io/swe-cowork-page/
- Le code : https://github.com/TokenWave-AI/swe-cowork-bench
- Les données : https://huggingface.co/datasets/Tokenwave-AI/swe-cowork
- Notre fiche sur Terminal-Bench 2.0, un banc d’agents sur des tâches déjà bien définies : /p/terminal-bench-2-agents-terminal-89-taches
- Notre fiche sur Claw-Eval, qui évalue aussi les trajectoires des agents et pas seulement le résultat : /p/claw-eval-trajectoires-agents-securite